7.3 离散型随机变量的数字特征
人教 A 版 · 本节 5 页原书扫描(原文)+ 本站重写的讲解与习题详解考过 17 题 ↓
原书扫描页(人教 A 版原文)
本节的知识树
2 概念 · 1 公式 · 最深 3 层。根是引本节作教材出处的实体,长链由 `prereqs` 构建期派生——源里只有最小一步。
考过本节的真题
共 17 道
- 浙江 2008 · q19三色球:白球几个、、与「至少一黑」的上界 · 「至少一个」永远先翻成「一个都没有」经由 数学期望、期望的线性性质
- 浙江 2009 · q19 取三数 · 分堆硬数 / 好数的先数期望用指示变量 / 间隔换元一次数清经由 数学期望、期望的线性性质
- 浙江 2010 · q19官方解析没写的那一步——三个出口的概率是从管道图上一层层灌出来的经由 数学期望
- 浙江 2011 · q15一个概率定出 ,然后期望有三种算法——最快的那种连分布列都不用写经由 数学期望、期望的线性性质
- 浙江 2012 · q19每个球都有 分底薪——,而 是标准超几何分布;期望只需「总分 抽取比例」经由 数学期望、期望的线性性质
- 浙江 2013 · q19第(2)问的答案 ,正是第(1)问那只袋子 —— 换成概率设元,分母当场消失经由 数学期望、期望的线性性质
- 浙江 2014 · q09个数在涨、占比在跌 · 与 经由 数学期望、期望的线性性质
- 浙江 2014 · q12三个取值两个方程 · 期望落在正中间,方差就是两端概率之和经由 数学期望
- 浙江 2017 · q08两点分布比期望与方差 · 代定义算出 E 与 D 再作差定号,或把两者都看成 p 的函数读单调性经由 数学期望
- 浙江 2018 · q07质量从 0 滑到 2 · 把 配成开口向下的二次函数经由 数学期望
- 浙江 2019 · q07三点等概率、中间那个点会动 · 把 D(X) 配成 a 的二次函数,或先用 a↔1−a 的对称性砍掉两个选项经由 数学期望
- 浙江 2020 · q16抽到红球即停的黄球数 · 把不放回抽取看成一个排列,只看红与两黄的相对次序经由 数学期望、期望的线性性质
- 浙江 2021 · q15袋中取两球数红球 · 两个概率定住球数,再列分布列或拆指示变量求期望经由 数学期望、期望的线性性质
- 浙江 2022 · q15抽三张卡看最小数字 · 逐值列分布列,或改数「不小于 k」经由 数学期望
- 浙江 2023 · q21投篮马尔可夫链 · 全概率列 P_{i+1}=0.4P_i+0.2 构等比,指示变量求 E(Y)经由 数学期望、期望的线性性质
- 浙江 2024 · q14甲乙各四张牌逐轮比大小 · 期望可加两步收网,或 24 种配对全数完经由 数学期望、期望的线性性质
- 浙江 2025 · q14有放回取三次出现几个不同球 · 硬算分布列,或拆成 5 个 0-1 变量经由 数学期望、期望的线性性质
讲解
本站对这一节的重写(不是原书转写):顺序可重组、推导可补全,目标是易读易学 + 与真题关联。原文以上方扫描图为准。
分布列已经把一个离散型随机变量的取值规律说尽了——它每一个值、每一个概率都写在那儿。 那为什么还要再学”数字特征”?因为分布列不便于比较。两名射箭运动员各有一张四行的分布列, 摆在一起看不出谁强;把两张表各压缩成一个数,高下立判。这一节学的就是第一个这样的数—— 均值(数学期望)。
本节页面(第 67—71 页)覆盖的是 §7.3.1 均值那一段;方差在下一节 §7.3.2。这一份按 “定义 → 为什么这么定义 → 两条运算性质 → 决策怎么用”的顺序讲,把课本分散在正文、探究与例题里的 四件事串成一条线。
一、均值:加权平均,权是概率
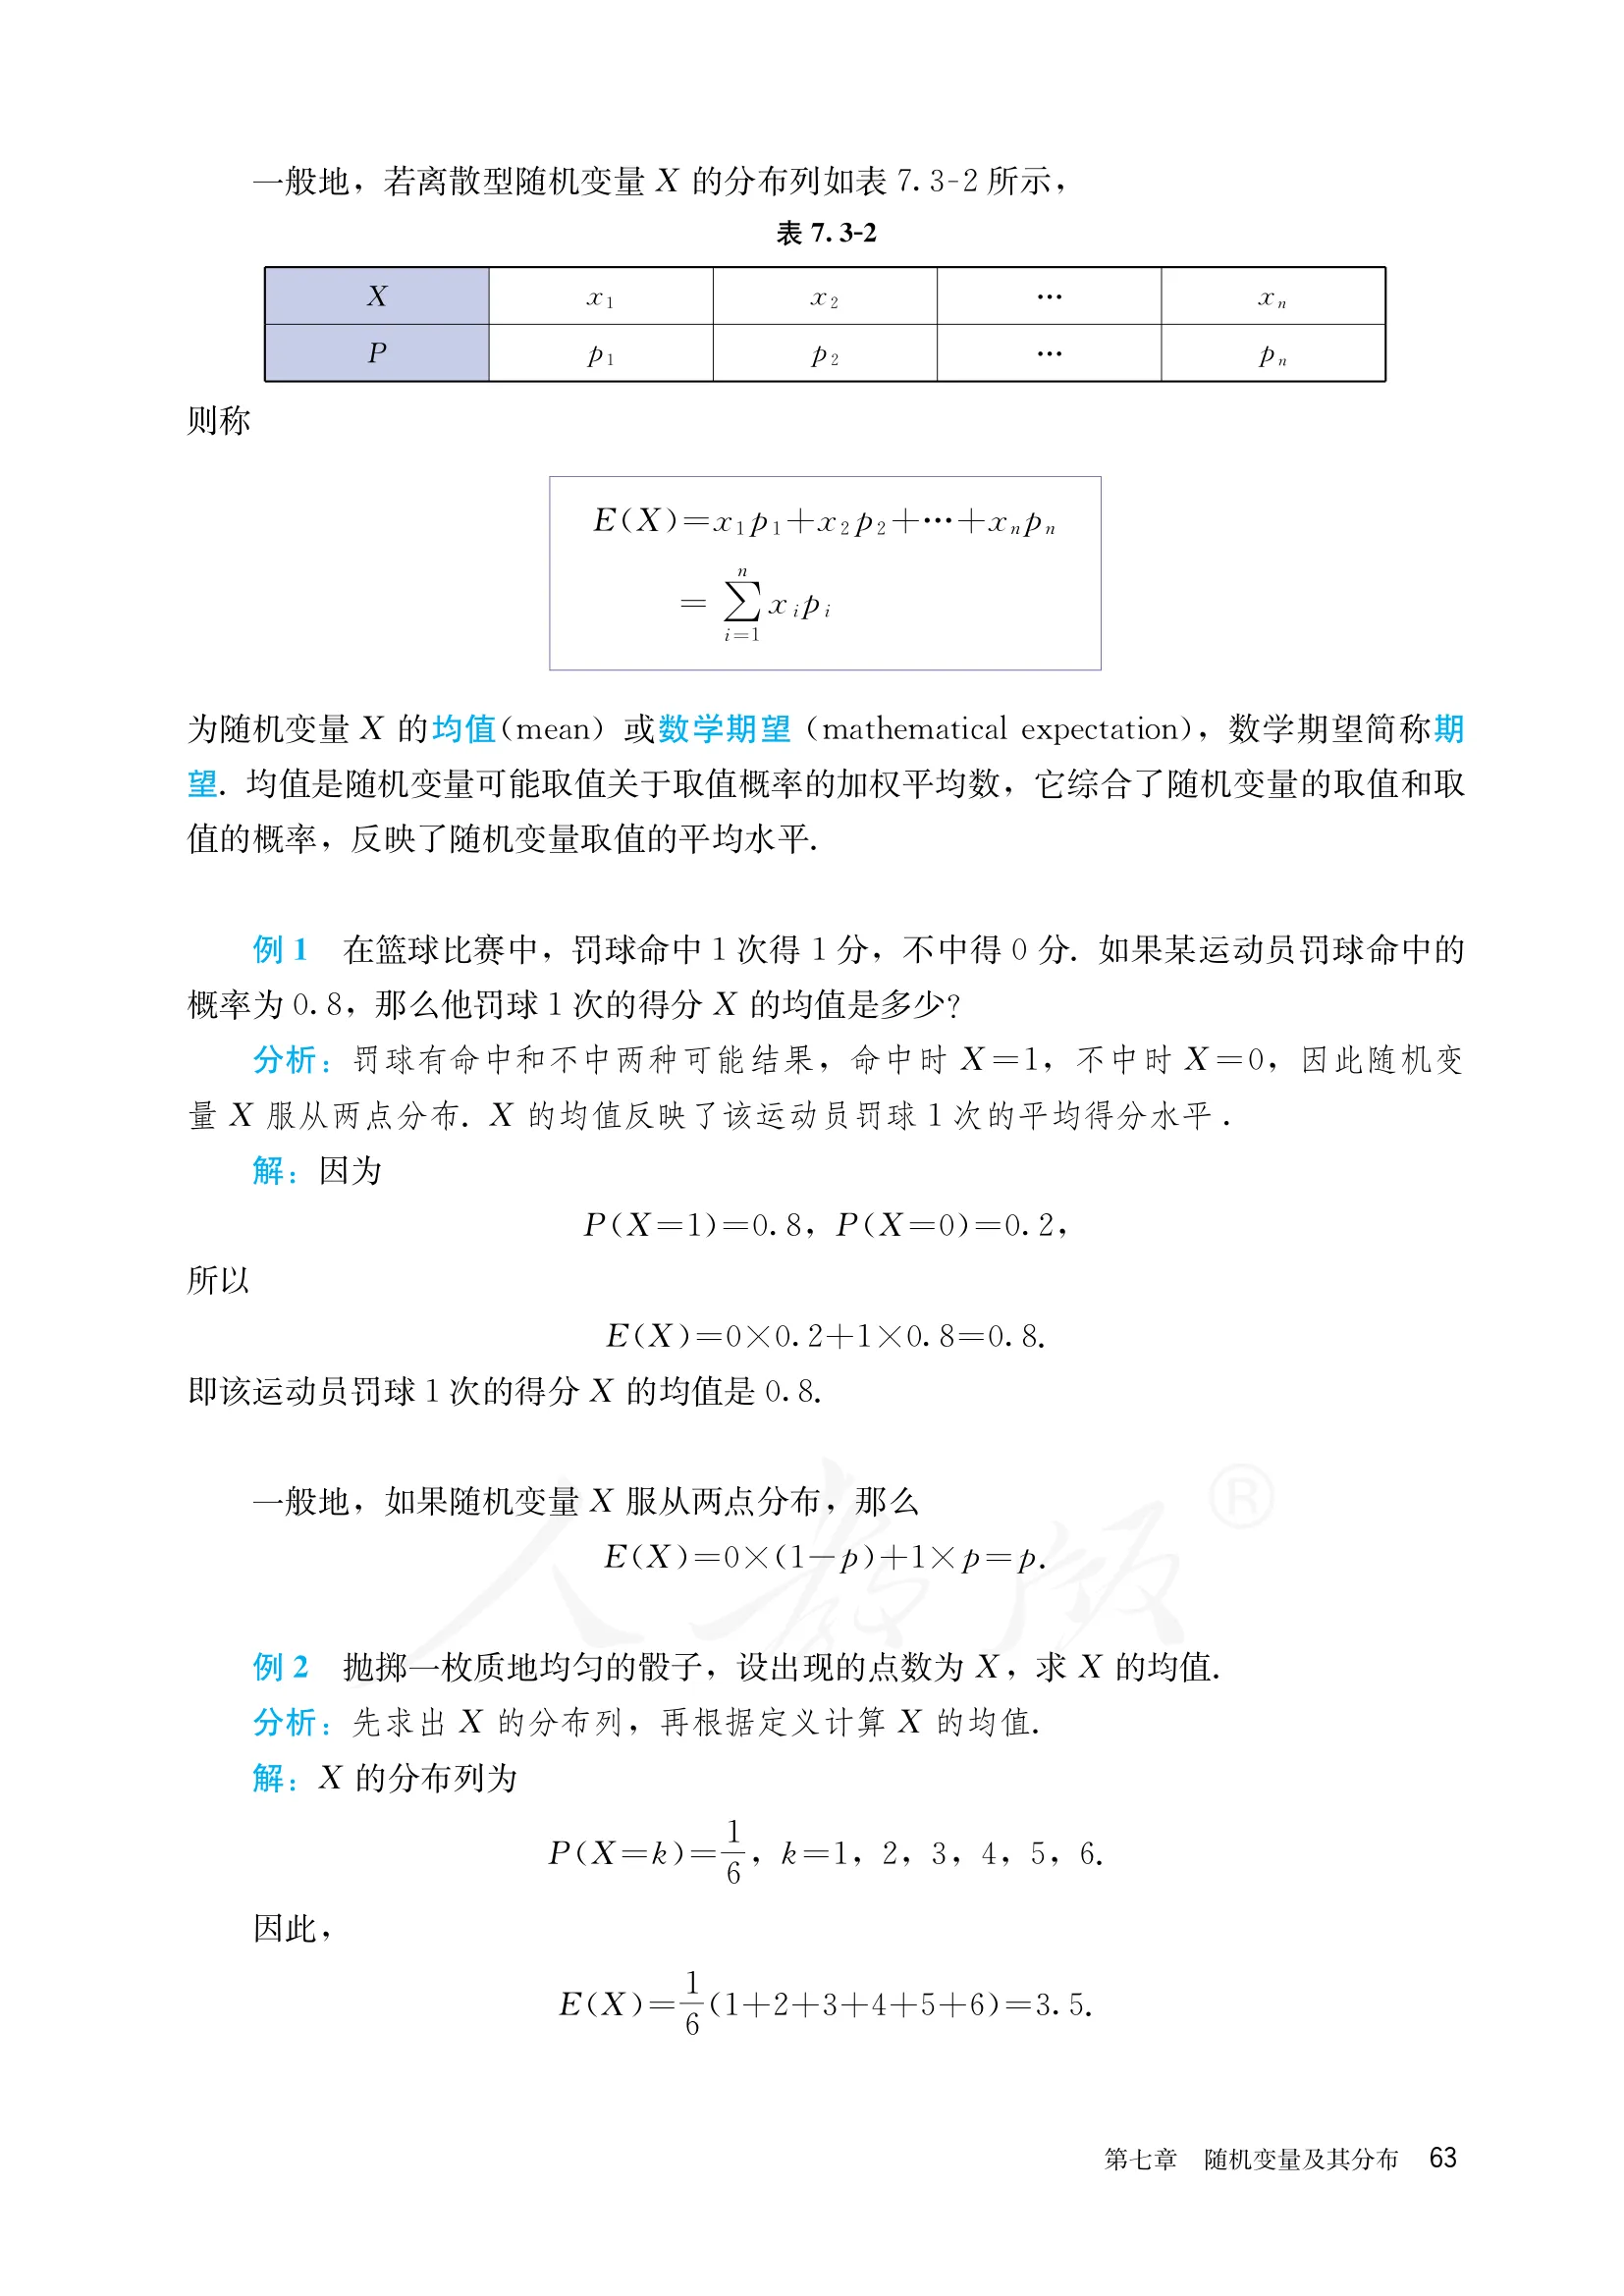
设离散型随机变量 的分布列为 (),称
为 的均值或数学期望,简称期望。
它是 的可能取值关于取值概率的加权平均数——注意与”把 个取值直接平均”的区别: 后者是 ,等于把每个取值都当作同样重要;而 把每个取值按它 出现的概率加权,概率大的拉得更狠。掷骰子时两者恰好都等于 (因为六个概率相同), 这是巧合,别拿它当规律。
这个定义从哪来
课本的射箭例子把来历讲得很清楚,值得复述一遍,因为它解释了”为什么权是概率而不是别的”。
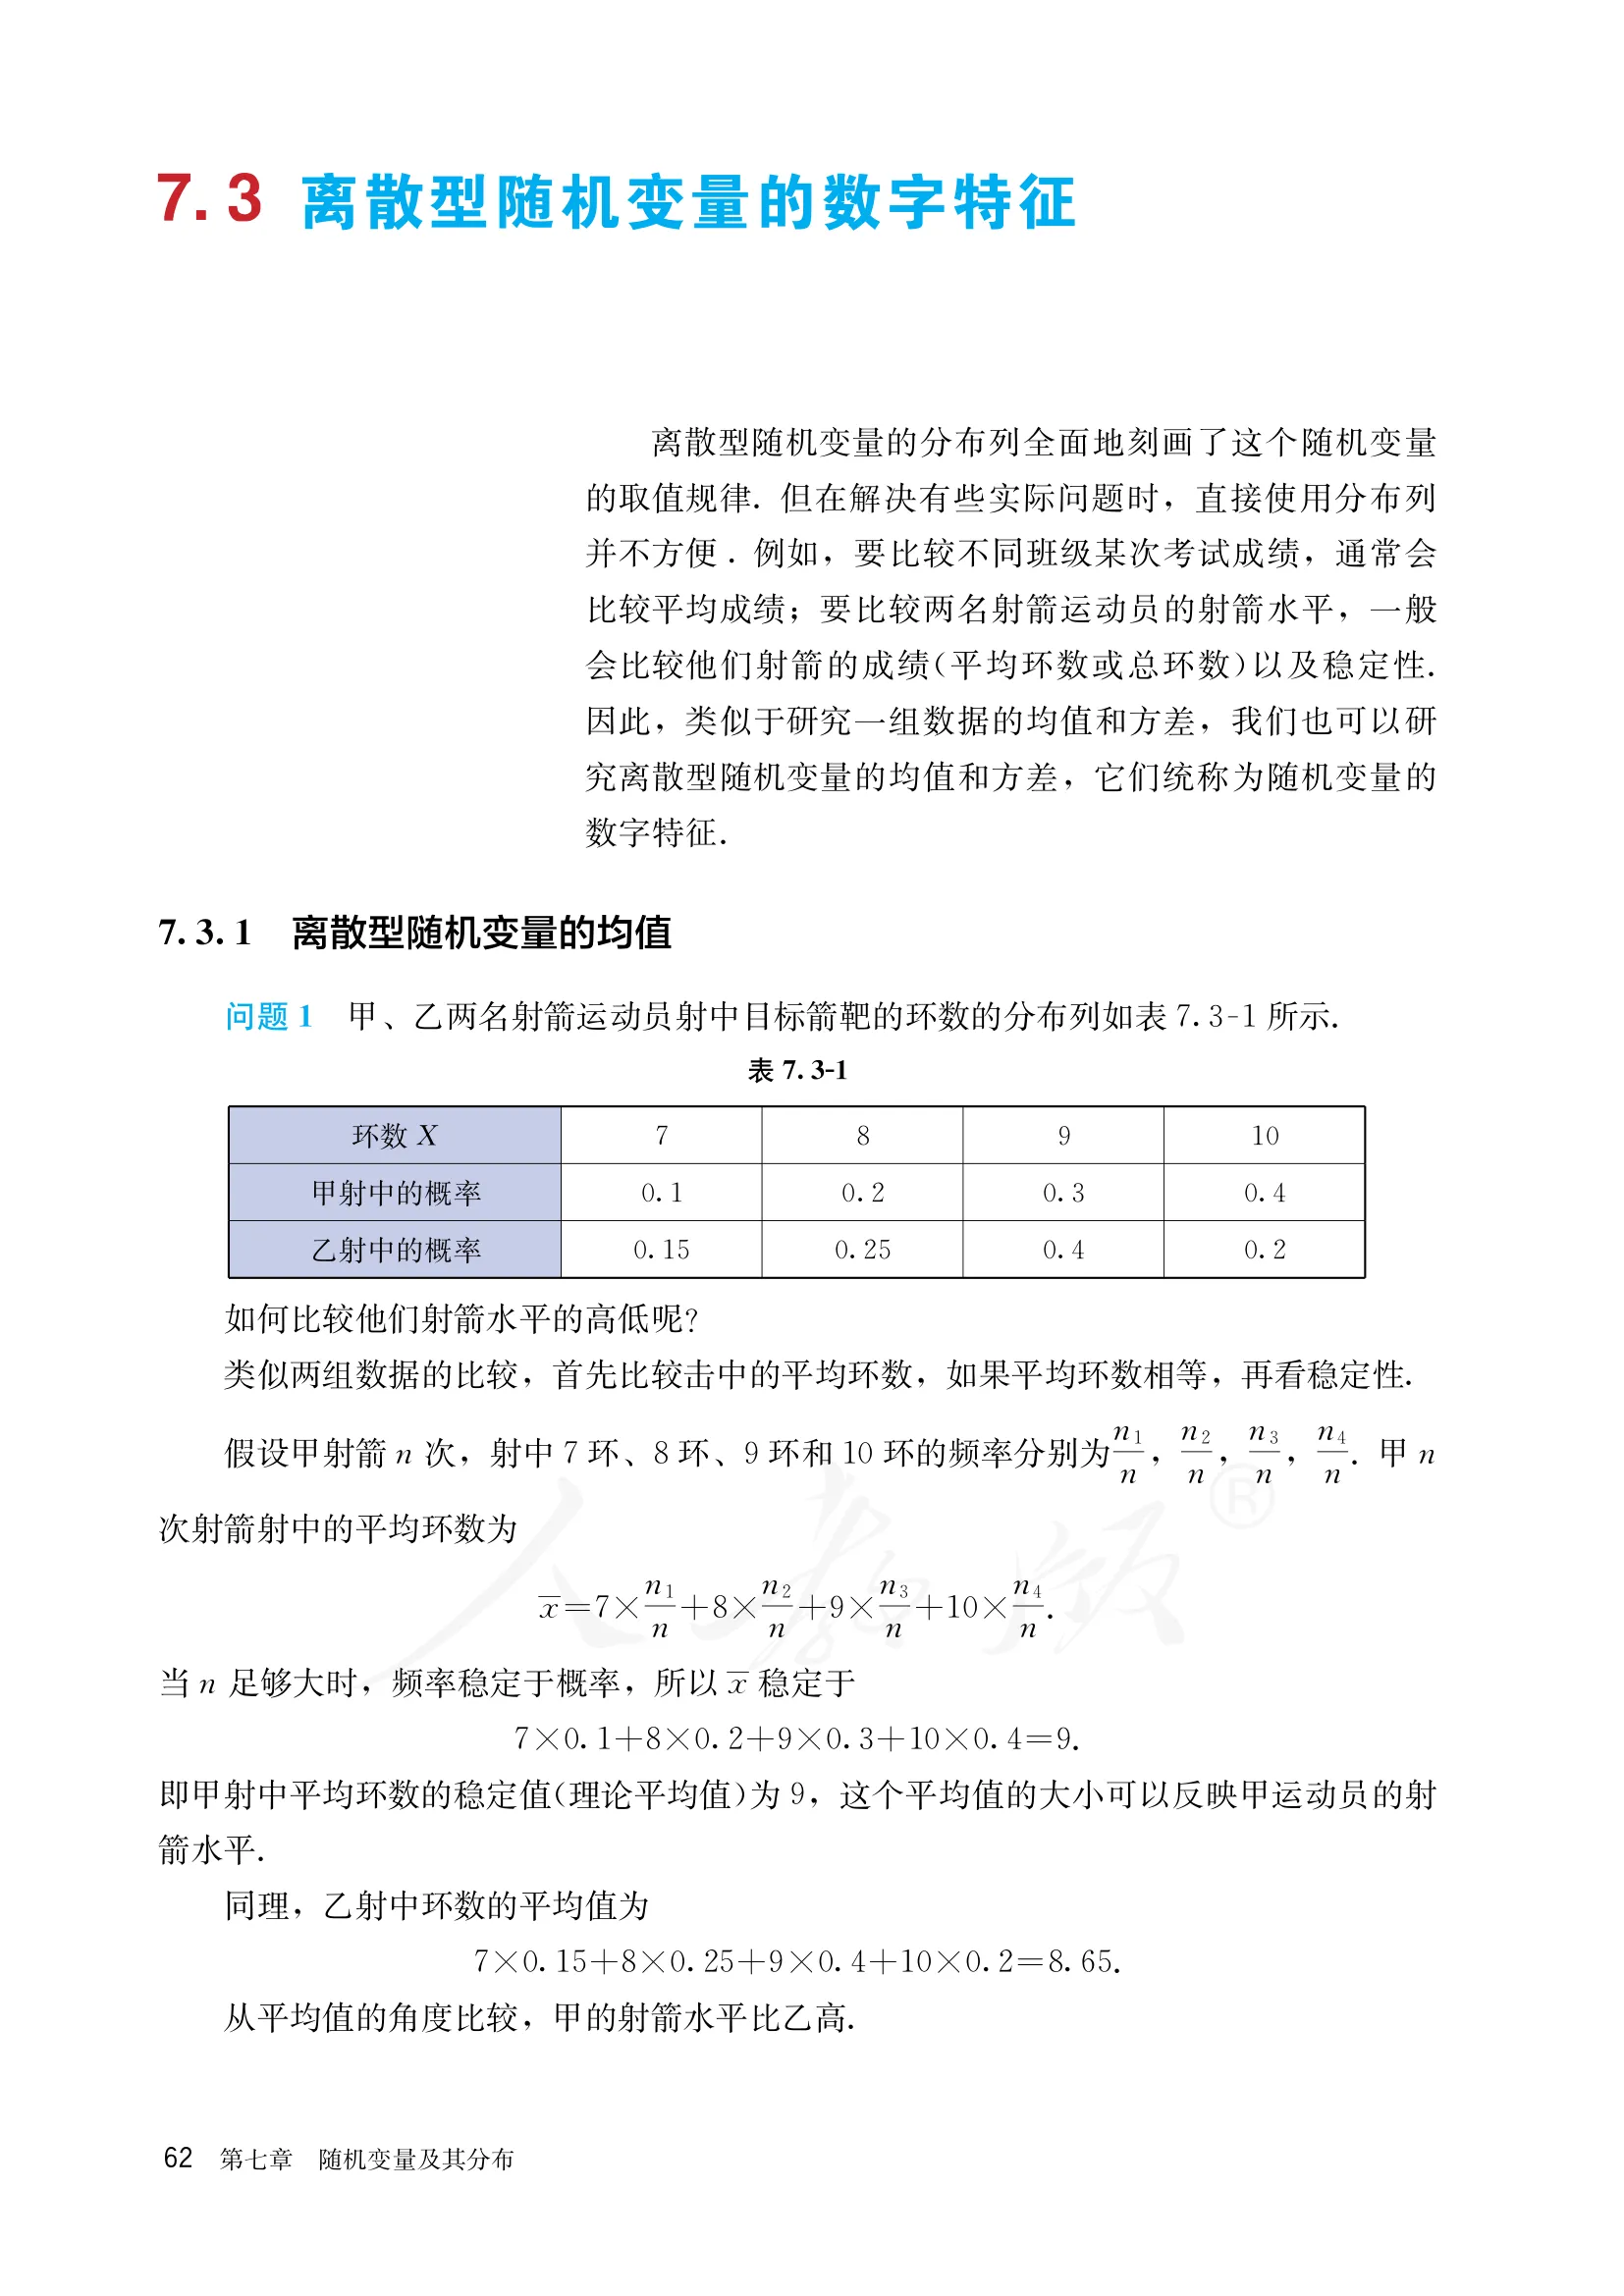
设甲射箭 次,射中 环的次数分别是 。这 次的平均环数 按平均数的定义就是
每个环数前面挂的正是它的频率。当 足够大时频率稳定于概率,于是 稳定于 。
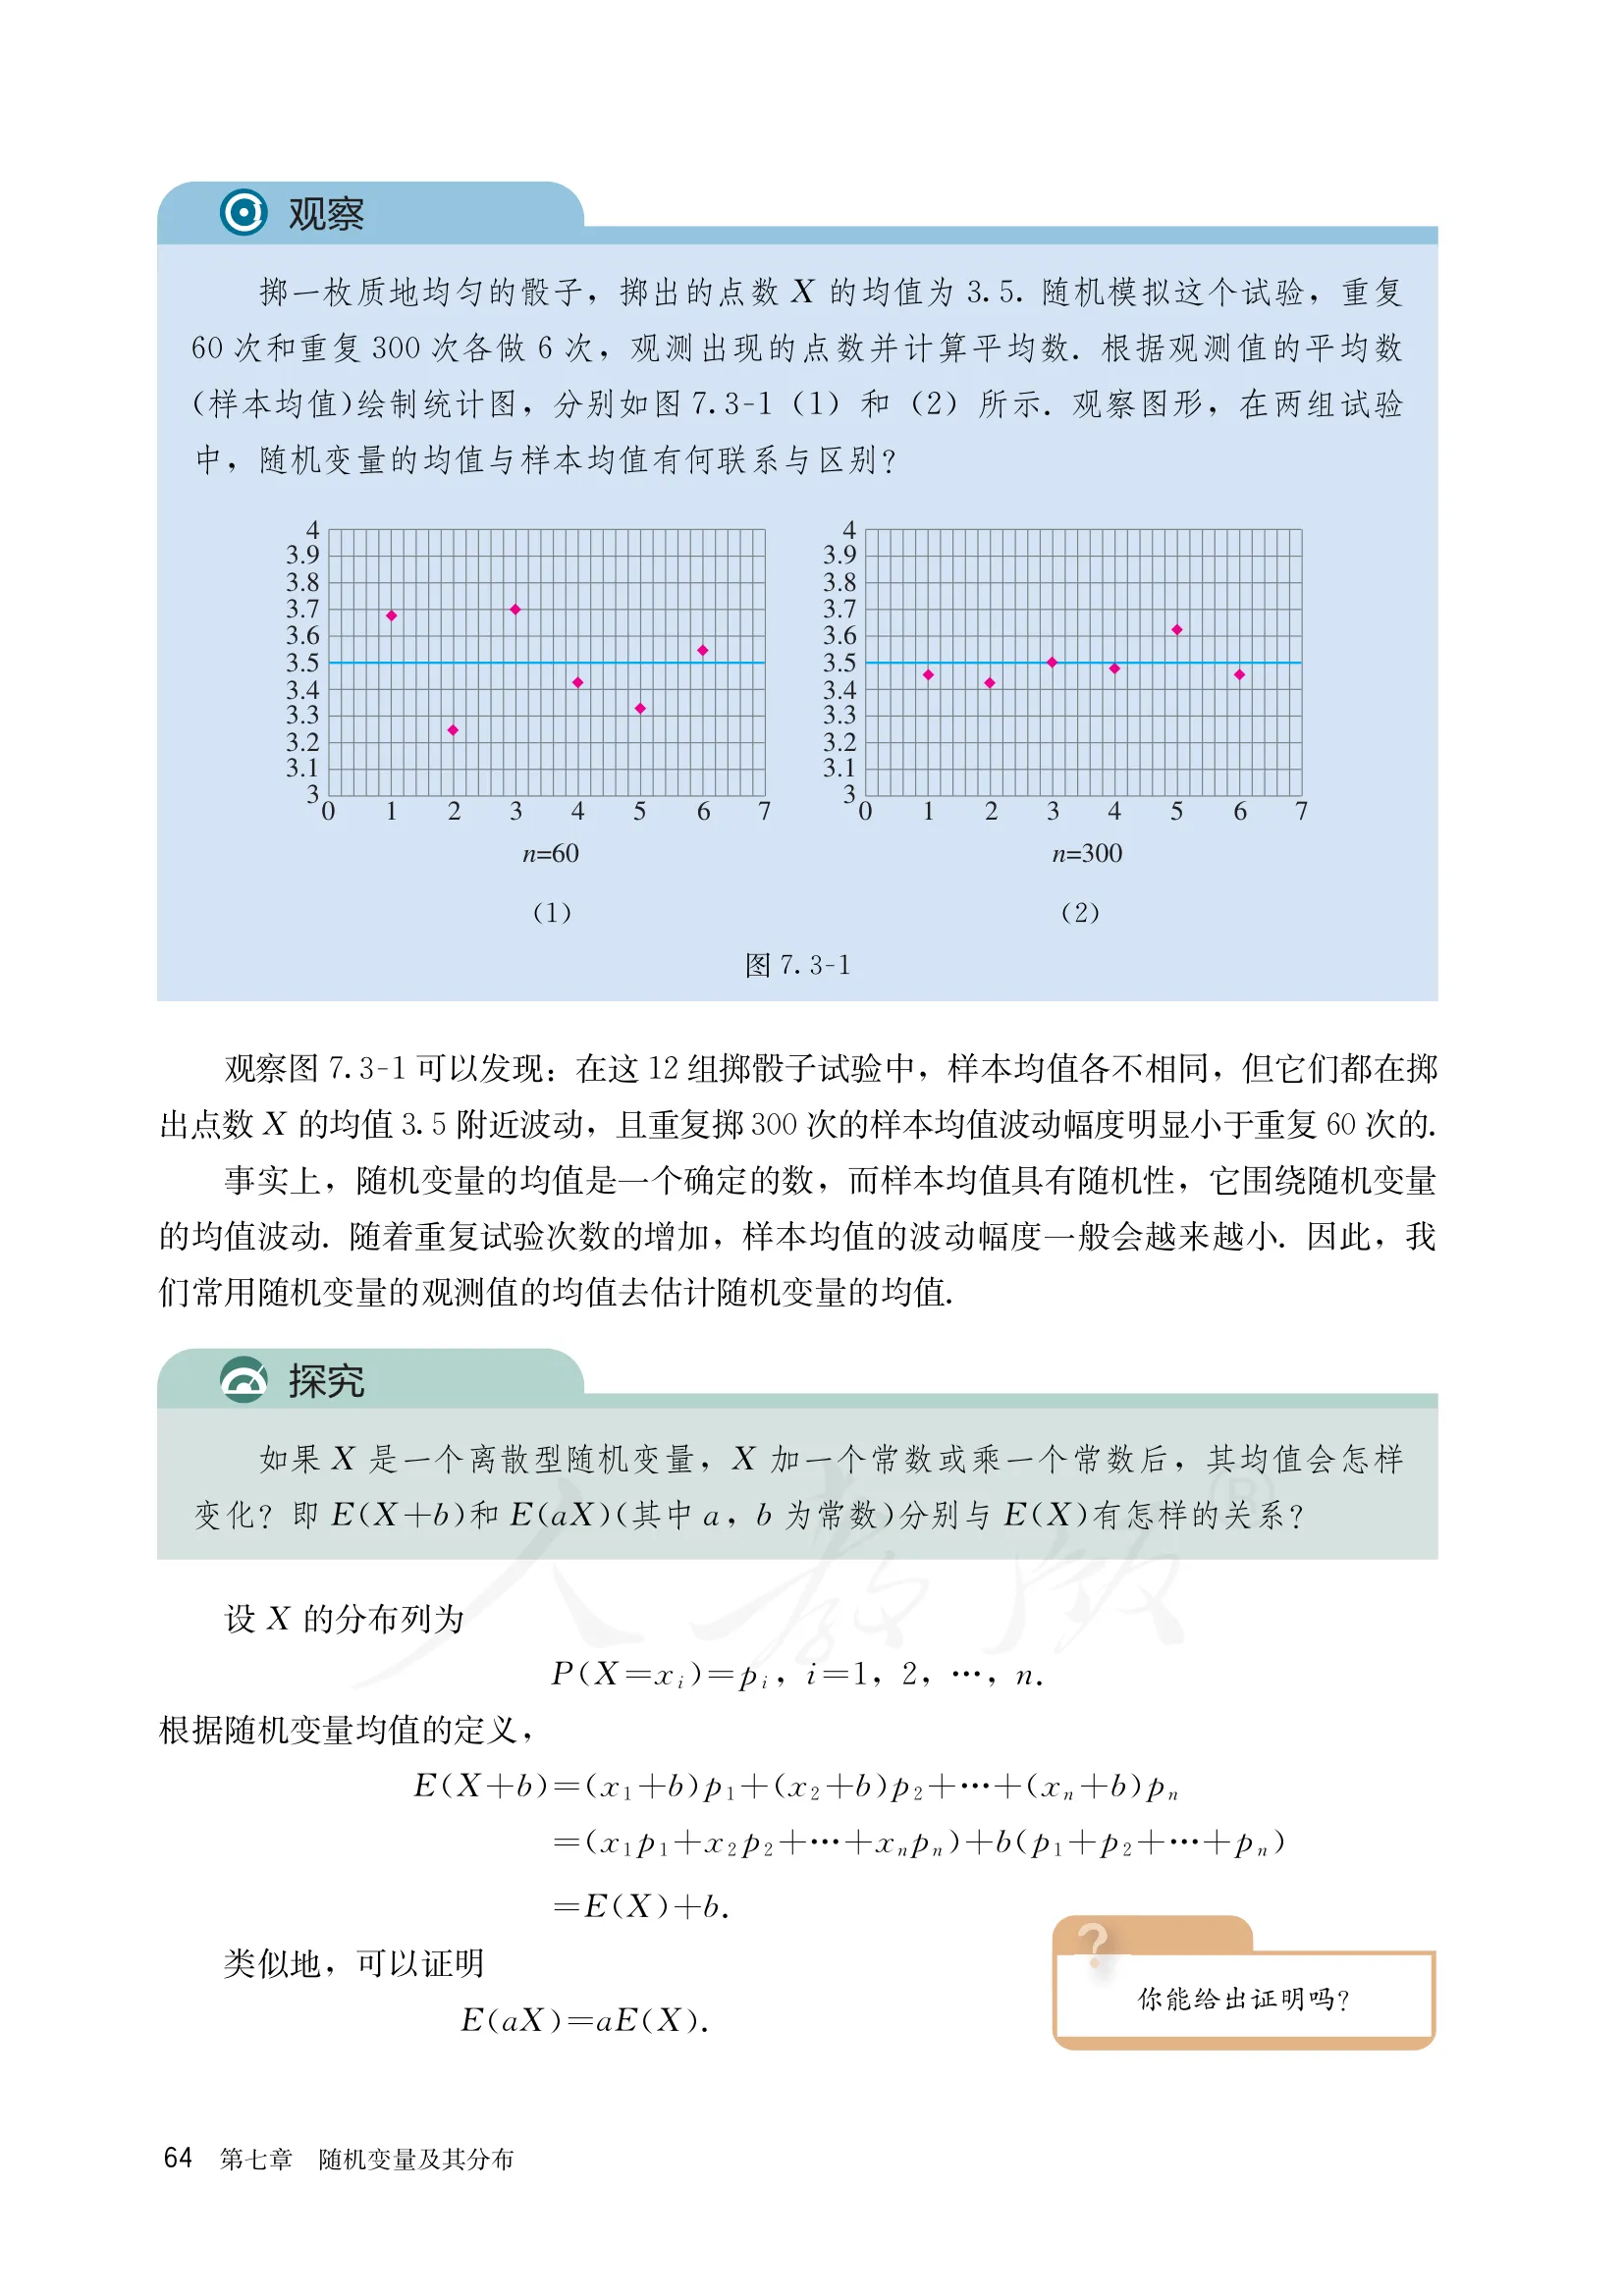
所以 不是凭空规定的记号,它就是”重复很多很多次之后,平均下来会是多少”的那个稳定值。 课本随后那一段”观察”(重复 60 次与 300 次各做 6 组)讲的也是这件事的另一面: 样本均值有随机性、会在 附近波动,重复次数越多波动越小; 本身则是一个确定的数。
这条区别要记牢:样本均值是数据算出来的,随样本变;均值(期望)是分布算出来的,不随样本变。 考试里”用观测值的平均数估计随机变量的均值”这句话,用的就是前者估计后者。
另一个物理读法:均值是这根杆的平衡点
把数轴想成一根没有重量的杆,在位置 处挂一个重量为 的砝码(总重 )。 问这根杆支在哪儿才平?答案就是 。
验一遍:以 为支点时,各砝码的力矩(有向力臂 重量)之和是
取 ,右边正好为零——力矩平衡的那一点就是均值。反过来, 支点每往左挪一格,总力矩就多出一格的正值,杆立刻往右倒;所以平衡点只有一个。
这不是换个说法玩花样,它给了均值一条反着用的读法。上面那一行同时说明: 是一个关于诸 的线性方程。 于是题目每告诉你一个 ,你就白得一个方程;而”平衡”这个形象能让你一眼看出这个方程长什么样, 不必真去展开求和。
最常用的特例只有一句话:取值是 而 。 支点落在正中央,两端到支点的力臂都是 、方向相反,要平衡就只能等重; 中间那个 挂在支点上、力臂为零,根本不参与这个方程—— 所以它是被”概率和为 “定住的,不是被期望定住的。这两句话分工清楚, 是这类题里最容易搞混的一处(2014 年浙江卷第 12 题考的就是它,见下面第七段)。
一般地也是同一句:关于 左右对称的两个取值,必须等概;不对称时则是 “左边的矩等于右边的矩”,离得远的那一端要配更小的概率。
二、两个必须会背的现成结果
两点分布。 若 只取 、,且 ,则
一句话:两点分布的期望就是成功概率。罚球命中率 、命中得 1 分不中得 0 分,那么罚 1 次的 期望得分就是 ,不用列式。这条看着平凡,却是后面所有”计数型”期望题的原子(见第四段)。
均匀取值。 若 等可能地取 ,则
掷骰子是 的特例,。注意 不是骰子的可能取值—— 期望不必是随机变量取得到的数,它是一个平均水平,不是某次结果。
三、线性性质:
课本用”探究”的形式让读者自己推,这里把两步都写出来。设 。
平移。
最后一步用掉了分布列的性质 ——这一步是整条性质的支点, 没有”概率和为 1”就没有这条公式。
伸缩。 同样地,
合起来就是
用处:题目里换单位、换计分方式(“每题 5 分”、“减去成本”)时,不必重新列分布列, 在原来的期望上乘一下加一下就行。
一条本册没有给、但高考在用的性质。 “和的期望等于期望的和”(, 不要求 、 独立)在人教 A 版这一册的正文里没有出现。2023 年新课标Ⅰ卷第 21 题要用它, 于是那道题在题面里把它当作已知条件给了出来(“已知:若随机变量 服从两点分布……则 ”)。这是可核的事实,不是猜测—— 所以别把它当成课本结论去默认引用,但要认得它、会用它。
四、求期望的两条路:列分布列,还是拆成 0-1 变量
这是本节在高考里真正的分水岭。
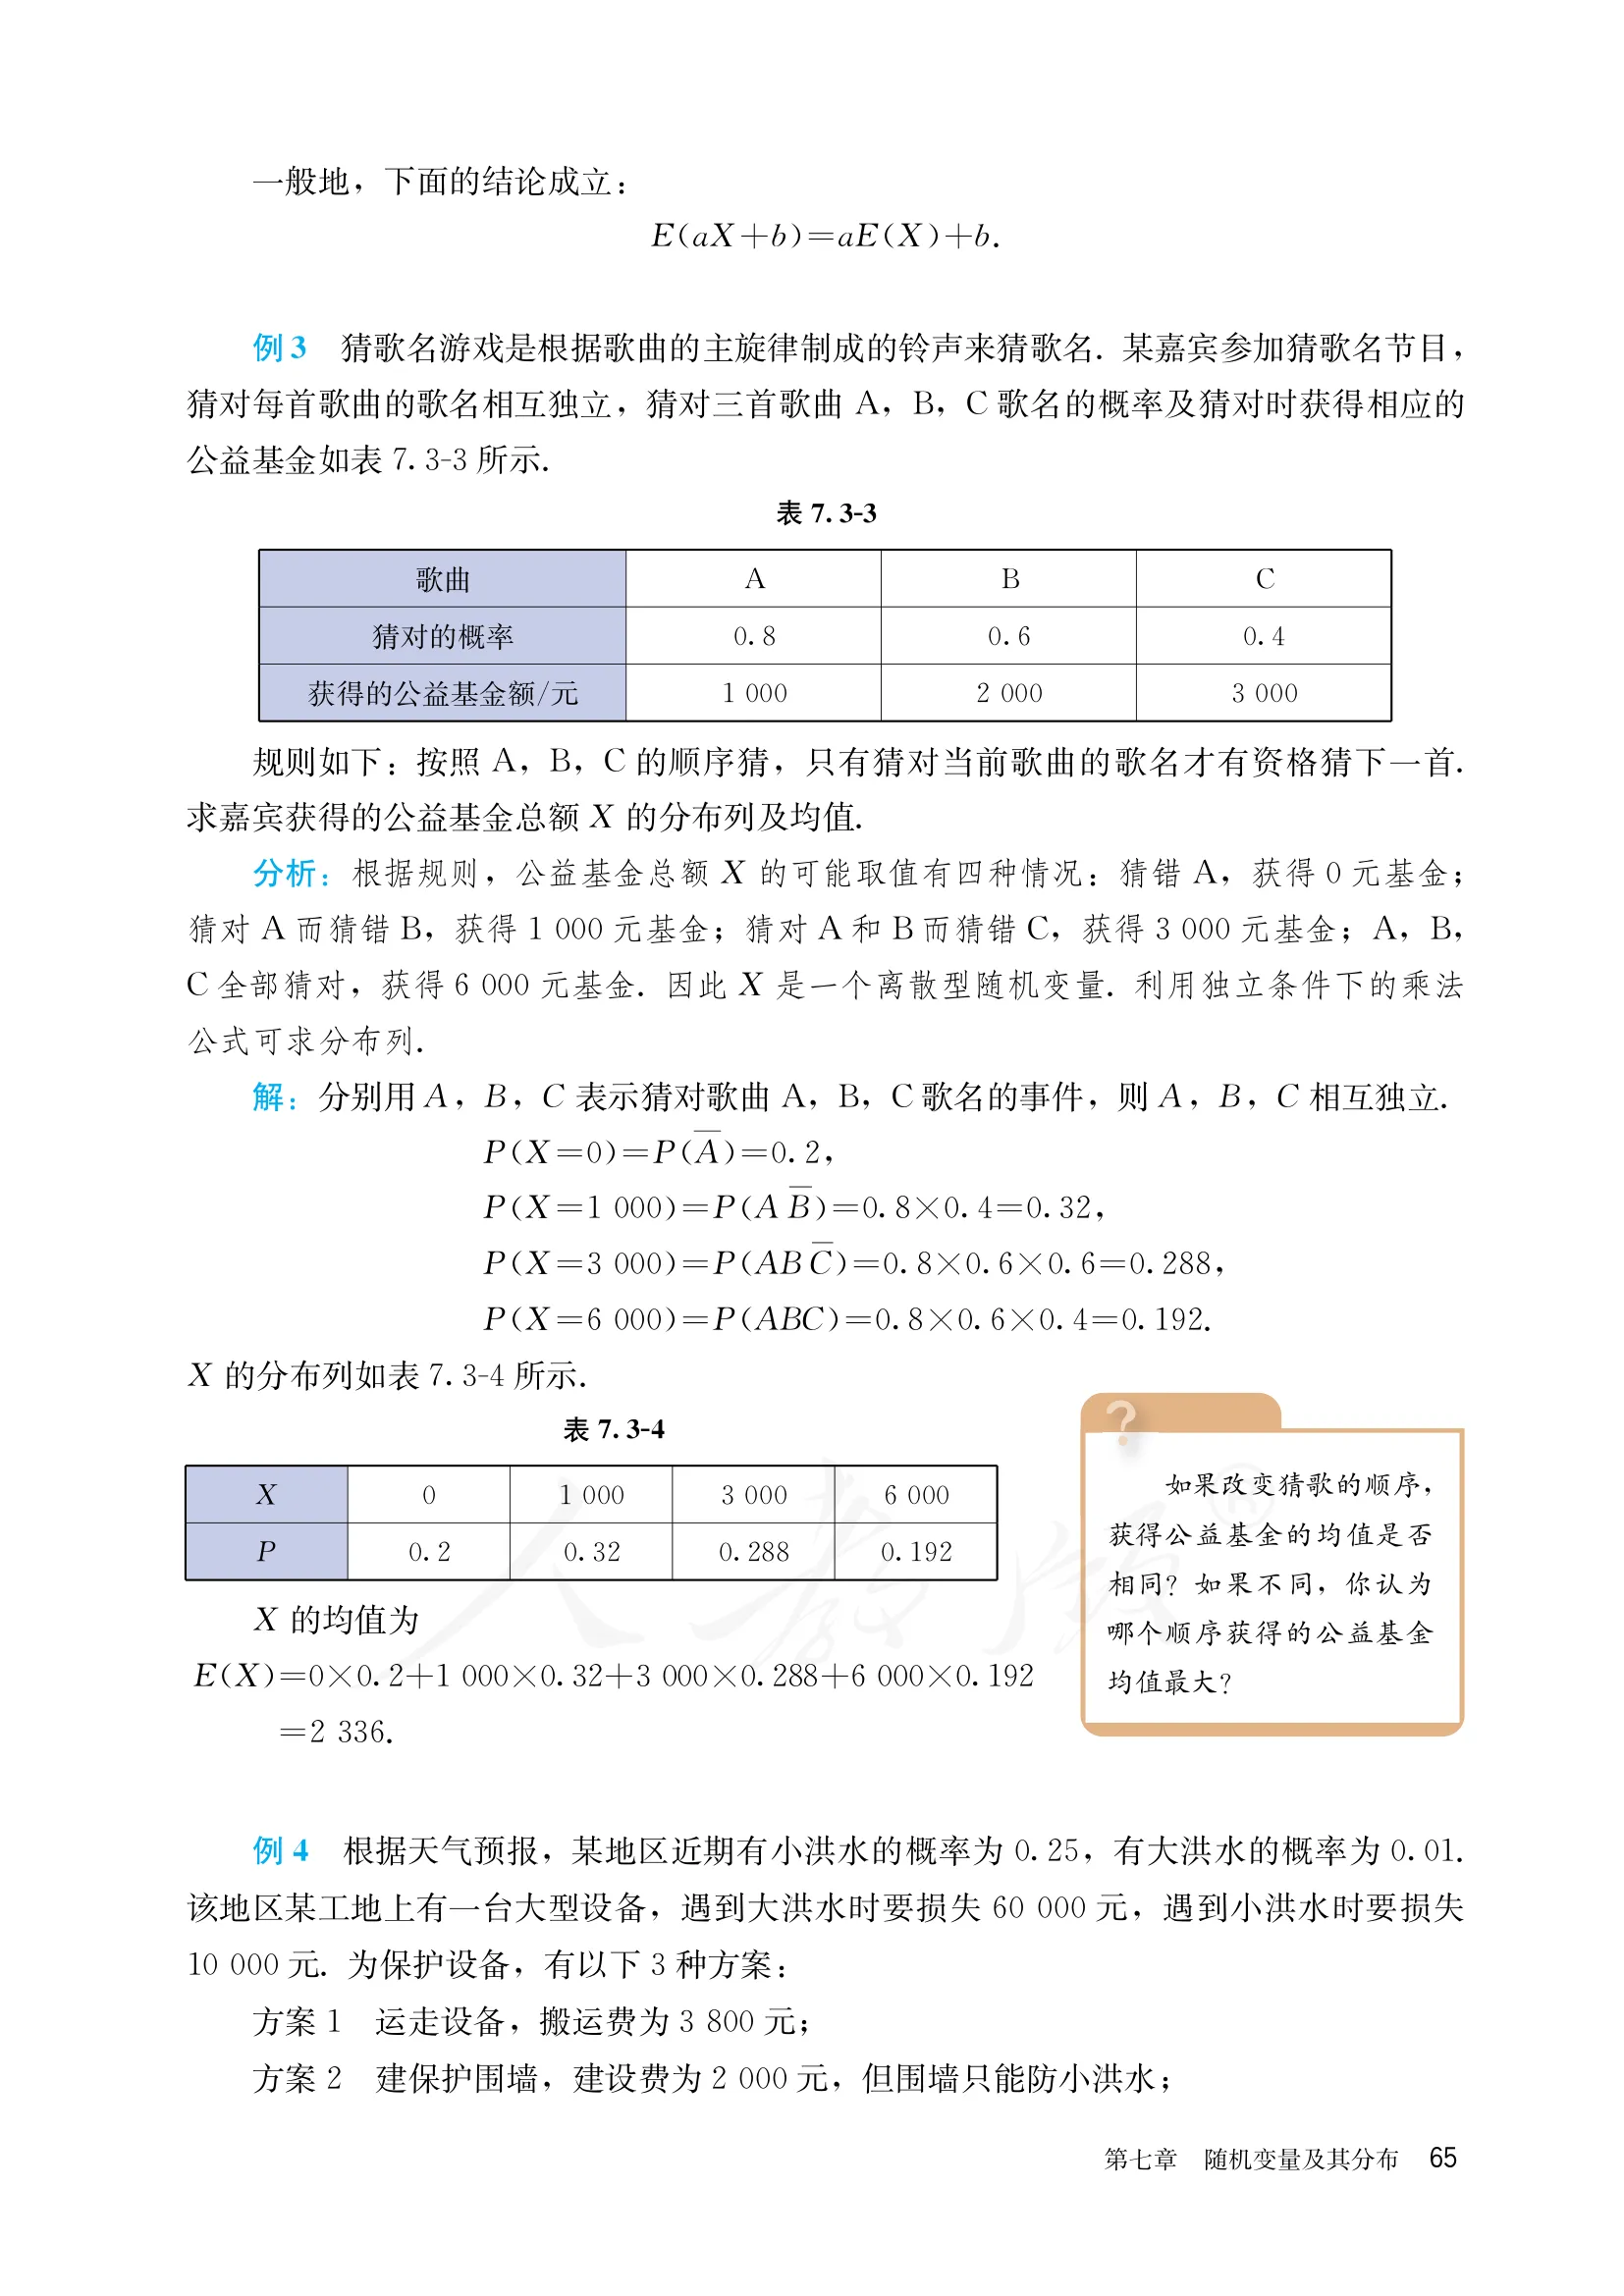
路一:老老实实列分布列。 适用于 的取值只有三四个、每个概率都算得动的情形。 课本例 3(猜歌名,按 A、B、C 顺序猜,猜对才有资格猜下一首)就是这条路:
列完分布列先核一遍概率之和是不是 1(这里 ),这是最便宜的自查, 漏掉一种情形当场就会露馅。
路二:把 拆成一串 0-1 变量。 当 是”某件事发生了多少次”时,令
那么每个 都服从两点分布、,于是 。
这条路的威力在于:它绕开了分布列。当 的分布列有十几项、或者各次之间并不独立时, 路一走不动,路二照样一行算完——因为求和的期望不要求独立。近四年的浙江卷(新课标Ⅰ)里, 2023 年第 21 题、2024 年第 14 题、2025 年第 14 题三道都能走路二,其中 2024 年那道 (甲乙各四张牌打四轮、求总分不小于 2 的概率)几乎必须走路二才算得动 。
判据很简单:问的是”次数""个数""总分”,且它是若干件事各贡献 0 或 1 累加起来的,就拆。
“不要求独立”这四个字要往深里读一格。 最容易被漏掉的场景是不放回抽样:从 个红球、 个蓝球里不放回地抓 个,抓到的红球数 的分布列是超几何的,写起来一长串; 但每一个被抓出来的球,它是红球的概率都是 ——这就是抽签的公平性 (第 2 个抓出的球是红球的概率与第 1 个一样,谁先抓不影响)。于是
一行完事,完全不用碰 。不放回让这 个 0-1 变量互相不独立, 可期望的可加性从来没要求过独立,所以路二照走不误。“不独立”只挡方差,不挡期望。
2014 年浙江卷(理)第 9 题就是这个形态:甲盒原有 1 个红球,从乙盒不放回地抓 个放进去, 甲盒里的红球数 ,于是
原卷解析走的是路一(把超几何的三项概率全列出来再加权,分子化简成 ),足足占了半页;路二一行就到位,且形式更好读—— 每加一个球,红球的期望就多 个。
五、期望用来做决策:比较的是”长期平均”,不是”这一次”
课本例 4(洪水与设备)是本节唯一一道决策题,它的教学价值在结尾那一段话,而不在算式。
三个方案的总损失 各有自己的分布列,算得
于是按”期望总损失最小”应选方案 2(建保护围墙)。
但课本紧接着提醒:这个结论只在”同样的天气状况多次发生”的意义下成立。洪水发不发生是随机的, 对个别的一次决策,方案 2 也不一定是最好的——真遇上大洪水,方案 2 要赔 元, 比方案 1 的 元惨得多。
所以”用期望决策”这句话的完整版是:在可以重复很多次、且每次代价可加的场合,选期望最优的那个。 一次性的、赔不起的决策(例如那 元会让工地破产)就不能只看期望——这也是下一节要引入 方差的动机:期望相同的时候,还得比稳定性。
六、易错清单
按失分频率排:
- 权用错。 期望是按概率加权,不是把取值直接平均。看到”每个取值都乘上一个数再相加”, 先确认那个数是不是对应的概率。
- 分布列没写全就求期望。 求 之前必须先确认 的取值一个不漏、概率之和为 1。 漏一种情形,期望必错,而且错得不显眼。
- 把 当成”必然出现的值”。 不代表骰子会掷出 3.5。
- 换算时重新列表。 遇到”每分折算成 2 元再减 10 元”,直接用 , 别再列一张新分布列——重列一次就多一次出错机会。
- 把”和的期望等于期望的和”当作课本已给的结论直接用。 本册正文没有它(见第三段那条说明); 考场上如果题面没给,需要按题目允许的方式绕(列分布列,或用题面提供的提示)。
- 决策题只写数、不写结论。 算完 、、 要明确写出”应选方案几”以及 判断准则是”期望损失最小”,这一句是采分点。
- 拿”个数的期望在涨”去担保”比例也在涨”。 期望数的是个数,而概率往往是占比 ——分子涨的时候分母也可能在涨,商往哪边走要算了才知道。 2014 年浙江卷第 9 题四个选项正是”同向 / 反向”的全组合,答案恰恰是反向的那条。
- 以为不放回就不能用 0-1 拆分。 拆分只用到期望的可加性,可加性不要求独立 (见四节末尾那一格)。真正被不放回挡住的是方差,不是期望。
七、这一节考过的真题(怎么用它们)
页面下方”考过本节的真题”那一段是构建期派生出来的完整清单——本节是本册被真题引用最密的一节。 这里给一个读的顺序:
-
先做 2022 年第 15 题(7 张卡片取 3 张、记最小值为 ,求 与 ): 它是路一的标准形态——用组合数把四个概率一个个数出来,列表,再按定义求和。练的是”把分布列 列全”这一基本功(注意那两张写着 2 的卡片是不同的卡片)。
-
再做 2025 年第 14 题(5 个球有放回取三次,记至少取出一次的球的个数 ,求 ): 两条路都走得通,正好用来对照。路一要把 的概率各数一遍;路二令 表示 “第 号球被取到过”,则 ,五个一加就完了。
-
然后是 2024 年第 14 题(甲乙各四张牌比四轮):这道题的分布列极难直接列,但每一轮的得分都是 0-1 变量,路二一行给出 。它是”为什么要学拆分”最有说服力的例子。
-
插进来做 2014 年浙江卷(理)第 9 题(往甲盒里加球,比 与 ): 它把这一节的两条主线一次考完——路二给出 , 再用 (§7.1.2 的全概率公式,见那一节的”加权和变成期望”) 把概率那一问也接过来。它的教学价值在于”个数涨、占比跌”这对反向: 是 与乙盒红球占比的加权平均, 加得越多越被稀释。做完它再回头看易错清单第 7 条。
-
顺手做 2014 年浙江卷(理)第 12 题( 取 ,,,求 ): 这道题严格说属于 §7.3.2,但它真正的钥匙在本节第一段—— 加上取值 ,就是”支点落在正中间”,力矩平衡直接给出 , 中间那项由概率和补齐。先有均值的那个方程,才有分布列,顺序反了就会去列一堆没用的式子。 它是” 是一个方程而不只是一个答案”这句话最短的例子。
-
最后看 2023 年第 21 题(甲乙轮流投篮):它把”和的期望等于期望的和”写在题面里当条件给你, 再让你用前两问求出的 求和。这道题是这一节的上限—— 它考的不是会不会求期望,而是会不会把一个递推数列的结果接到期望上去。
习题详解(本站解答,无官方答案可核)
人教 A 版学生用书不含答案,教师用书与全解不在本站语料里——因此本节习题的解答无官方答案可核,它们是本站写的。每一道都过了独立 verifier 的 refute 优先复核(默认它有问题,找不出问题才放行),但那不等于官方标准答案:拿它对思路,别拿它对分。
本节目录里有五页(page-0067–page-0071,印刷页码第 62–66 页),印着 §7.3.1「离散型随机变量的均值」
的全部正文(问题 1、均值的定义、性质 、两点分布的均值)、例 1–例 3,
以及节末「练习」的第 1 题。本份收 1 道。
这道题是跨页的:题干、分布列与第 (1) 问印在 page-0071,第 (2) 问「求 」印在次页
page-0072——那一页归 §7.3.2 的目录。§7.3.2 那一份已声明把整道让给这里(单收半句等于交一道
没有分布列的题),所以下面连第 (2) 问一起做完。第 72 页上的「练习」第 2、3 题归 §7.3.2 那一份,
这里不收;「习题7.3」印在第 76 页,也归那一份。
题干与那张分布列表原先没进规范化转写(digest 把表格整张吞了),已按 ADR-0022 的逐页校订层
(page-0071-fix.md,对着整页扫描图逐格核)补回页面,所以下面的题面引文照旧是逐字引转写,
表格就在引文里。
页码用的是印刷页码(page-0071 的页脚印着 66)。注意 §7.3.2 那一份的小标题按文件号写作
「第 72 页」,指的是同一段练习的后半——全仓这两种口径混用的事另开了票(#534)统一。
练习(第 66 页)第 1 题
- 已知随机变量 的分布列为
1 2 3 4 5 0.1 0.3 0.4 0.1 0.1 (1) 求 ;
第 (2) 问印在次页:求 。
先验一句题面自洽:概率之和 ✓,且五个概率都非负, 确实是一张合法的分布列。这一步不是形式主义——分布列一旦不合法,下面算出来的”均值”就没有意义。
(1) 按定义,均值是取值按概率加权的和:
逐项算出来是 、、、、,相加:
核一句合不合理: 的取值范围是 到 ,均值必须落在这个闭区间里, 落在里面 ✓。 再看分布的形状——概率最大的一项是 (),而两端 与 的概率相等(都是 )、 的概率()比 的()大,所以重心应当被 拉到 的左边一点, 正是这样。
(2) 要求的是 。有两条路,答案必须一致。
路一:用本节的性质。 §7.3.1 给出 ,这里 、:
路二:老老实实把 的分布列写出来。 记 。 每取一个值, 就跟着取一个值, 而且概率原样搬过去——因为「」这个事件和「」是同一个事件:
| 5 | 8 | 11 | 14 | 17 | |
|---|---|---|---|---|---|
| 0.1 | 0.3 | 0.4 | 0.1 | 0.1 |
于是
两条路同答,。
路二为什么值得走一遍:它就是那条性质的证明。把 拆开, ,前一项是 ,后一项因为 而等于 —— 性质成立的关键正是「概率之和为 1」,也就是第一步验的那件事。
一个容易踩空的地方:路二里「概率原样搬过去」用到了 是一一对应——五个不同的 给出五个不同的 ,没有两项需要合并。若换成 这种不单调的映射, 与 都给 ,就必须先把它们的概率相加()再列表。 一次函数 ()永远是一一对应,所以这道题不必操心;但换个函数就要先想一想。 顺带一提, 这条性质对任意函数关系并不成立—— 一般地 ,本题里恰好 是一次函数才对得上。
原书转写(OCR,供核对)
共 5 页· 默认折起
机器转写,如有出入以上方扫描图为准。它是原文可搜索、可复制公式、读屏器读得出的形态, 也是教材原文引文的逐字比对靶。
7.3 离散型随机变量的数字特征
离散型随机变量的分布列全面地刻画了这个随机变量的取值规律。但在解决有些实际问题时,直接使用分布列并不方便。例如,要比较不同班级某次考试成绩,通常会比较平均成绩;要比较两名射箭运动员的射箭水平,一般会比较他们射箭的成绩(平均环数或总环数)以及稳定性。因此,类似于研究一组数据的均值和方差,我们也可以研究离散型随机变量的均值和方差,它们统称为随机变量的数字特征。
7.3.1 离散型随机变量的均值
问题 1 甲、乙两名射箭运动员射中目标箭靶的环数的分布列如表 7.3-1 所示.
如何比较他们射箭水平的高低呢?
类似两组数据的比较,首先比较击中的平均环数,如果平均环数相等,再看稳定性.
假设甲射箭 次,射中7环、8环、9环和10环的频率分别为 ,,,。甲 次射箭射中的平均环数为
当 足够大时,频率稳定于概率,所以 稳定于
即甲射中平均环数的稳定值(理论平均值)为 9,这个平均值的大小可以反映甲运动员的射箭水平.
同理,乙射中环数的平均值为
从平均值的角度比较,甲的射箭水平比乙高.
一般地,若离散型随机变量 X 的分布列如表 7.3-2 所示,
则称
为随机变量 X 的均值(mean) 或数学期望 (mathematical expectation),数学期望简称期望。均值是随机变量可能取值关于取值概率的加权平均数,它综合了随机变量的取值和取值的概率,反映了随机变量取值的平均水平。
例1 在篮球比赛中,罚球命中1次得1分,不中得0分。如果某运动员罚球命中的概率为0.8,那么他罚球1次的得分 的均值是多少?
分析:罚球有命中和不中两种可能结果,命中时 ,不中时 ,因此随机变量 服从两点分布. 的均值反映了该运动员罚球1次的平均得分水平.
解:因为
所以
即该运动员罚球1次的得分X的均值是0.8.
一般地,如果随机变量 X 服从两点分布,那么
例 2 抛掷一枚质地均匀的骰子,设出现的点数为 X,求 X 的均值.
分析:先求出 X 的分布列,再根据定义计算 X 的均值.
解:X 的分布列为
因此,
观察
掷一枚质地均匀的骰子,掷出的点数 的均值为3.5.随机模拟这个试验,重复60次和重复300次各做6次,观测出现的点数并计算平均数.根据观测值的平均数(样本均值)绘制统计图,分别如图7.3-1(1)和(2)所示.观察图形,在两组试验中,随机变量的均值与样本均值有何联系与区别?
观察图 7.3-1 可以发现:在这 12 组掷骰子试验中,样本均值各不相同,但它们都在掷出点数 X 的均值 3.5 附近波动,且重复掷 300 次的样本均值波动幅度明显小于重复 60 次的.
事实上,随机变量的均值是一个确定的数,而样本均值具有随机性,它围绕随机变量的均值波动。随着重复试验次数的增加,样本均值的波动幅度一般会越来越小。因此,我们常用随机变量的观测值的均值去估计随机变量的均值。
探究
如果 是一个离散型随机变量, 加一个常数或乘一个常数后,其均值会怎样变化?即 和 (其中 为常数)分别与 有怎样的关系?
设 的分布列为
根据随机变量均值的定义,
类似地,可以证明
你能给出证明吗?
一般地,下面的结论成立:
例3 猜歌名游戏是根据歌曲的主旋律制成的铃声来猜歌名. 某嘉宾参加猜歌名节目, 猜对每首歌曲的歌名相互独立, 猜对三首歌曲 A, B, C 歌名的概率及猜对时获得相应的公益基金如表 7.3-3 所示.
规则如下:按照 A,B,C 的顺序猜,只有猜对当前歌曲的歌名才有资格猜下一首。求嘉宾获得的公益基金总额 X 的分布列及均值。
分析:根据规则,公益基金总额 的可能取值有四种情况:猜错A,获得0元基金;猜对A而猜错B,获得1000元基金;猜对A和B而猜错C,获得3000元基金;A,B,C全部猜对,获得6000元基金。因此 是一个离散型随机变量。利用独立条件下的乘法公式可求分布列。
解:分别用 A, B, C 表示猜对歌曲 A, B, C 歌名的事件,则 A, B, C 相互独立.
X 的分布列如表 7.3-4 所示.
的均值为
如果改变猜歌的顺序,获得公益基金的均值是否相同?如果不同,你认为哪个顺序获得的公益基金均值最大?
例 4 根据天气预报,某地区近期有小洪水的概率为 0.25,有大洪水的概率为 0.01。该地区某工地上有一台大型设备,遇到大洪水时要损失 60 000 元,遇到小洪水时要损失 10 000 元。为保护设备,有以下 3 种方案:
方案 1 运走设备,搬运费为 3 800 元;
方案 2 建保护围墙,建设费为 2 000 元,但围墙只能防小洪水;
方案 3 不采取措施.
工地的领导该如何决策呢?
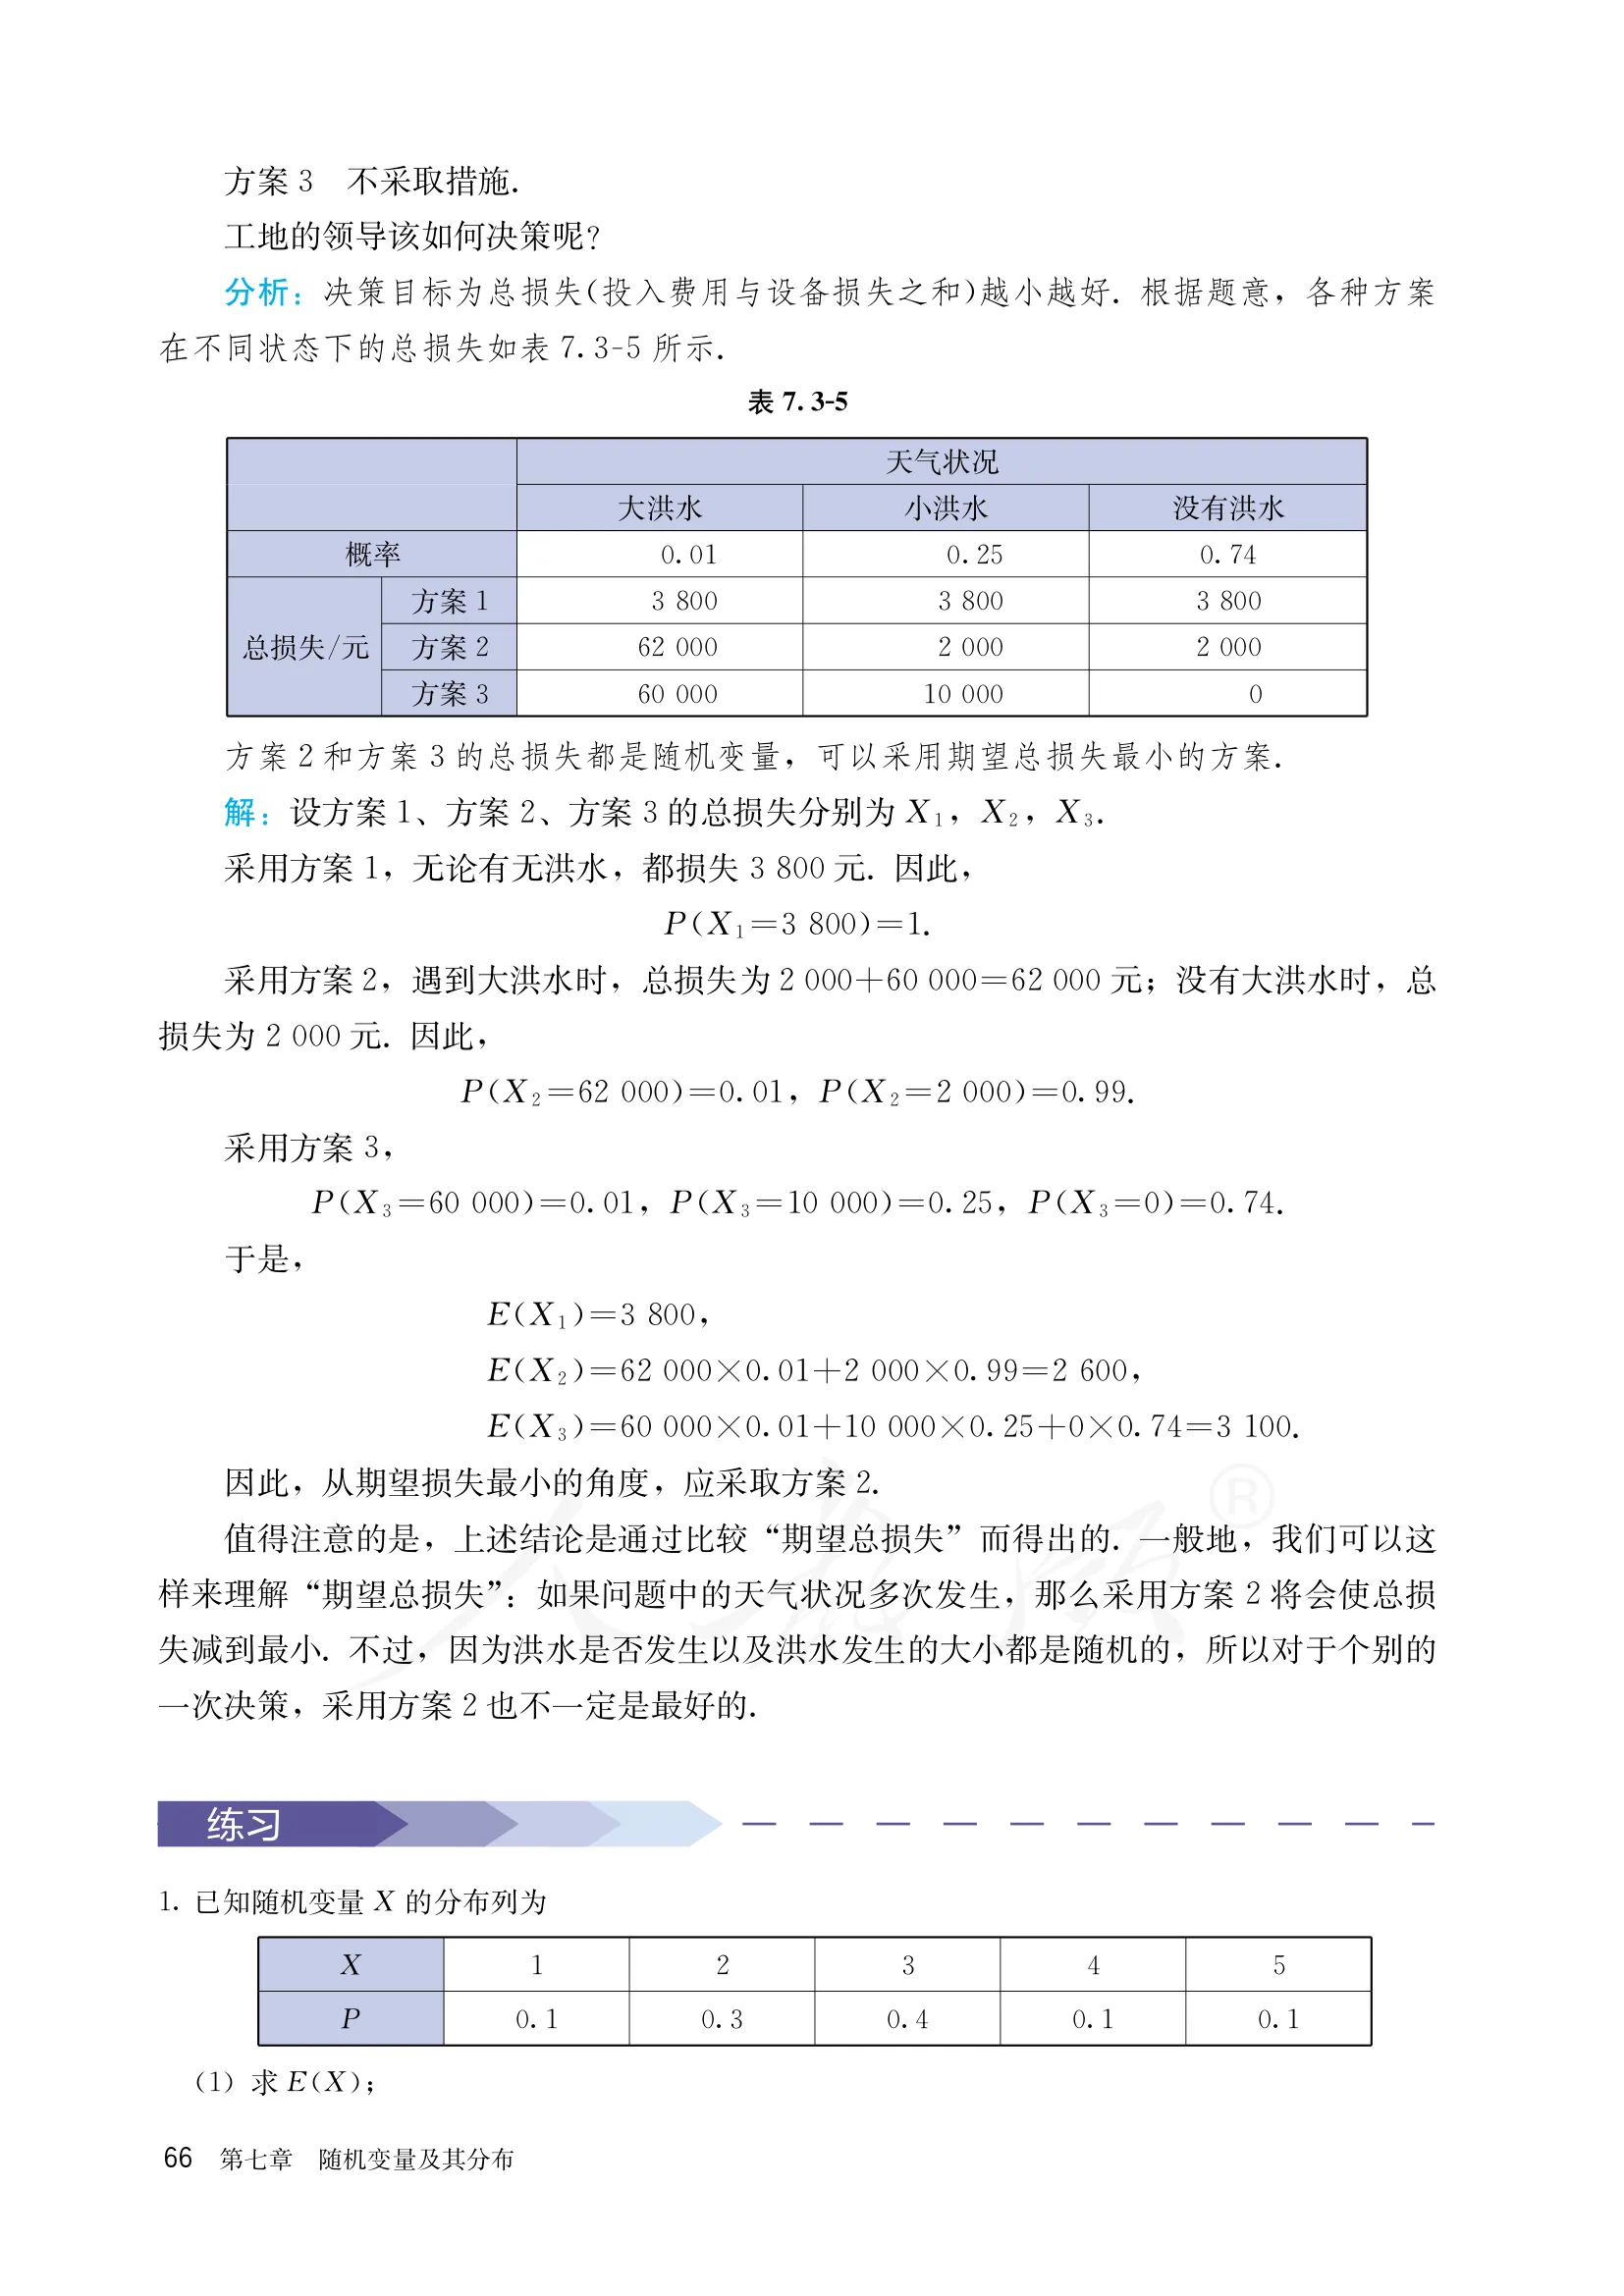
分析:决策目标为总损失(投入费用与设备损失之和)越小越好。根据题意,各种方案在不同状态下的总损失如表7.3-5所示。
表 7.3-5
| 天气状况:大洪水 | 天气状况:小洪水 | 天气状况:没有洪水 | |
|---|---|---|---|
| 概率 | 0.01 | 0.25 | 0.74 |
| 总损失/元 · 方案 1 | 3800 | 3800 | 3800 |
| 总损失/元 · 方案 2 | 62000 | 2000 | 2000 |
| 总损失/元 · 方案 3 | 60000 | 10000 | 0 |
方案2和方案3的总损失都是随机变量,可以采用期望总损失最小的方案.
解:设方案1、方案2、方案3的总损失分别为 ,,.
采用方案1,无论有无洪水,都损失3800元.因此,
采用方案2,遇到大洪水时,总损失为 元;没有大洪水时,总损失为2000元.因此,
采用方案 3,
于是,
因此,从期望损失最小的角度,应采取方案 2.
值得注意的是,上述结论是通过比较“期望总损失”而得出的。一般地,我们可以这样来理解“期望总损失”:如果问题中的天气状况多次发生,那么采用方案2将会使总损失减到最小。不过,因为洪水是否发生以及洪水发生的大小都是随机的,所以对于个别的一次决策,采用方案2也不一定是最好的。
练习
- 已知随机变量 的分布列为
| 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|
| 0.1 | 0.3 | 0.4 | 0.1 | 0.1 |
(1) 求 ;