8.2 一元线性回归模型及其应用
人教 A 版 · 本节 2 页原书扫描(原文)+ 本站重写的讲解与习题详解没有考过 ↓
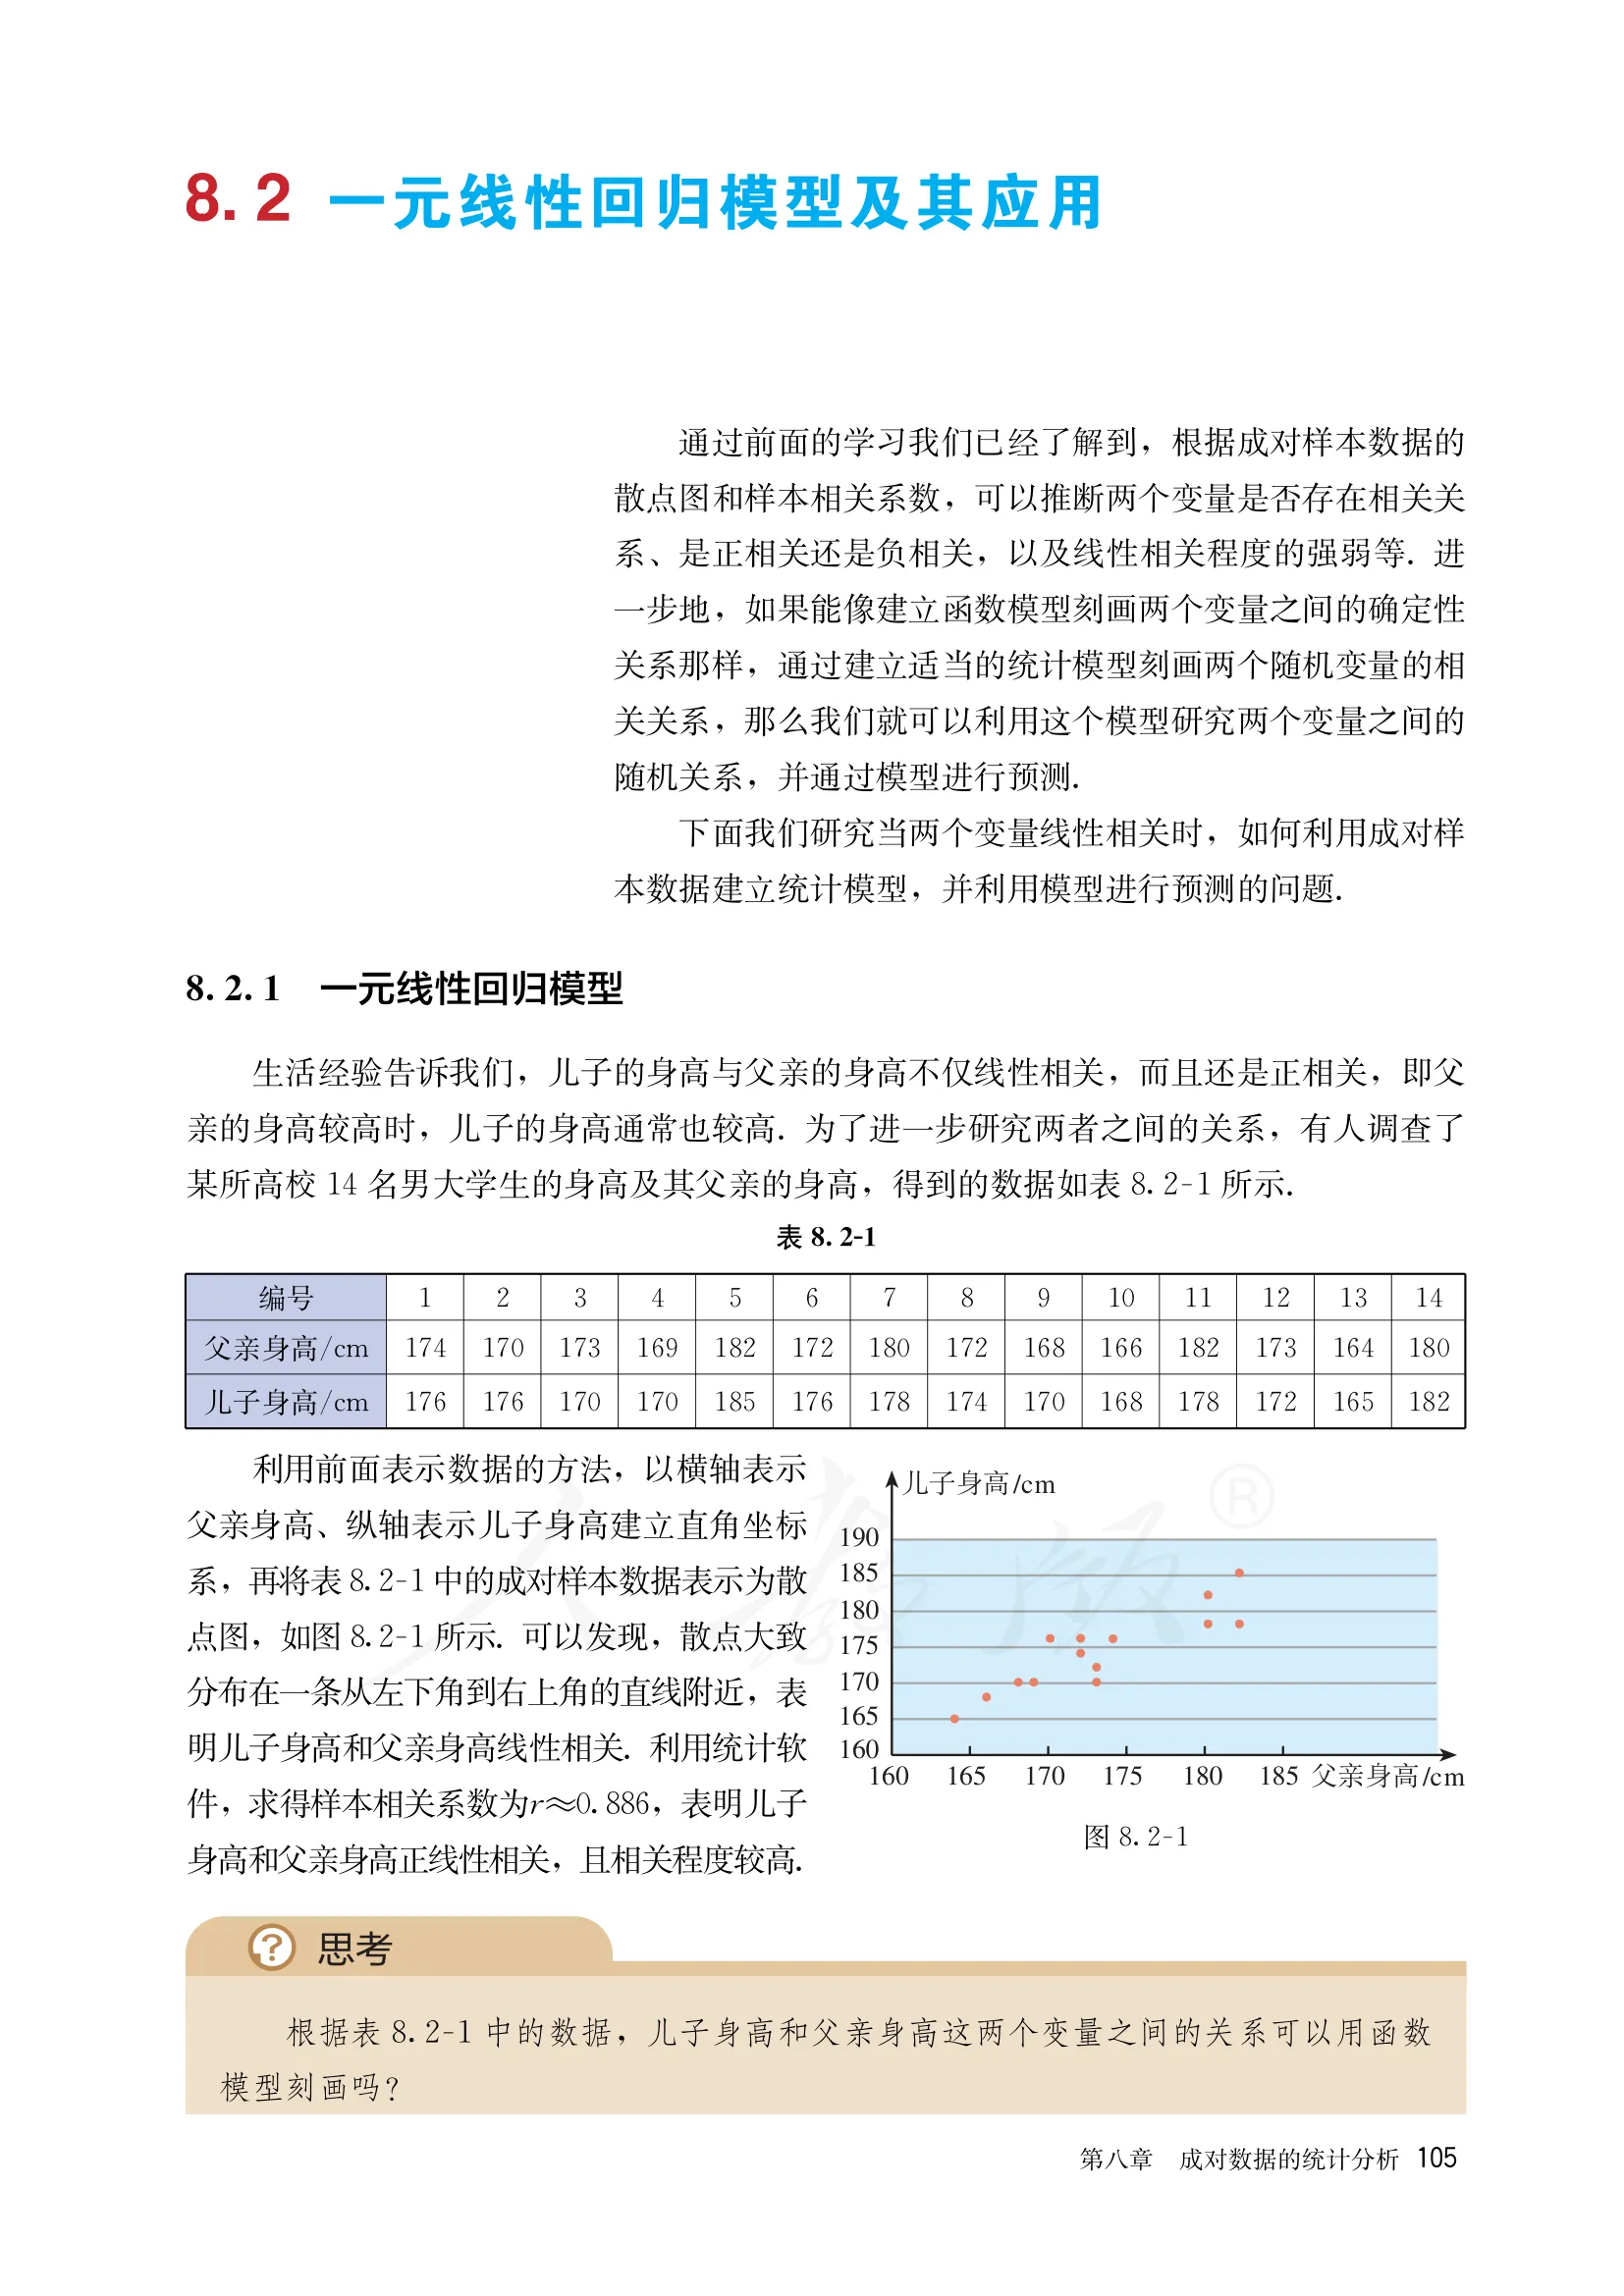
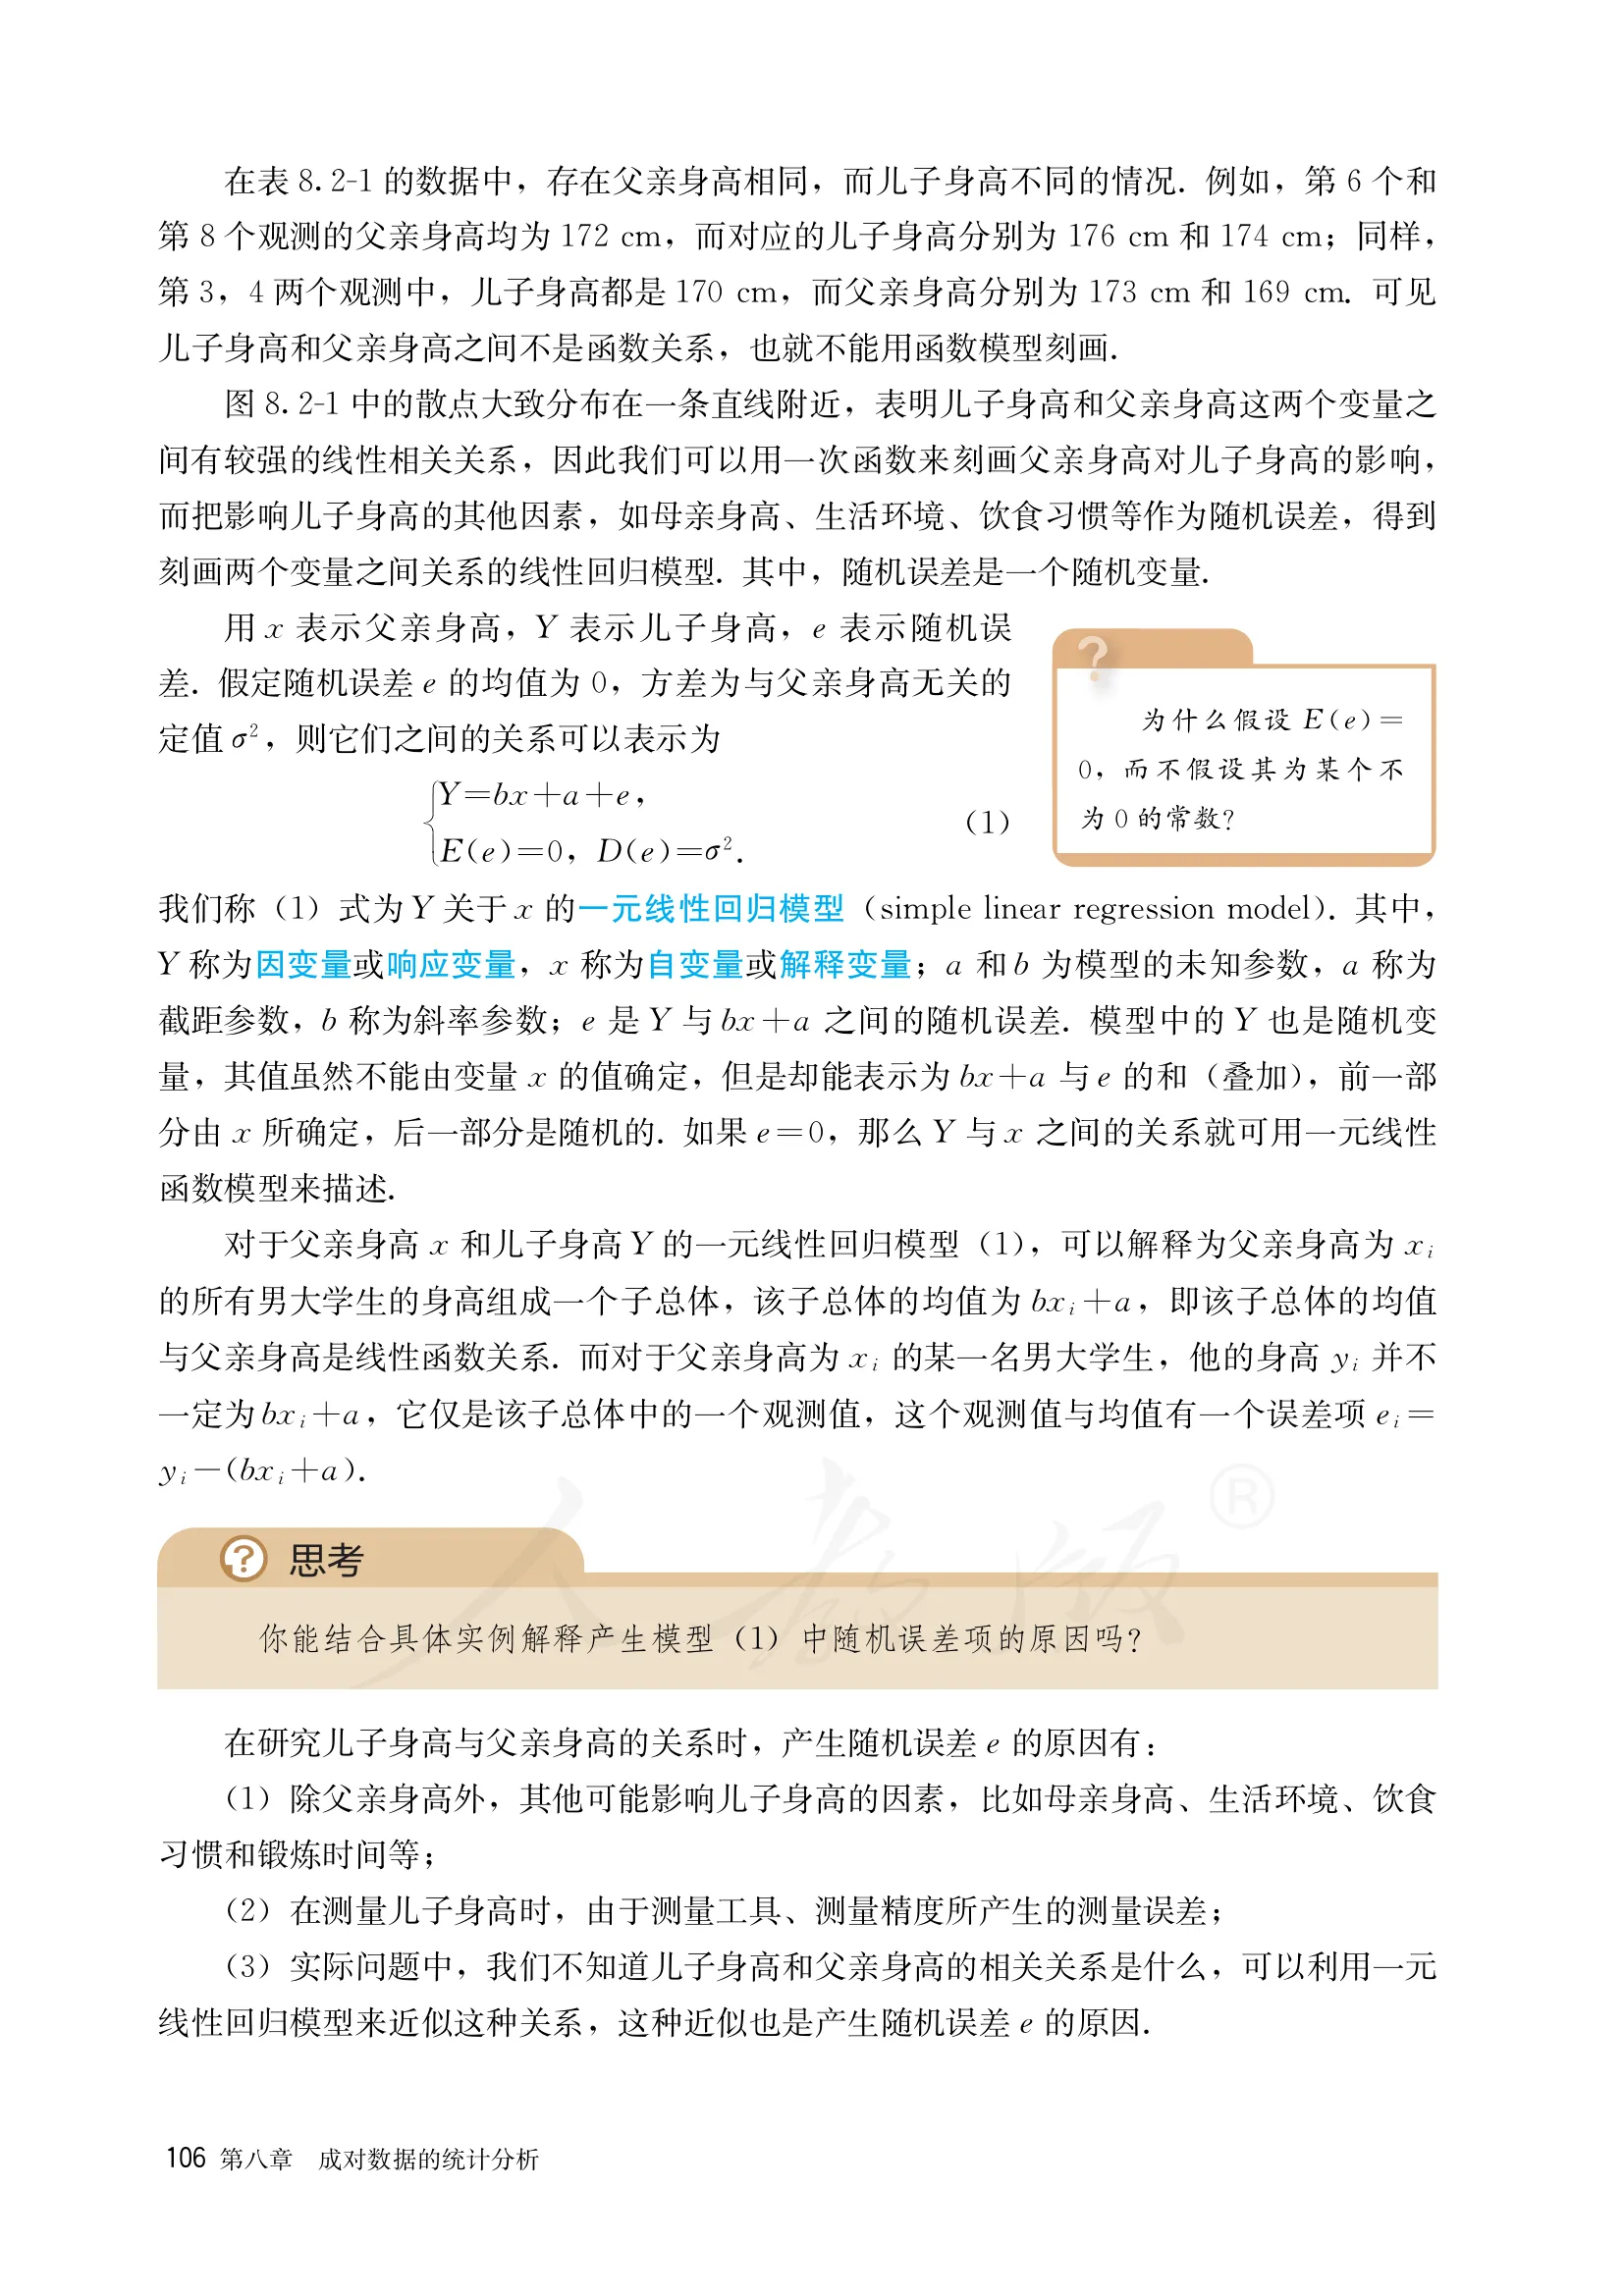
原书扫描页(人教 A 版原文)
考过本节的真题
没有考过本站语料里还没有一道真题考到这一节:现有攻略中没有任何一篇,经由引本节作教材出处的实体连到本节。这一段是两跳派生的(节 ← 实体 ← 攻略),源里没有「节 → 题」的手写声明——新的攻略一上站,清单会自己长出来。它说的是本站已上站的那些卷子里没有考到,不是「高考不考这一节」。
讲解
本站对这一节的重写(不是原书转写):顺序可重组、推导可补全,目标是易读易学 + 与真题关联。原文以上方扫描图为准。
本节只有两页(page-0110–page-0111,印刷页码第 105–106 页),是 §8.2 的开篇加上
§8.2.1「一元线性回归模型」的全部内容。这两页里没有练习题,所以本节只有讲解这一份;
最小二乘估计和习题在下一小节 §8.2.2。
一、这一节要往前走哪一步
前面 §8.1 走完了两步:
| 已经会的 | 用什么工具 | 能回答的问题 |
|---|---|---|
| 判断有没有相关关系、正还是负、线性还是曲线 | 散点图 | 关系的方向和形状 |
| 量化线性相关的程度 | 样本相关系数 | 关系的强弱 |
但这两样都只是描述。知道父亲身高和儿子身高正线性相关、 之后, 还有一个更实际的问题没回答:父亲身高 176 cm,儿子大概多高?
要回答它,就得把那条”散点大致贴着的直线”具体写出来。 换句话说,我们需要一个模型——像用函数模型刻画确定性关系那样, 用一个统计模型去刻画两个随机变量之间的相关关系,然后用它做预测。
这一节先解决”模型长什么样”,下一节 §8.2.2 再解决”参数怎么定”。
二、引例:父子身高的 14 对数据
课本调查了某高校 14 名男大学生的身高及其父亲的身高(表 8.2-1),以父亲身高为横轴、 儿子身高为纵轴画出散点图(图 8.2-1)。观察结果是:
- 散点大致分布在一条从左下角到右上角的直线附近 线性相关;
- 用统计软件算得样本相关系数 正线性相关,相关程度较高。
这两句正是 §8.1 教的读法。到此为止,“该不该谈线性”已经有了肯定的回答,下面才轮到建模。
三、关键的一问:能不能用函数模型?
根据表8.2-1中的数据,儿子身高和父亲身高这两个变量之间的关系可以用函数模型刻画吗?
不能。 而且理由不是”点没有完全落在直线上”这种含糊说法,课本给的是数据里的直接反例:
- 第 6 个和第 8 个观测中,父亲身高都是 172 cm,儿子身高却分别是 176 cm 和 174 cm;
- 第 3、4 两个观测中,儿子身高都是 170 cm,父亲身高却分别是 173 cm 和 169 cm。
第一条就够了:函数关系要求同一个自变量的值只能对应唯一的函数值。 这里 同时对应了 和 ,函数的定义当场被违反。 所以儿子身高和父亲身高之间不是函数关系,也就不能用函数模型刻画。
这个反例的做法值得学:要否定”是函数关系”,不必大费周章, 只要在数据里找出一个 配了两个不同的 就完事了。 (第二条”儿子身高相同而父亲身高不同”是把 与 的角色对调后的同类反例, 说明反过来把 当自变量也一样不行。)
四、建模的思路:主要因素 + 其余因素
既然不是函数关系,又确实有较强的线性相关,自然的想法是拆成两部分:
- 能解释的部分用一次函数 刻画——这是散点图和 支持的形状;
- 解释不了的部分——母亲身高、生活环境、饮食习惯、锻炼时间,还有测量误差—— 没法一一列举,就统统打包成一个量,叫随机误差 。
要点: 是一个随机变量,不是一个”小数值”。 它代表的是”除父亲身高之外所有影响的合力”, 本身有分布、有均值、有方差。把它当成随机变量来处理,正是”统计模型”区别于”函数模型”的地方。
五、一元线性回归模型
用 表示父亲身高, 表示儿子身高, 表示随机误差。 假定 的均值为 、方差为与父亲身高无关的定值 ,得到
(1)式称为 关于 的一元线性回归模型(simple linear regression model)。 名词一次记清:
| 记号 | 名称 | 说明 |
|---|---|---|
| 因变量,也叫响应变量 | 要被解释、被预测的那个,是随机变量 | |
| 自变量,也叫解释变量 | 用来解释的那个,取定的值 | |
| 截距参数 | 未知,待估计 | |
| 斜率参数 | 未知,待估计 | |
| 随机误差 | 与 之间的差,随机变量 |
“一元”指只有一个自变量,“线性”指对 是一次的。
模型(1)读起来是这样一句话: 的值不能由 确定,但可以表示成两部分之和——前一部分 由 完全确定,后一部分 是随机的。
一个有用的极限情形:如果 ,模型就退化成 , 这时 与 之间的关系就可以用一元线性函数模型来描述了。 换句话说,函数模型是回归模型在”没有随机部分”时的特例—— 这和 §8.1.1 里”相关关系紧到极致就成了函数关系”是同一件事的两种说法。
六、为什么假设
为什么假设 ,而不假设其为某个不为0的常数?
这是课本留在旁边的一问,值得认真答,因为它触及模型的可识别性。
答:假设 不损失任何一般性,而假设它是别的常数会让 变得说不清。
设想真的有 。令
那么 ,,并且
新模型和老模型描述的是同一件事,形式也完全一样,只是误差的均值被搬到了截距里。 可见”误差有一个非零的平均偏移”这种情形,早已被截距参数 吸收掉了, 再让 也带一个常数均值,纯属重复——而且会造成 与 无法分开确定 (把 加 1、 减 1,模型一模一样)。
所以约定 的作用是分工明确:
- 系统性的、固定的部分全部归 ;
- 只承担纯粹随机、平均起来会互相抵消的波动。
顺带说另一个假设 的含义:方差与父亲身高无关。 它是说,不管父亲是 165 cm 还是 180 cm,儿子身高围绕各自那条直线的摆动幅度是一样的。 这一条同样是为了让模型简单可用;如果高个子父亲的儿子身高波动明显更大, 这个假设就不成立,得换更复杂的模型。
七、模型的”子总体”解释——本节最要紧的一段
课本给了模型(1)一个非常具体的读法,把抽象的 落到实处:
- 把父亲身高为 的所有男大学生看作一个子总体;
- 这个子总体的身高均值就是 ,也就是说,子总体的均值与父亲身高是线性函数关系;
- 而对于父亲身高为 的某一名男大学生,他的身高 不一定等于 , 它只是这个子总体里的一个观测值,与均值之间差着一个误差项
为什么这段最要紧? 因为它一举回答了初学回归时最容易糊涂的问题: “直线到底在预测什么?”
答案是:直线预测的是子总体的均值,不是某一个人的身高。
回到开头那个问题——父亲身高 176 cm,儿子大概多高? 模型能给的答案是”父亲身高 176 cm 的这一群人,他们儿子身高的平均值大约是 ”。 具体到某一个人,还要加上他自己那份随机误差 ,可能高些也可能矮些。 把回归直线的取值当成个体的确定预测,是对回归模型最常见的误用。
这也解释了第三节那个反例为什么不构成矛盾:第 6 和第 8 个观测的父亲身高都是 172 cm, 他们属于同一个子总体,均值只有一个(),但两个观测值可以不同—— 和 分别是这个均值加上各自的 和 。
八、随机误差从哪里来
你能结合具体实例解释产生模型(1)中随机误差项的原因吗?
课本就父子身高这个例子给了三条,它们分属三种完全不同的来源,建议分开记:
(1)遗漏的影响因素。 除父亲身高外,母亲身高、生活环境、饮食习惯、锻炼时间等 都会影响儿子身高,但模型里没有它们,只好归入 。 这是随机误差最主要的来源,也是”相关关系而非函数关系”的根本原因。
(2)测量误差。 测量儿子身高时,测量工具的精度、读数的方式都会带来偏差。 即使前一类因素完全不存在,这一类也躲不掉。
(3)模型近似本身带来的误差。 我们其实并不知道儿子身高与父亲身高的真实关系是什么, 只是看散点图像一条直线,就用一元线性回归模型去近似它。 如果真实关系其实有一点弯曲,那么”用直线代替真实曲线”这件事本身就会产生误差。
第(3)条最容易被忽略,却最有方法论意义:它提醒我们, 模型是我们选的,不是数据自带的。选错了模型,误差里就会混进本不该有的系统性成分—— 这也是为什么 §8.2.2 里要检查残差、判断模型合不合适。
九、函数模型与回归模型的对照
| 一元线性函数模型 | 一元线性回归模型 | |
|---|---|---|
| 形式 | ||
| 定后 | 唯一确定 | 不确定,是随机变量 |
| 同一个 | 只有一个 | 对应一个子总体,直线给的是它的均值 |
| 刻画的关系 | 确定性关系 | 相关关系 |
| 误差 | 无 | ,且 、 |
| 退化关系 | —— | 时退化成左边一列 |
十、小结
- 本节只建模型,不估参数:、 现在还是两个未知数,怎么由数据把它们定出来是 §8.2.2 的事;
- 建模的动机: 与 线性相关但不是函数关系(数据里同一个父亲身高对应了不同的儿子身高), 所以要在一次函数上叠一个随机误差;
- 模型(1)三件套:,,;
- 不是额外的限制,只是把误差的平均偏移归进截距 ,好让 有唯一的含义;
- 回归直线预测的是子总体的均值,不是某个个体的取值——这句话贯穿整章;
- 随机误差有三个来源:遗漏因素、测量误差、模型近似。
下一节 §8.2.2 会用最小二乘法把 、 估计出来,得到经验回归方程 ,并用残差检验模型是否合适。
原书转写(OCR,供核对)
共 2 页· 默认折起
机器转写,如有出入以上方扫描图为准。它是原文可搜索、可复制公式、读屏器读得出的形态, 也是教材原文引文的逐字比对靶。
8.2 一元线性回归模型及其应用
通过前面的学习我们已经了解到,根据成对样本数据的散点图和样本相关系数,可以推断两个变量是否存在相关关系、是正相关还是负相关,以及线性相关程度的强弱等。进一步地,如果能像建立函数模型刻画两个变量之间的确定性关系那样,通过建立适当的统计模型刻画两个随机变量的相关关系,那么我们就可以利用这个模型研究两个变量之间的随机关系,并通过模型进行预测。
下面我们研究当两个变量线性相关时,如何利用成对样本数据建立统计模型,并利用模型进行预测的问题.
8.2.1 一元线性回归模型
生活经验告诉我们,儿子的身高与父亲的身高不仅线性相关,而且还是正相关,即父亲的身高较高时,儿子的身高通常也较高。为了进一步研究两者之间的关系,有人调查了某所高校14名男大学生的身高及其父亲的身高,得到的数据如表8.2-1所示。
利用前面表示数据的方法,以横轴表示父亲身高、纵轴表示儿子身高建立直角坐标系,再将表8.2-1中的成对样本数据表示为散点图,如图8.2-1所示。可以发现,散点大致分布在一条从左下角到右上角的直线附近,表明儿子身高和父亲身高线性相关。利用统计软件,求得样本相关系数为 ,表明儿子身高和父亲身高正线性相关,且相关程度较高。
思考
根据表8.2-1中的数据,儿子身高和父亲身高这两个变量之间的关系可以用函数模型刻画吗?
在表 8.2-1 的数据中,存在父亲身高相同,而儿子身高不同的情况。例如,第 6 个和第 8 个观测的父亲身高均为 172 cm,而对应的儿子身高分别为 176 cm 和 174 cm;同样,第 3,4 两个观测中,儿子身高都是 170 cm,而父亲身高分别为 173 cm 和 169 cm。可见儿子身高和父亲身高之间不是函数关系,也就不能用函数模型刻画。
图 8.2-1 中的散点大致分布在一条直线附近,表明儿子身高和父亲身高这两个变量之间有较强的线性相关关系,因此我们可以用一次函数来刻画父亲身高对儿子身高的影响,而把影响儿子身高的其他因素,如母亲身高、生活环境、饮食习惯等作为随机误差,得到刻画两个变量之间关系的线性回归模型。其中,随机误差是一个随机变量。
用 表示父亲身高, 表示儿子身高, 表示随机误差。假定随机误差 的均值为 0,方差为与父亲身高无关的定值 ,则它们之间的关系可以表示为
为什么假设 ,而不假设其为某个不为0的常数?
我们称(1)式为 关于 的一元线性回归模型(simple linear regression model)。其中, 称为因变量或响应变量, 称为自变量或解释变量; 和 为模型的未知参数, 称为截距参数, 称为斜率参数; 是 与 之间的随机误差。模型中的 也是随机变量,其值虽然不能由变量 的值确定,但是却能表示为 与 的和(叠加),前一部分由 所确定,后一部分是随机的。如果 ,那么 与 之间的关系就可用一元线性函数模型来描述。
对于父亲身高 和儿子身高 的一元线性回归模型(1),可以解释为父亲身高为 的所有男大学生的身高组成一个子总体,该子总体的均值为 ,即该子总体的均值与父亲身高是线性函数关系。而对于父亲身高为 的某一名男大学生,他的身高 并不一定为 ,它仅是该子总体中的一个观测值,这个观测值与均值有一个误差项 。
思考
你能结合具体实例解释产生模型(1)中随机误差项的原因吗?
在研究儿子身高与父亲身高的关系时,产生随机误差 的原因有:
(1)除父亲身高外,其他可能影响儿子身高的因素,比如母亲身高、生活环境、饮食习惯和锻炼时间等;
(2) 在测量儿子身高时, 由于测量工具、测量精度所产生的测量误差;
(3)实际问题中,我们不知道儿子身高和父亲身高的相关关系是什么,可以利用一元线性回归模型来近似这种关系,这种近似也是产生随机误差 的原因.