4.5.3 函数模型的应用

人教 A 版 · 本节 20 页原书扫描(原文)+ 本站重写的讲解与习题详解没有考过 ↓

原书扫描页(人教 A 版原文)
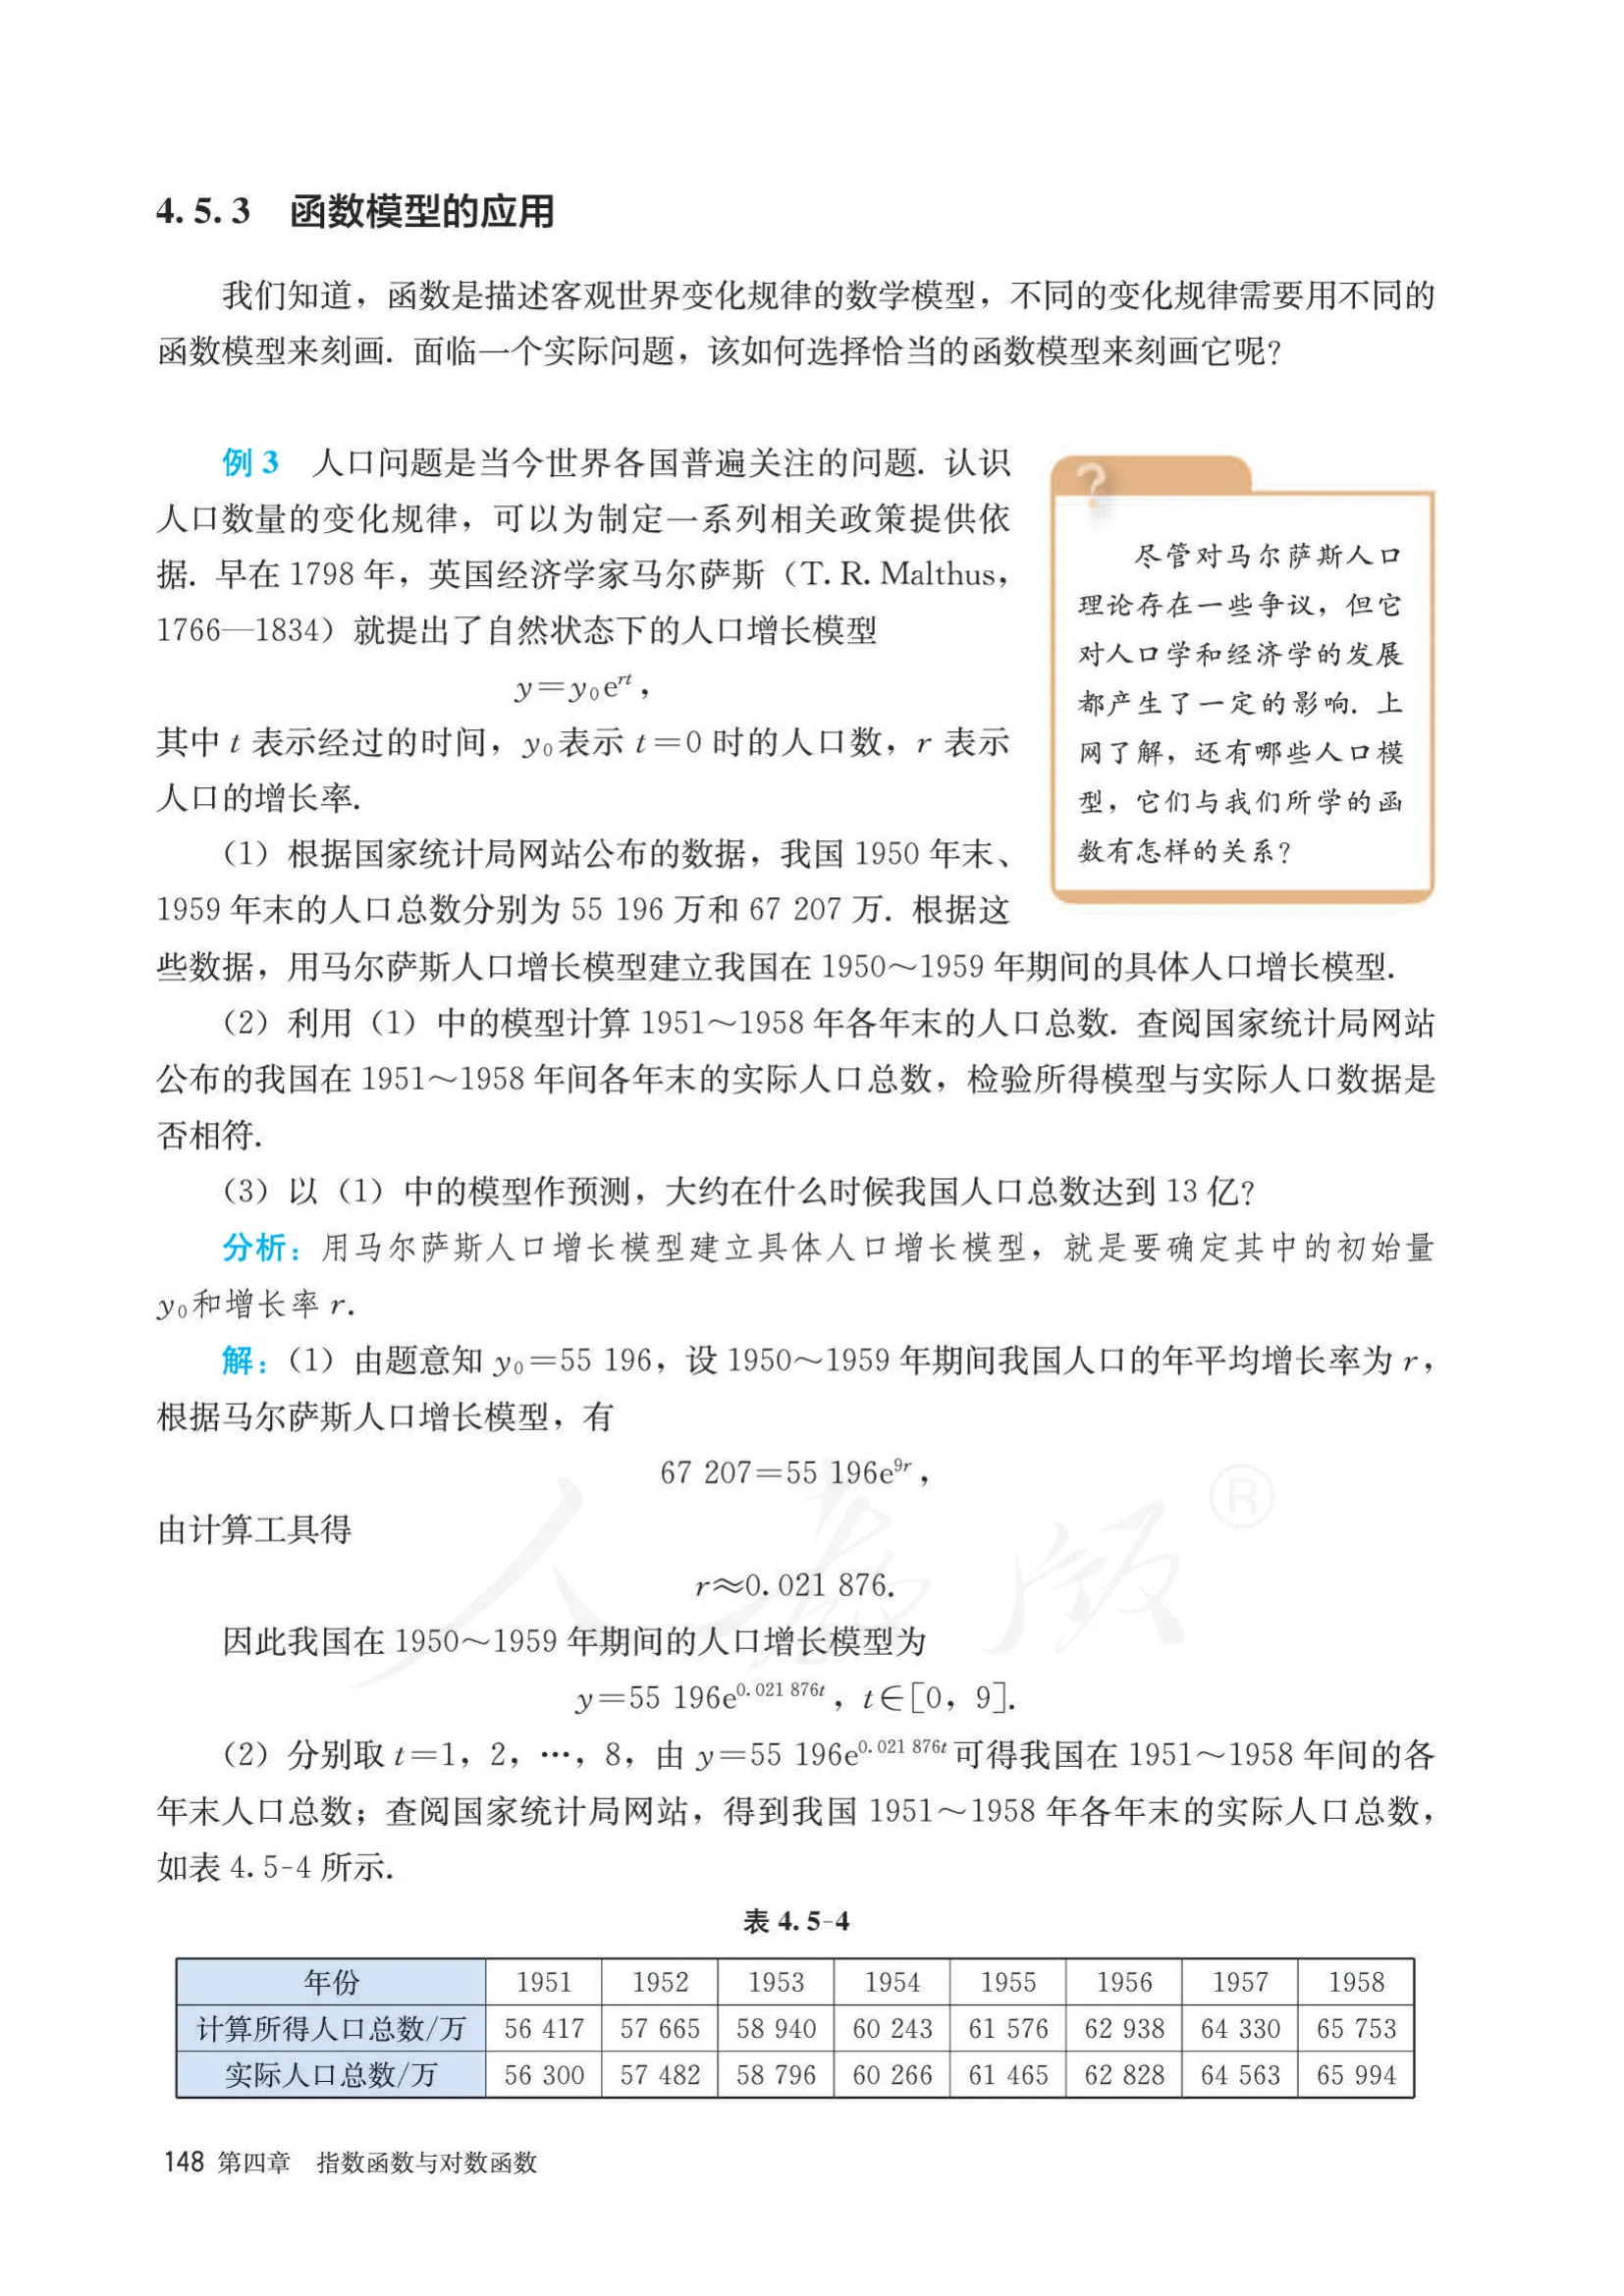
原书 page-0155
page-0155
原书 page-0156
page-0156
原书 page-0157
page-0157
原书 page-0158
page-0158
原书 page-0159
page-0159
原书 page-0160
page-0160
原书 page-0161
page-0161
原书 page-0162
page-0162
原书 page-0163
page-0163
原书 page-0164
page-0164
原书 page-0165
page-0165
原书 page-0166
page-0166
原书 page-0167
page-0167
原书 page-0168
page-0168
原书 page-0169
page-0169
原书 page-0170
page-0170
原书 page-0171
page-0171
原书 page-0172
page-0172
原书 page-0173
page-0173
原书 page-0174
page-0174

考过本节的真题

没有考过

本站语料里还没有一道真题考到这一节:现有攻略中没有任何一篇,经由引本节作教材出处的实体连到本节。这一段是两跳派生的(节 ← 实体 ← 攻略),源里没有「节 → 题」的手写声明——新的攻略一上站,清单会自己长出来。它说的是本站已上站的那些卷子里没有考到,不是「高考不考这一节」。

讲解

本站对这一节的重写(不是原书转写):顺序可重组、推导可补全,目标是易读易学 + 与真题关联。原文以上方扫描图为准。

前两节解决”方程的解在哪、解是多少”,这最后一节回到最根本的问题:怎么把一个现实问题翻译成函数模型,再用模型去解释和预测。§3.4 的”函数的应用(一)“已经学过建模型,这一节(函数的应用(二))用四个完整例子把”应用”做深:例 3、例 4 是把现实数据代入已知模型(人口模型、碳 14 测年),例 5、例 6 是从若干候选模型中选一个(投资方案、奖励方案),最后归纳出用函数建模解决实际问题的完整过程。

学完这一节,你要能:分清”已知模型直接套”和”自己建模型”两条路,会代入数据定参数,会在几个候选模型中做选择并用条件逐条验证,能把整个建模过程按四步讲清楚。

一、已知模型的直接应用:例 3 马尔萨斯人口模型

1798 年马尔萨斯提出自然状态下的人口增长模型

y=y0ert,y = y_0 \mathrm{e}^{rt},

其中 tt 表示经过的时间,y0y_0 表示 t=0t = 0 时的人口数,rr 表示人口的增长率。例 3 的任务就是把我国的真实人口数据代入这个已知模型:我国 1950 年末人口 55196 万、1959 年末人口 67207 万,设 t=0t = 0 对应 1950 年末,则

67207=55196e9r⇒r≈0.021876,67207 = 55196\mathrm{e}^{9r} \Rightarrow r \approx 0.021876,

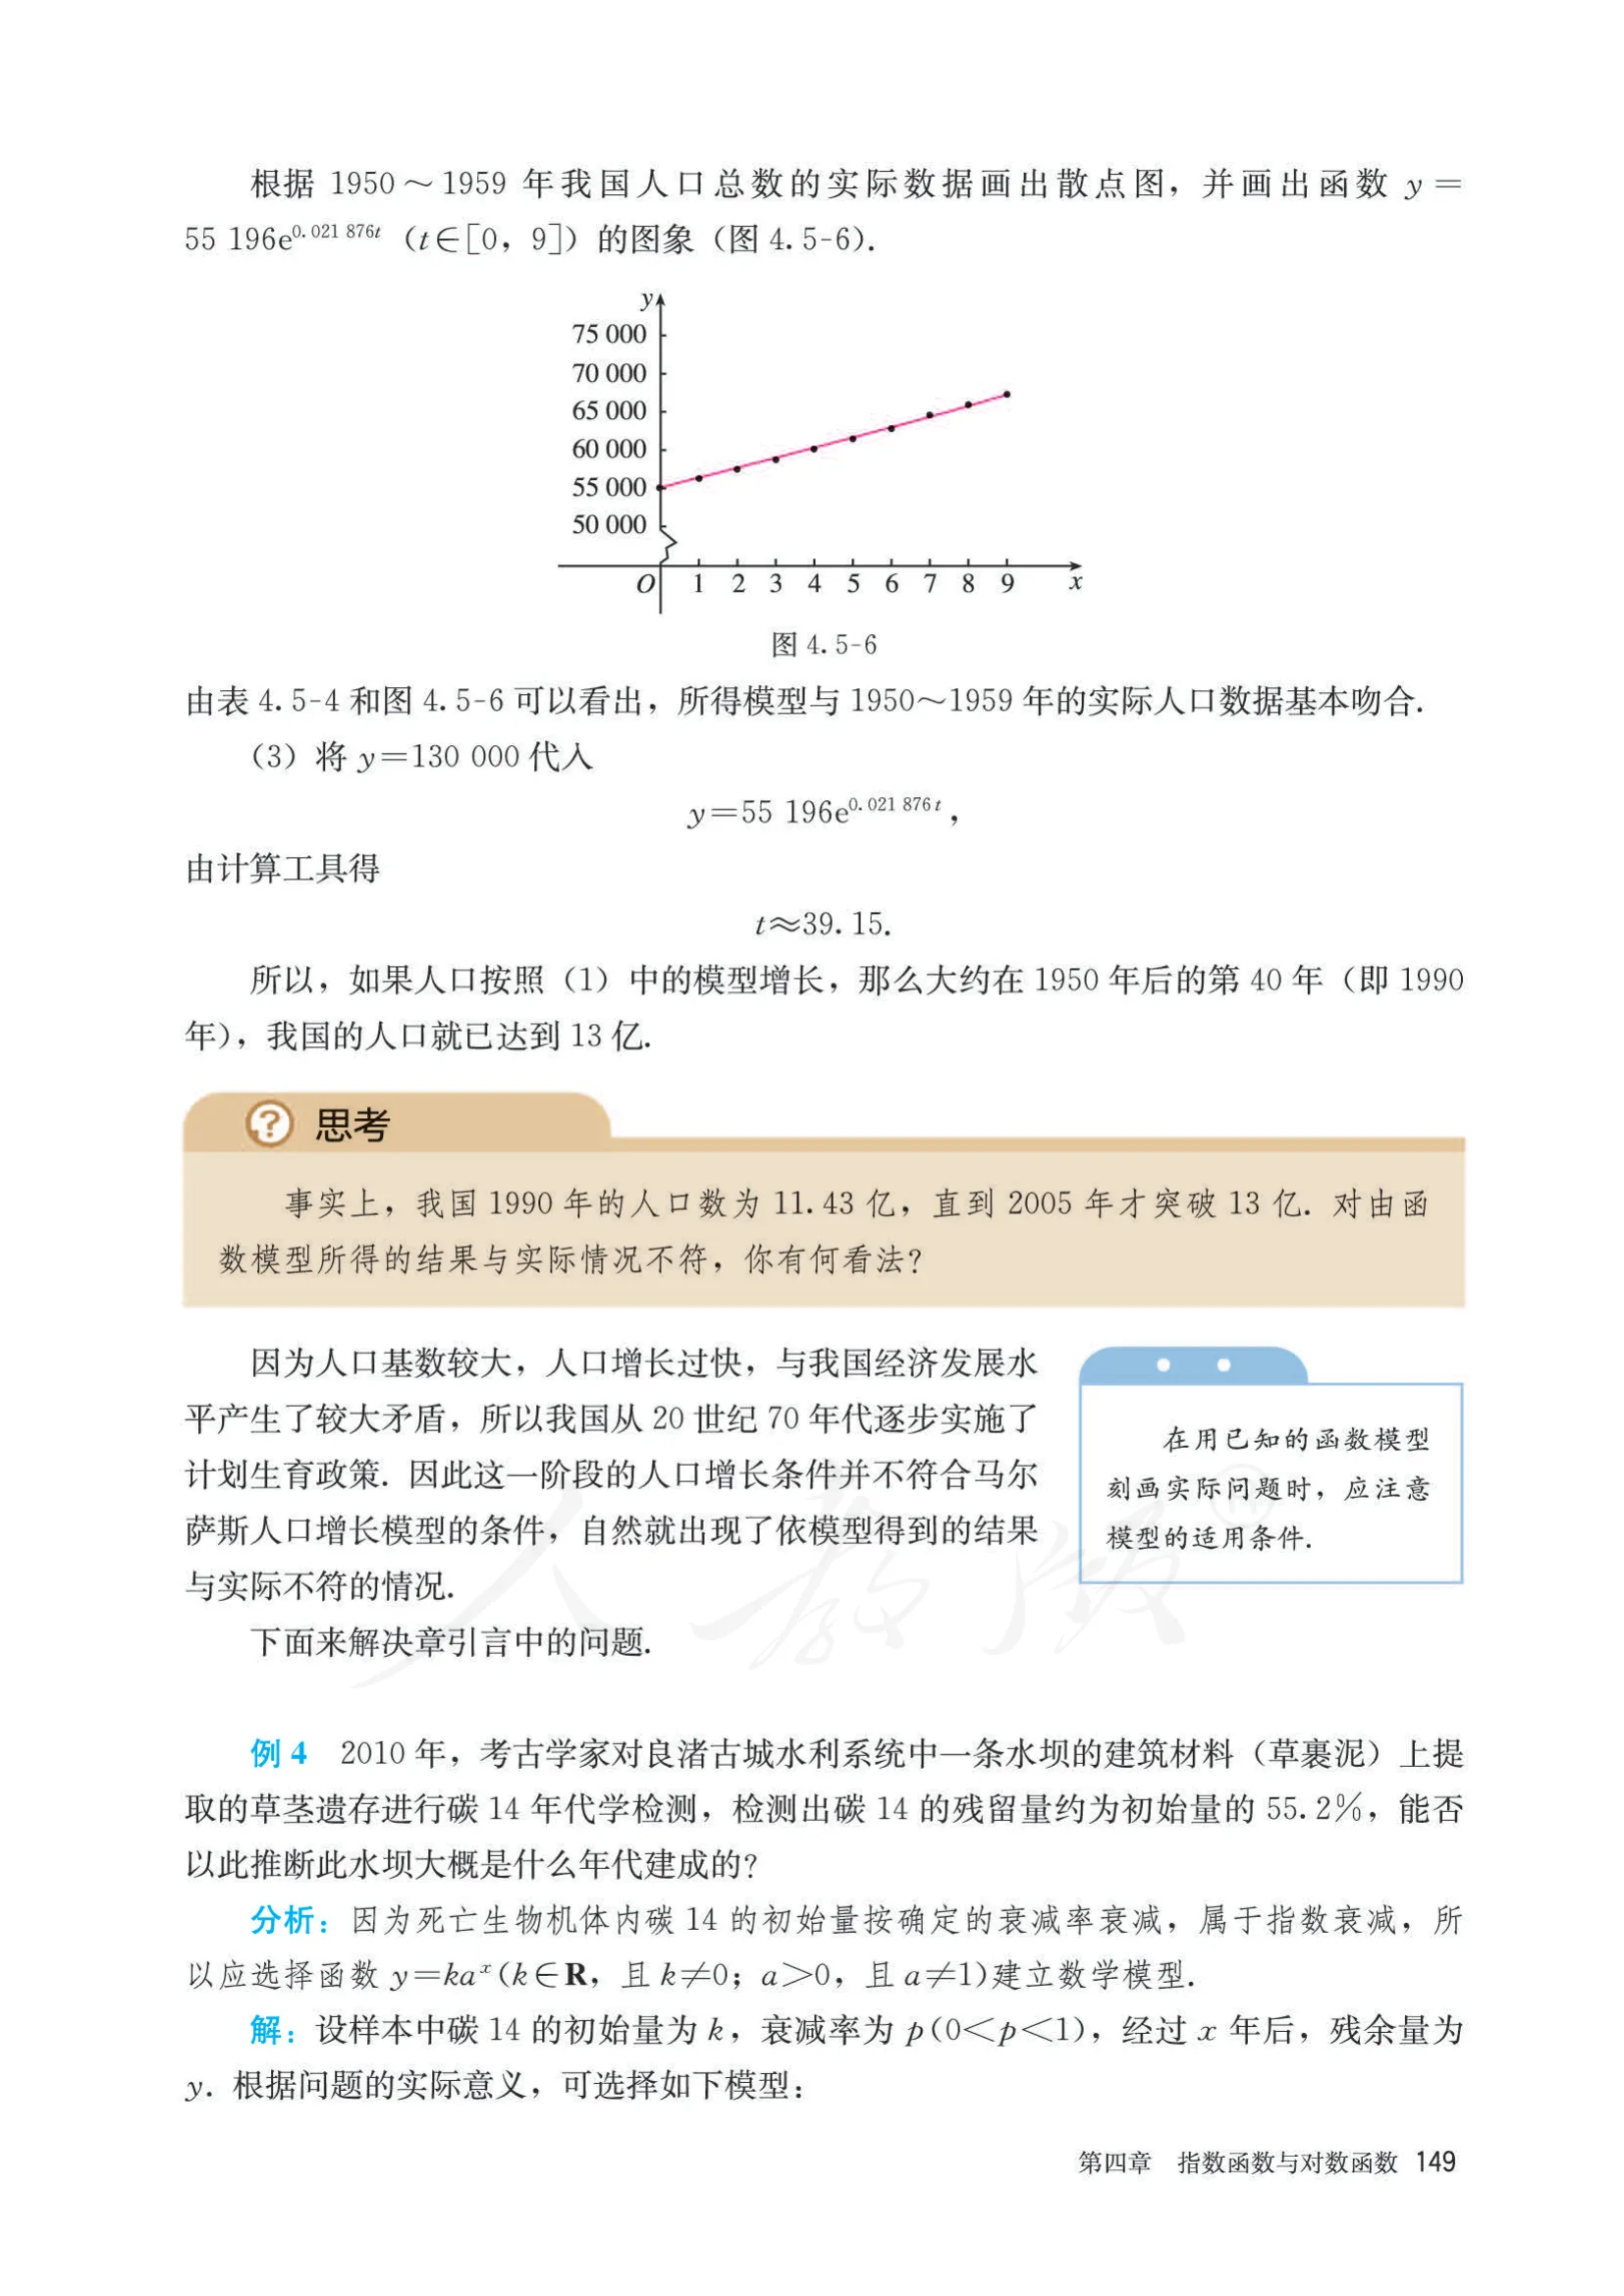
得到我国 1950~1959 年的人口增长模型 y=55196e0.021876ty = 55196\mathrm{e}^{0.021876t}(t∈[0,9]t \in [0, 9])。代入 t=1,2,…,8t = 1, 2, \dots, 8 算出的预测值与国家统计局公布的 1951~1958 年实际人口基本吻合,说明模型在这一段成立。

用模型做预测:令 y=130000y = 130000(13 亿 = 130000 万),由计算工具得 t≈39.15t \approx 39.15——按此模型大约在 1950 年后第 40 年(即 1990 年)人口达到 13 亿。但实际 1990 年人口只有 11.43 亿,直到 2005 年才破 13 亿。课本”思考”给出的解释:我国从 20 世纪 70 年代起实施计划生育政策,人口增长条件不再符合马尔萨斯模型(自然状态下、增长率恒定)的前提,模型自然失效。

这就是这一节要反复强调的第一条经验:在用已知函数模型刻画实际问题时,应注意模型的适用条件。模型是”某个范围内”的规律,超出范围(政策变化、条件改变)就失效,不能盲目外推。

二、例 4 碳 14 测年:自己建模型并求解

生物死亡后体内碳 14 按确定的衰减率衰减,属于指数衰减,因此选择函数 y=kaxy = ka^x 建模。设初始量为 kk、衰减率为 pp,经过 xx 年残余量为 y=k(1−p)xy = k(1-p)^x。利用碳 14 的半衰期为 5730 年:

k(1−p)5730=12k⇒1−p=125730,k(1-p)^{5730} = \frac{1}{2}k \Rightarrow 1 - p = \sqrt[5730]{\frac{1}{2}},

于是 y=k(125730)xy = k\left(\sqrt[5730]{\frac{1}{2}}\right)^x。2010 年良渚古城水坝草茎样本残留量约为初始量的 55.2%:

(125730)x=0.552⇒x=log⁡1/257300.552≈4912,\left(\sqrt[5730]{\frac{1}{2}}\right)^x = 0.552 \Rightarrow x = \log_{\sqrt[5730]{1/2}} 0.552 \approx 4912,

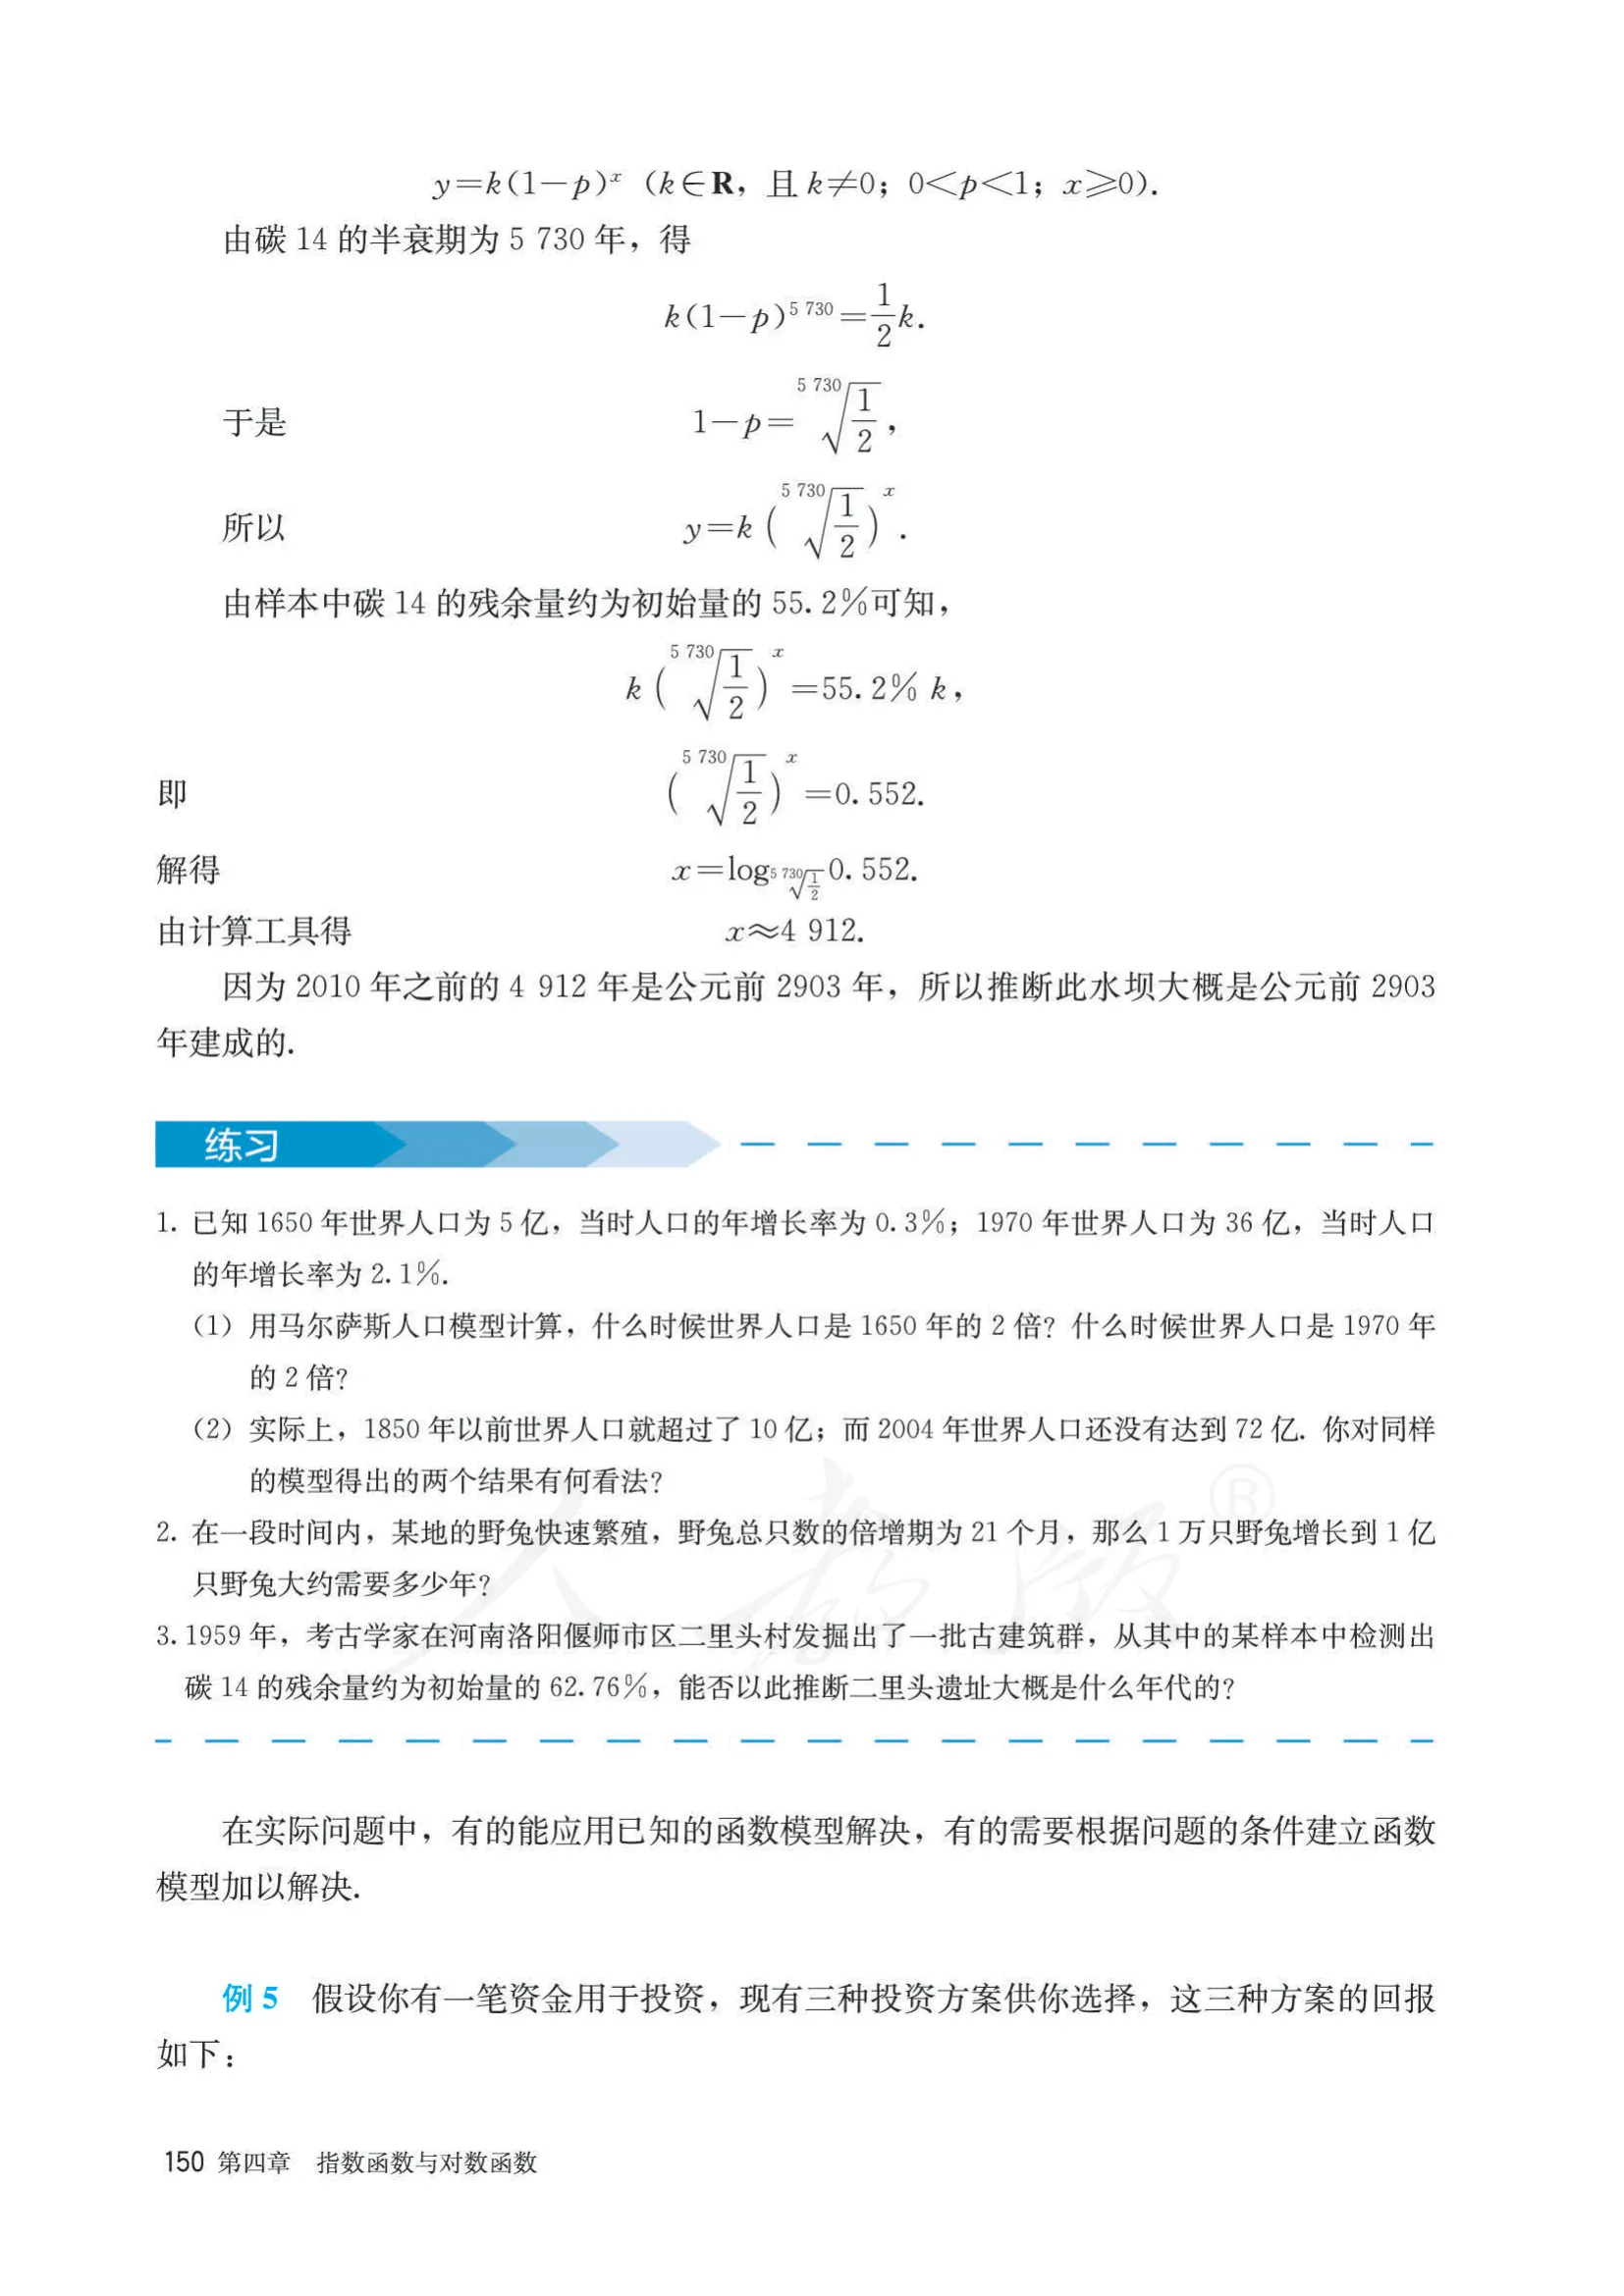
2010 年之前的 4912 年是公元前 2903 年——水坝大概是公元前 2903 年建成的。这就是考古学里碳 14 断代的完整流程:由半衰期定底数 → 由残留比例解指数方程 → 换算成年代。它和例 3 的区别在于:例 3 是”给定模型 + 两组数据求参数 rr“,例 4 是”模型结构(指数衰减)+ 物理常数(半衰期)直接定参数”。

三、增长差异与模型选择:例 5 投资方案

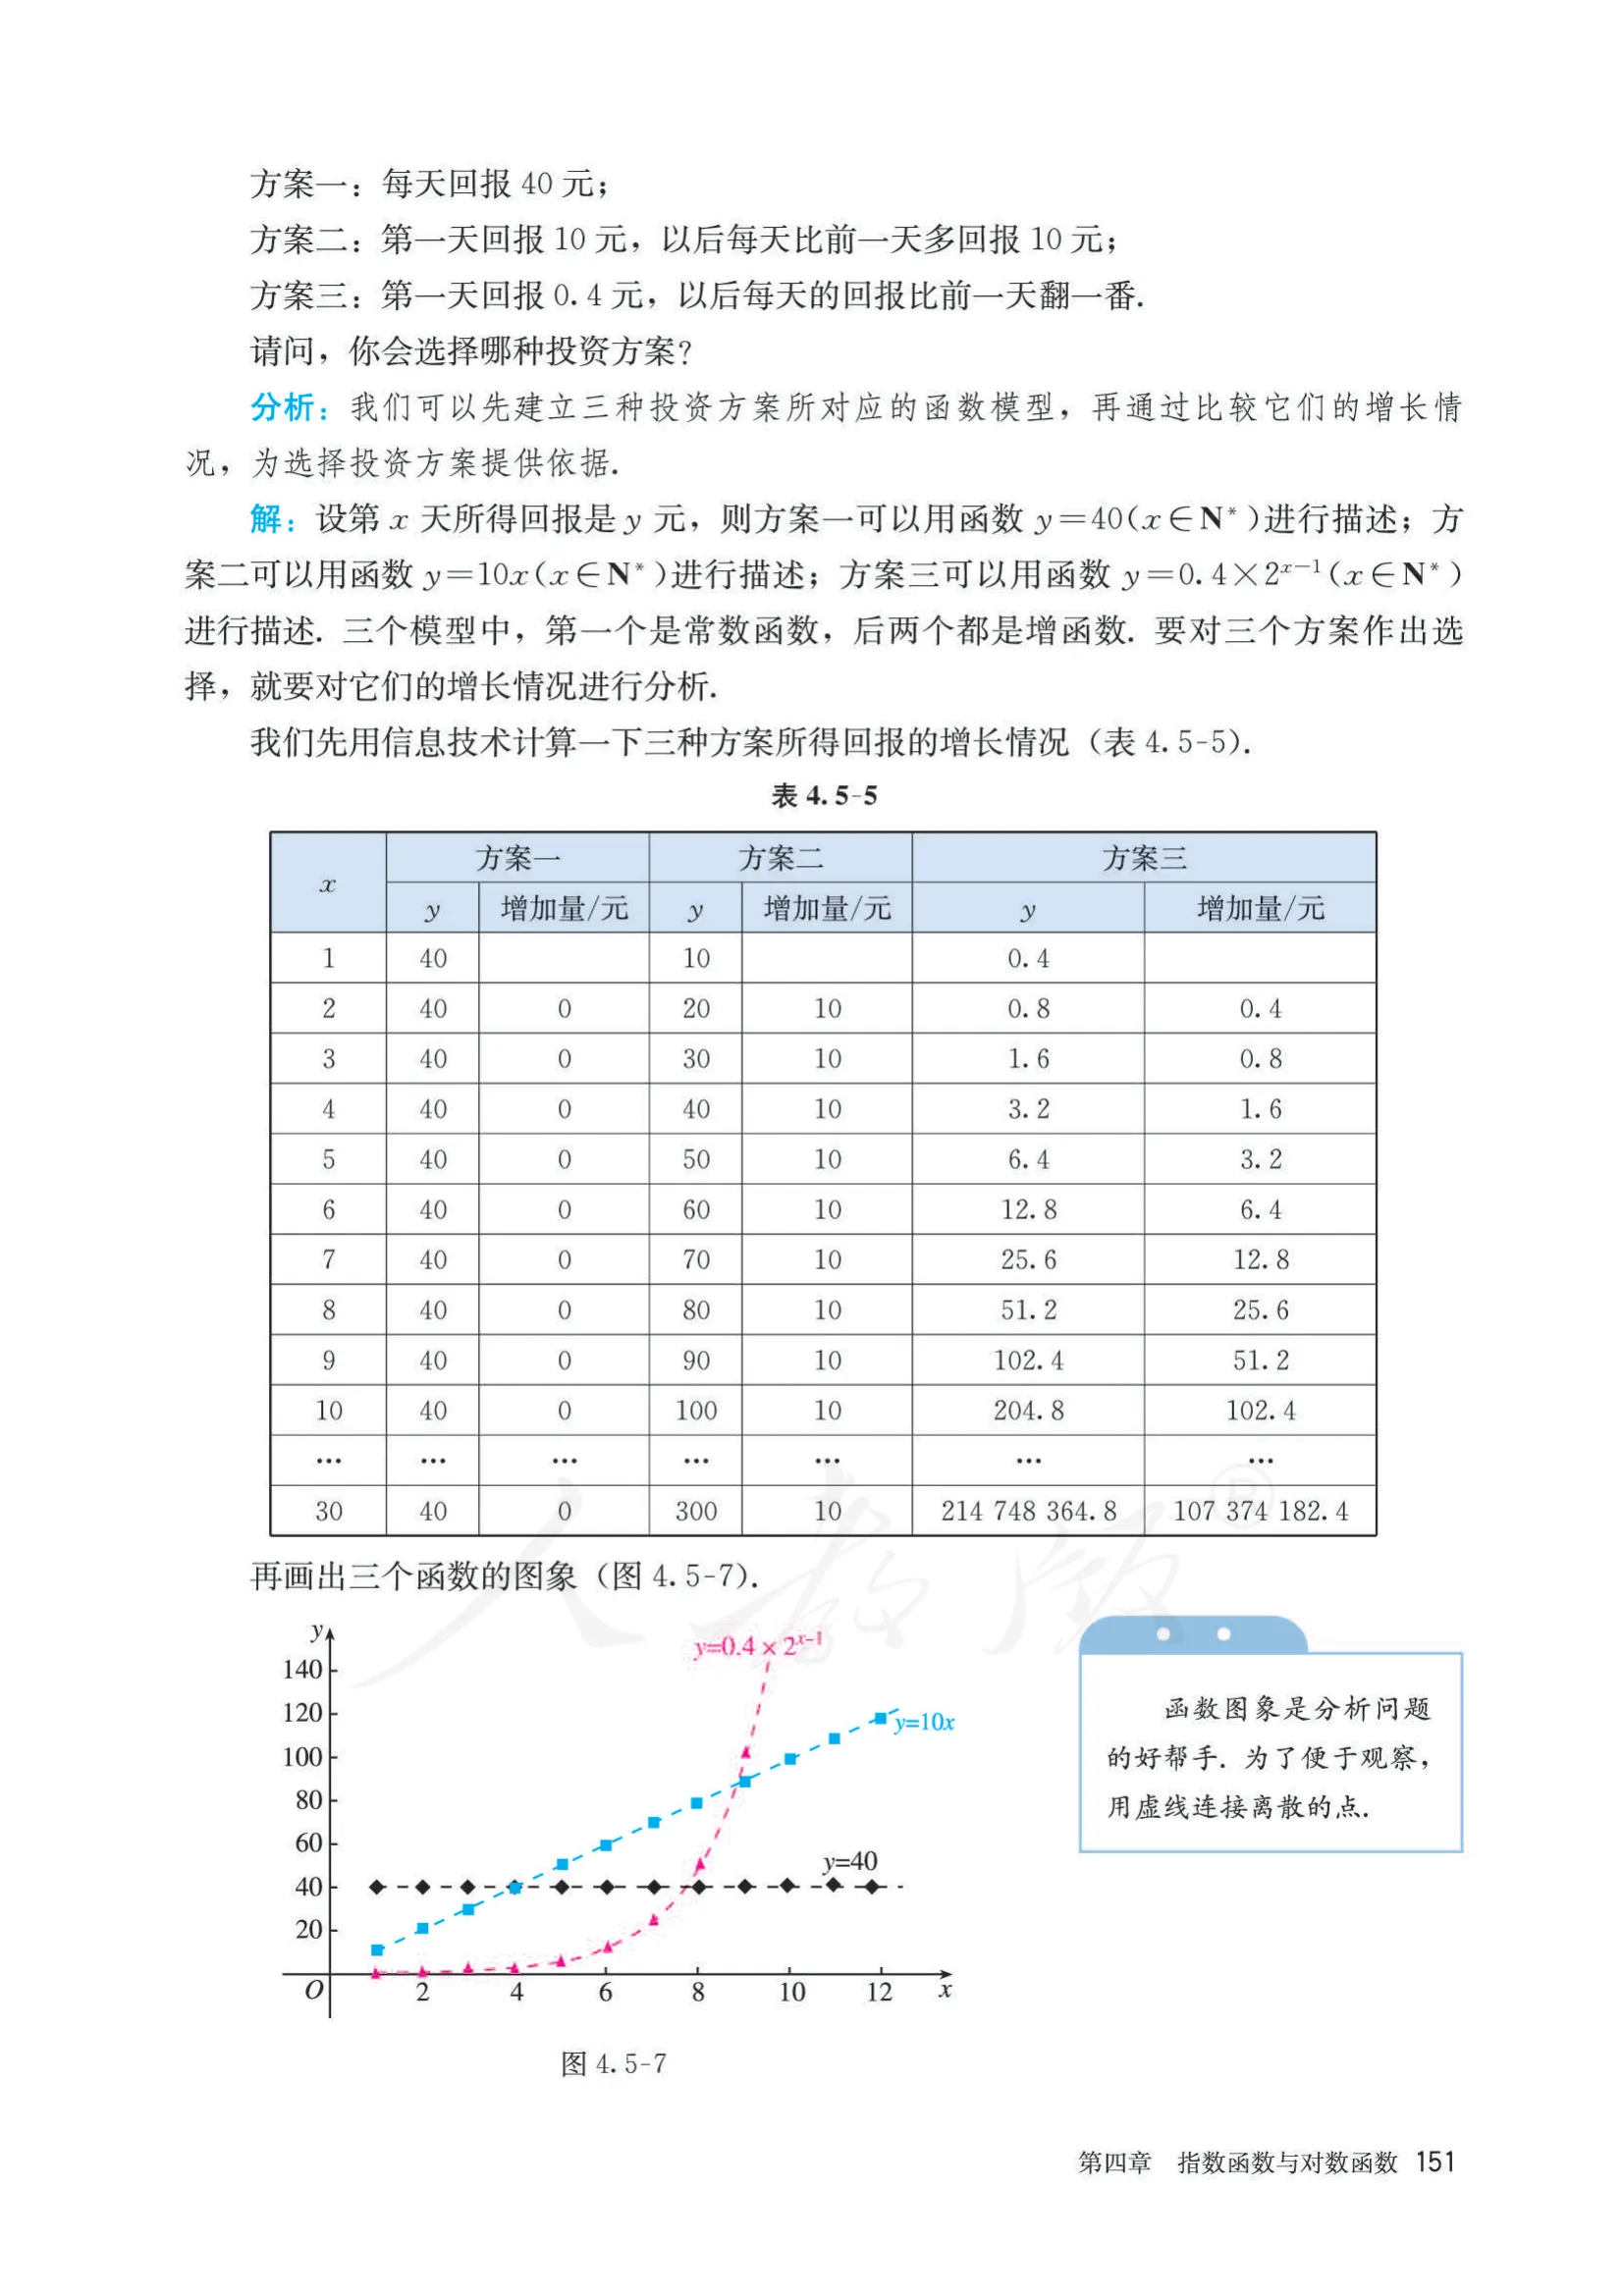
例 5 给三种投资方案:方案一每天回报 40 元(常数函数 y=40y = 40);方案二第一天 10 元,每天多 10 元(线性函数 y=10xy = 10x);方案三第一天 0.4 元,每天翻一番(指数函数 y=0.4×2x−1y = 0.4 \times 2^{x-1})。用表格和图象比较三者增长情况:

  • 每天所得回报:第 1~3 天方案一最多;第 4 天方案一、方案二一样多;第 5~8 天方案二最多;从第 9 天开始方案三比其他两个多得多,到第 30 天单日回报已超过 2 亿元;
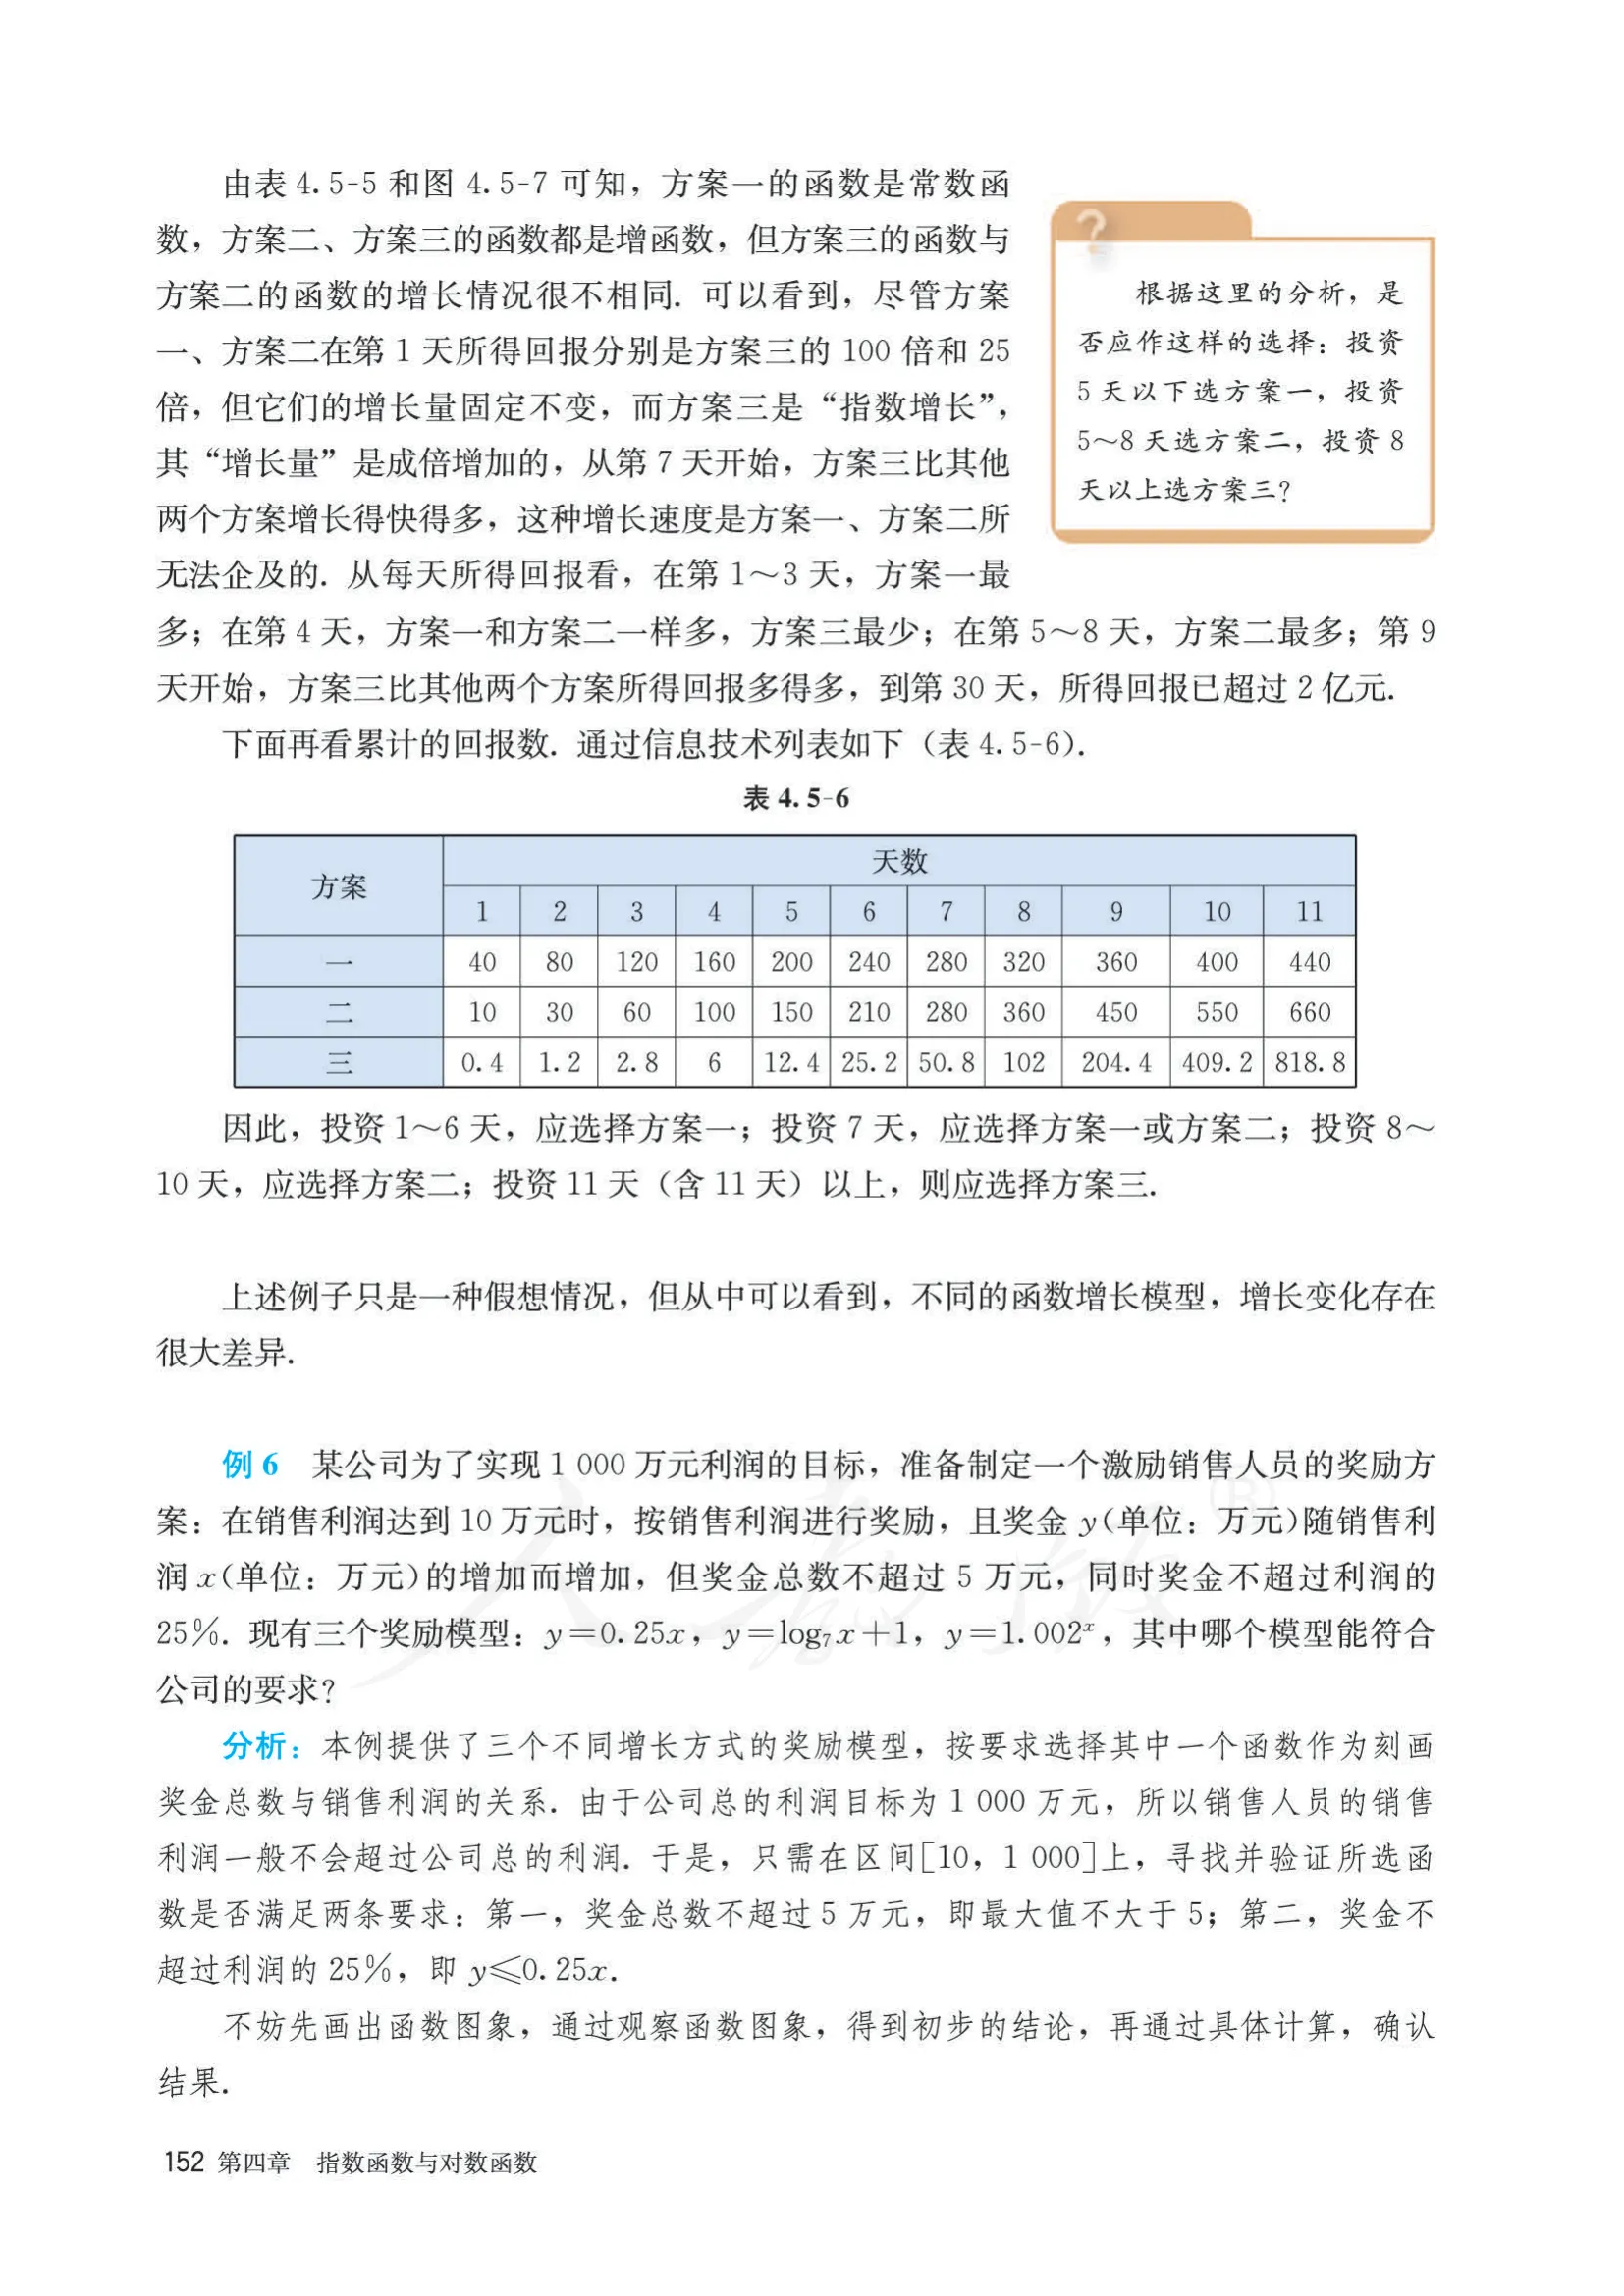
  • 累计回报:投资 1~6 天选方案一;第 7 天方案一或方案二;8~10 天选方案二;11 天(含)以上选方案三。

结论的关键是三种增长的增长方式不同:常数函数增长量为 0,线性函数增长量固定(每天多 10),指数函数”增长量成倍增加”。短期看线性、常数占优,长期看指数增长无出其右——这正是 §4.4.3”不同函数增长的差异”在应用中的体现。做题时这类”选方案”问题的标准流程:先列函数,再算增长(表 + 图),最后按投资时长分段下结论。

四、例 6 奖励模型:候选模型逐条验证

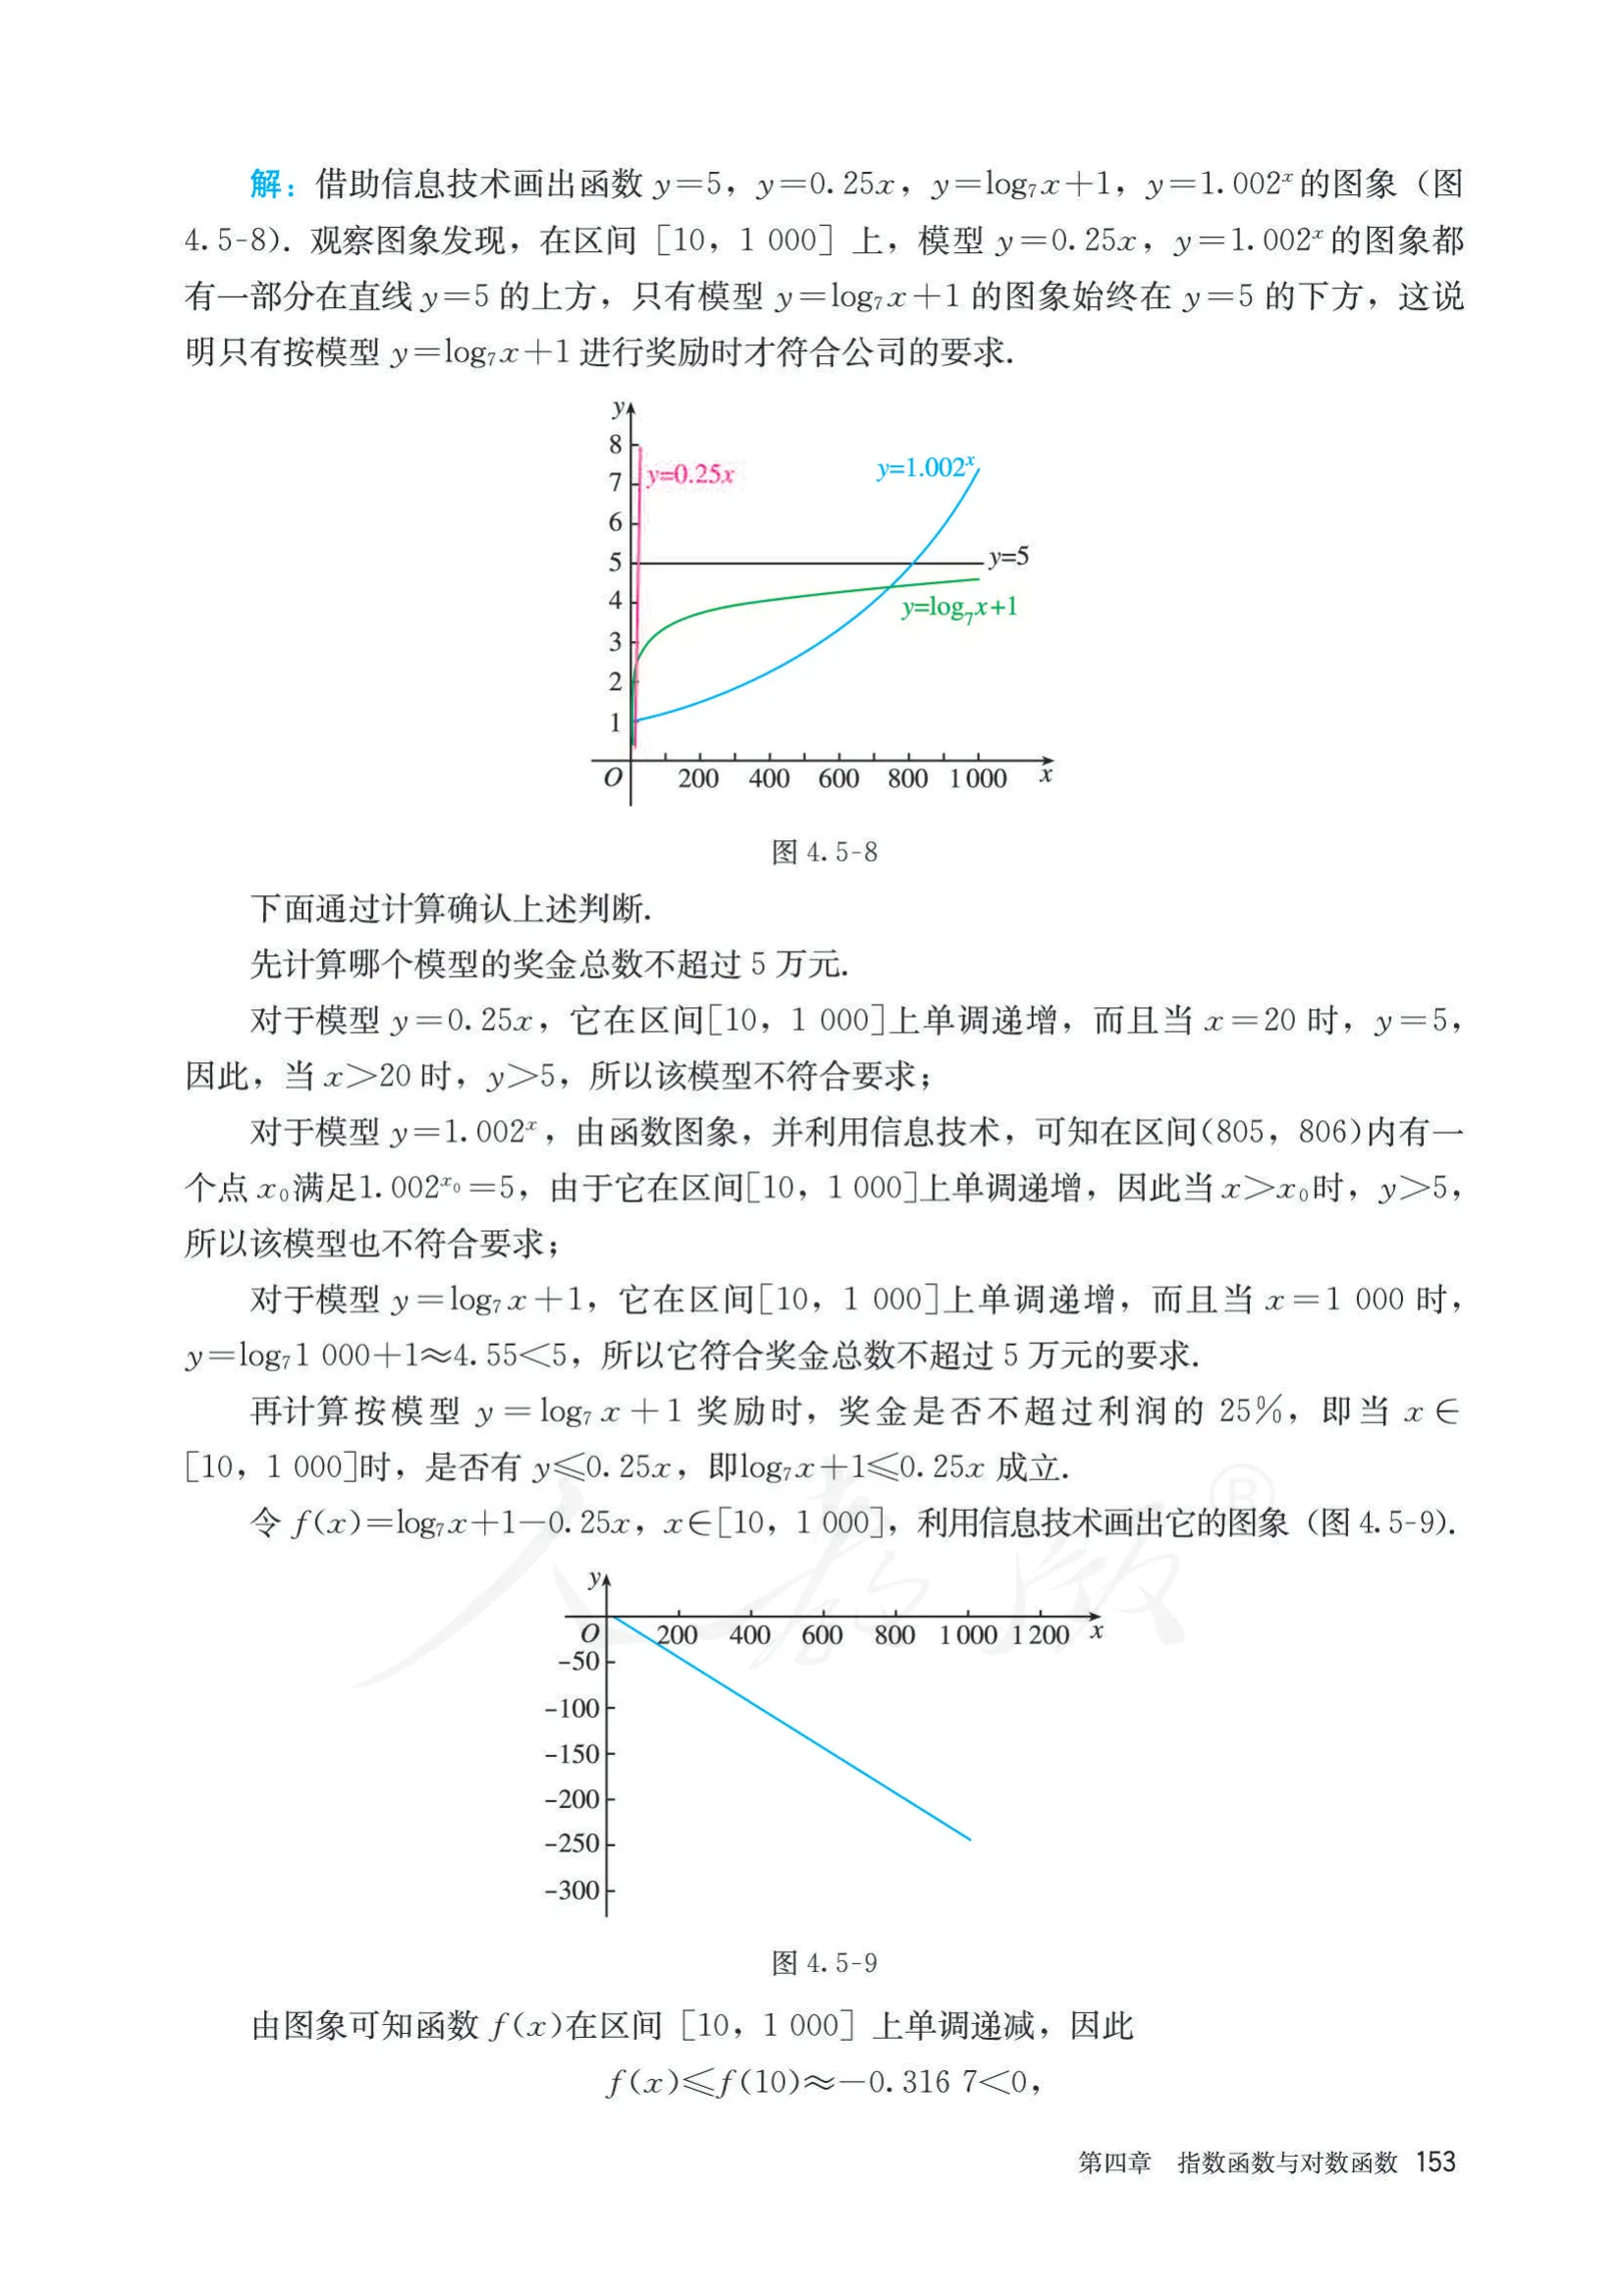
某公司规定:销售利润达到 10 万元后按利润奖励,奖金 yy(万元)随利润 xx(万元)增加而增加,且奖金不超过 5 万元、不超过利润的 25%。在三个候选模型 y=0.25xy = 0.25x、y=log⁡7x+1y = \log_7 x + 1、y=1.002xy = 1.002^x 中选一个,只需在区间 [10,1000][10, 1000] 上逐条验证:

  1. 奖金不超过 5 万元:y=0.25xy = 0.25x 在 x=20x = 20 时已等于 5,x>20x > 20 时超过 5,不合格;y=1.002xy = 1.002^x 在 (805,806)(805, 806) 内某点 x0x_0 满足 1.002x0=51.002^{x_0} = 5,之后超过 5,也不合格;y=log⁡7x+1y = \log_7 x + 1 单调递增,x=1000x = 1000 时 y=log⁡71000+1≈4.55<5y = \log_7 1000 + 1 \approx 4.55 < 5,合格;
  2. 奖金不超过利润的 25%:只需验证 log⁡7x+1⩽0.25x\log_7 x + 1 \leqslant 0.25x 对 x∈[10,1000]x \in [10, 1000] 恒成立。令 f(x)=log⁡7x+1−0.25xf(x) = \log_7 x + 1 - 0.25x,由图象(图 4.5-9)知 ff 在 [10,1000][10, 1000] 上单调递减,故 f(x)⩽f(10)≈−0.3167<0f(x) \leqslant f(10) \approx -0.3167 < 0,恒成立 ✓。

结论:y=log⁡7x+1y = \log_7 x + 1 是唯一满足公司要求的模型。这个例子的方法论:先看图排除(图象始终在 y=5y = 5 下方),再计算确认(端点值 + 单调性)——图象给方向,计算给证明。

五、建模的一般过程:归纳

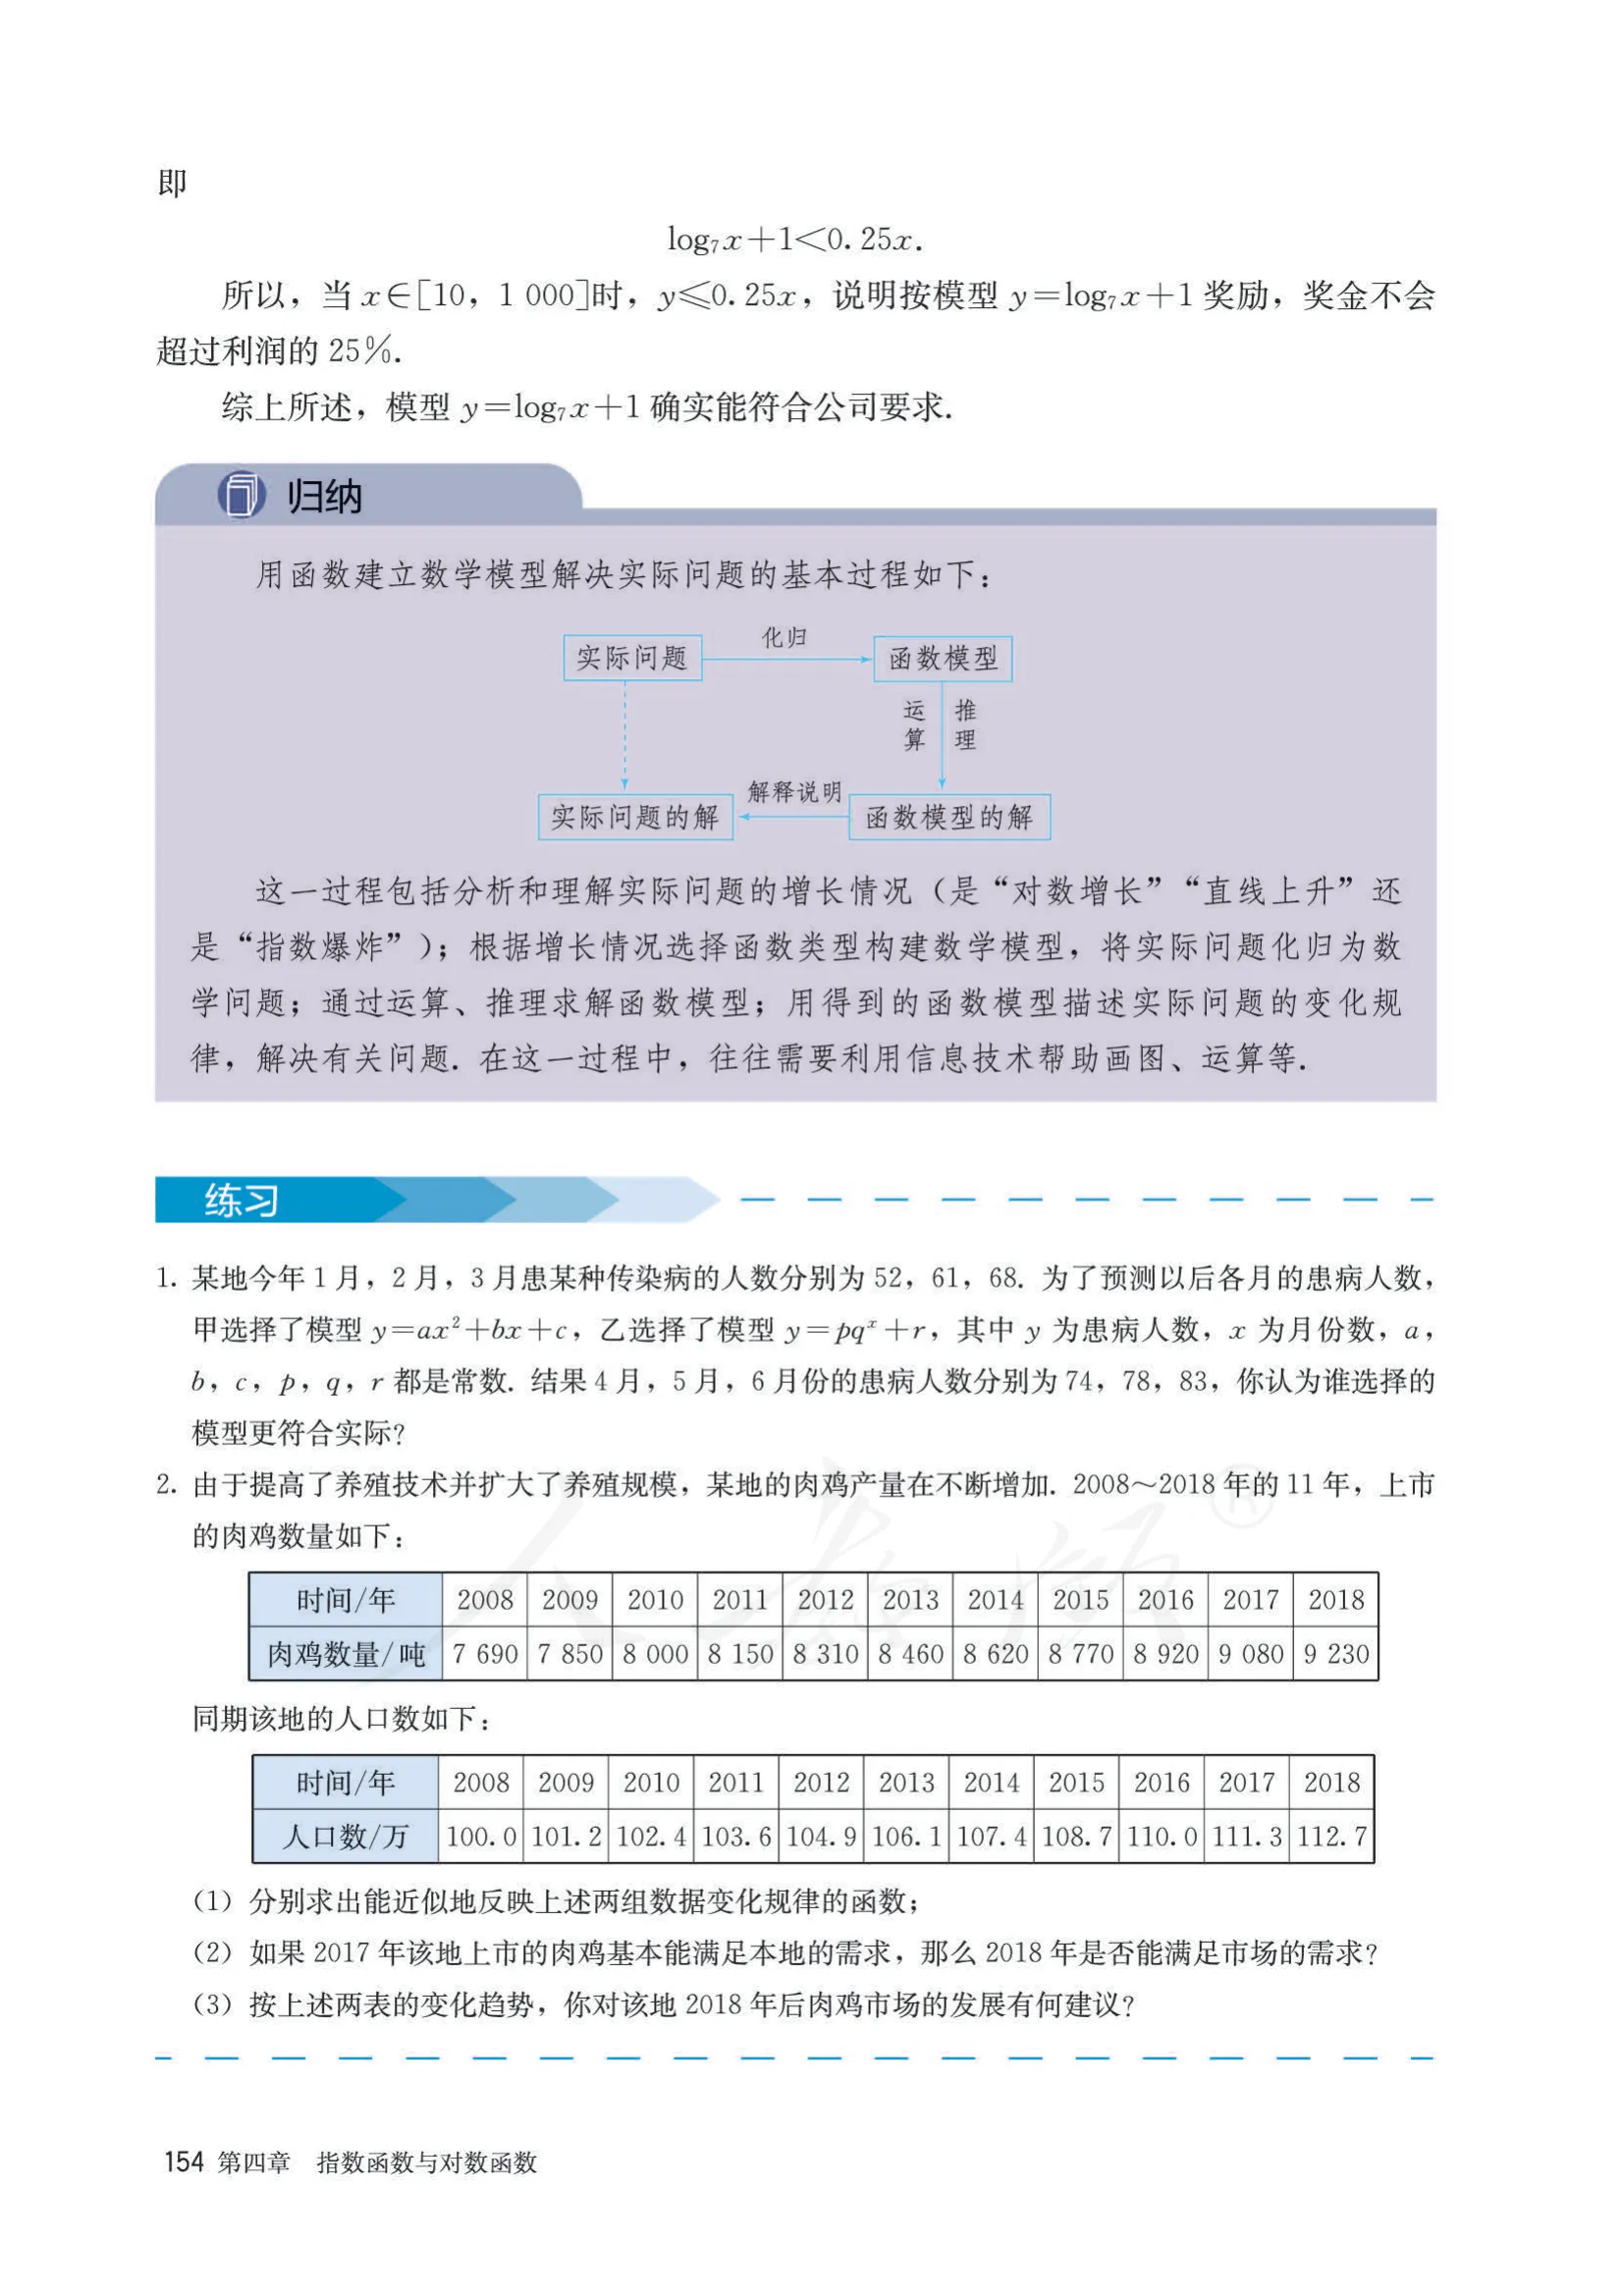
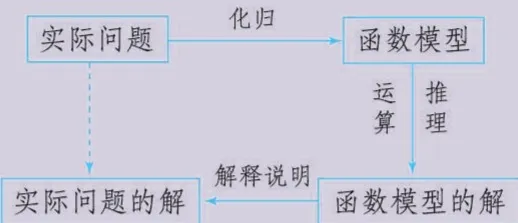
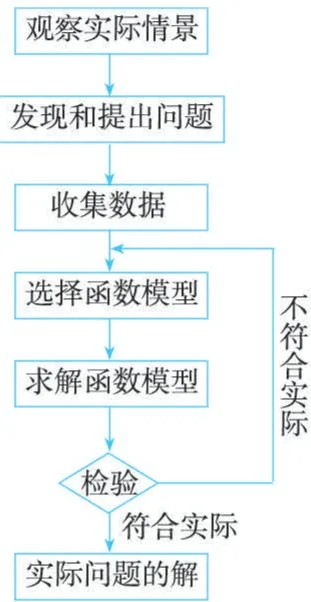
课本最后的”归纳”总结了用函数建立数学模型解决实际问题的基本过程(图 4.5-10):

实际情景→提出问题数学模型→数学方法数学结果→检验实际结果,\text{实际情景} \xrightarrow{\text{提出问题}} \text{数学模型} \xrightarrow{\text{数学方法}} \text{数学结果} \xrightarrow{\text{检验}} \text{实际结果},

具体拆成四步:

  1. 分析和理解实际问题:看清问题的增长情况是”对数增长”、“直线上升”还是”指数爆炸”(这决定了选什么函数);
  2. 构建数学模型:根据增长情况选择函数类型,把实际问题化归为数学问题(定自变量、因变量、初始条件);
  3. 求解函数模型:通过运算、推理求参数、求结果(例 3 解指数方程求 tt、例 4 用对数求 xx);
  4. 回到实际问题:用模型描述变化规律、解决有关问题,并注意模型的适用条件和结果检验(例 3 的”思考”就是第 4 步)。

这四步是高考”应用题”的标准骨架,也是新课标”数学建模”活动课的基本流程。期间常常需要信息技术帮忙画图、运算(指数方程、对数方程往往只能求近似解)。

六、易错点

  1. 单位换算:例 3 里 13 亿要换成 130000 万才能代入以万为单位的模型;tt 的单位(年、月、天)也要和题目对牢(练习第 2 题的倍增期是月、问的是年);
  2. 底数大于 1 还是小于 1:增长模型 y=y0erty = y_0 \mathrm{e}^{rt}(r>0r > 0)、y=abxy = ab^x(b>1b > 1)底数大于 1;衰减模型 y=k(1−p)xy = k(1-p)^x(0<1−p<10 < 1-p < 1)底数小于 1。碳 14 测年用衰减模型,别取反;
  3. 指数方程用对数解:ax=ba^x = b 形如方程两边取对数:x=log⁡abx = \log_a b;例 4 用”半衰期 5730 年”先定出底数 1/25730\sqrt[5730]{1/2},再解残留比例方程;
  4. 模型的适用条件:模型在”条件不变”的范围内才成立。人口模型因政策失效、投资方案因时长不同选择不同——下结论前先交代适用范围;
  5. 候选模型逐条验证:例 6 的两条要求都要验证(不超过 5 万、不超过利润 25%),只验证一条不够;验证”恒成立”要靠单调性把区间端点带到极值处(f(x)⩽f(10)f(x) \leqslant f(10)),不是只代一两个点看。

七、怎么读这一节

  1. 亲手把例 3 的 rr 算一遍(67207=55196e9r⇒r≈0.02187667207 = 55196\mathrm{e}^{9r} \Rightarrow r \approx 0.021876),再代入 y=130000y = 130000 解出 t≈39.15t \approx 39.15——指数方程两边的操作(取对数)要熟练;
  2. 例 4 完整走一遍碳 14 流程:半衰期 → 底数 → 残留比例 → 对数方程 → 换算年代(4912 年 → 公元前 2903 年);
  3. 例 5 亲手列三种方案的前几天回报并观察”从第几天起方案三反超”,体会指数增长的爆发力;
  4. 例 6 用单调性验证 log⁡7x+1⩽0.25x\log_7 x + 1 \leqslant 0.25x 的思路要背下来:最大值在端点 f(10)<0f(10) < 0;
  5. 背下建模四步,并用自己的话复述:分析增长 → 选函数建模型 → 求解 → 检验回到实际。

这一节是第 4 章的收尾:前三节给了”零点存在定理 + 二分法”两个工具,这一节把整个”函数”概念放回现实世界——函数是描述客观世界变化规律的数学模型,也是全章(乃至整个必修一函数主线)的落点。下一章”三角函数”把函数家族扩展到周期性变化。

习题详解(本站解答,无官方答案可核)

人教 A 版学生用书不含答案,教师用书与全解不在本站语料里——因此本节习题的解答无官方答案可核,它们是本站写的。每一道都过了独立 verifier 的 refute 优先复核(默认它有问题,找不出问题才放行),但那不等于官方标准答案:拿它对思路,别拿它对分。

本节页面覆盖第 155–163 页,课本习题共 19 道:第 157 页「练习」3 道、第 161 页「练习」2 道、「习题 4.5」14 道(复习巩固 1–6、综合运用 7–12、拓广探索 13–14),逐题全做。第 164 页起「文献阅读与数学写作(牛顿冷却模型)」及章末「小结」「复习参考题 4」是章级内容,不在本节详解范围。练习第 2 题的两张数据表、习题第 2 题的对应值表、第 12 题和第 14 题的数据表都在页面插图中,解答按表读出(注明课本页码)。每道题先逐字引课本的题面(引用块),再写解答。

练习(第 157 页)第 1 题

  1. 已知 1650 年世界人口为 5 亿,当时人口的年增长率为 0.3%;1970 年世界人口为 36 亿,当时人口的年增长率为 2.1%.

(1)用马尔萨斯人口模型计算,什么时候世界人口是1650年的2倍?什么时候世界人口是1970年的2倍?

(2)实际上,1850年以前世界人口就超过了10亿;而2004年世界人口还没有达到72亿。你对同样的模型得出的两个结果有何看法?

(1) 马尔萨斯模型 y=y0erty = y_0\mathrm{e}^{rt}。1650 年 y0=5y_0 = 5(亿),r=0.3%=0.003r = 0.3\% = 0.003,人口达到 2 倍即 y=10y = 10:

10=5e0.003t⇒0.003t=ln⁡2⇒t=ln⁡20.003≈231(年),10 = 5\mathrm{e}^{0.003t} \Rightarrow 0.003t = \ln 2 \Rightarrow t = \frac{\ln 2}{0.003} \approx 231 \text{(年)},

即约在 1650 年后的第 231 年,即 1881 年左右世界人口达到 10 亿。

1970 年 y0=36y_0 = 36(亿),r=2.1%=0.021r = 2.1\% = 0.021,达到 2 倍即 y=72y = 72:

72=36e0.021t⇒t=ln⁡20.021≈33(年),72 = 36\mathrm{e}^{0.021t} \Rightarrow t = \frac{\ln 2}{0.021} \approx 33 \text{(年)},

即约在 1970 年后的第 33 年,即 2003 年左右世界人口达到 72 亿。

(2) 看法:同一模型套在不同时期的初始条件上,得到了两个与事实都不完全相符的预测——实际 1850 年以前世界人口就超过了 10 亿(比模型预测的 1881 年早 30 多年),而 2004 年世界人口还没达到 72 亿(比模型预测的 2003 年晚)。这说明马尔萨斯模型(假设增长率恒定)不能精确刻画世界人口长期变化:1650~1850 年间的实际增长比 0.3%/年更快,1970 年后的实际增长又比 2.1%/年更慢。模型的适用条件(增长率恒定)决定了它只适用于局部时段,把同一模型外推到几十年甚至上百年之外,误差会不断累积。

自检:ln⁡2≈0.6931\ln 2 \approx 0.6931:0.6931/0.003=231.050.6931/0.003 = 231.05,0.6931/0.021=33.010.6931/0.021 = 33.01,与答案一致。这两个”差半年”的巧合(231 年 → 1881 年、33 年 → 2003 年)恰好都是”约半个世纪前后”,正是题目第 (2) 问想让你意识到的问题:模型是近似工具,不是精确预言。

练习(第 157 页)第 2 题

  1. 在一段时间内,某地的野兔快速繁殖,野兔总只数的倍增期为 21 个月,那么 1 万只野兔增长到 1 亿只野兔大约需要多少年?

“倍增期为 21 个月”即每 21 个月总数翻一番,指数模型为 y=104×2t/21y = 10^4 \times 2^{t/21}(tt 单位:月)。令 y=108y = 10^8:

104×2t/21=108⇒2t/21=104⇒t21=log⁡2104=4log⁡210,10^4 \times 2^{t/21} = 10^8 \Rightarrow 2^{t/21} = 10^4 \Rightarrow \frac{t}{21} = \log_2 10^4 = 4\log_2 10, t=21×4log⁡210=84×ln⁡10ln⁡2≈84×3.3219≈279(月),t = 21 \times 4\log_2 10 = 84 \times \frac{\ln 10}{\ln 2} \approx 84 \times 3.3219 \approx 279 \text{(月)},

279279 个月 =23.25= 23.25 年,所以大约需要 23 年。

自检:log⁡2104≈13.29\log_2 10^4 \approx 13.29,21×13.29≈27921 \times 13.29 \approx 279 个月 ≈ 23 年。换一种验算:21 个月翻一番,23 年 =276= 276 个月 ≈ 1313 个倍增期,104×213=8.2×10710^4 \times 2^{13} = 8.2 \times 10^7 已接近 10810^8,量级吻合。注意月份换算成年要除以 12,别直接拿 279 当年数。

练习(第 157 页)第 3 题

3.1959年,考古学家在河南洛阳偃师市区二里头村发掘出了一批古建筑群,从其中的某样本中检测出碳14的残余量约为初始量的 62.76%62.76\% ,能否以此推断二里头遗址大概是什么年代的?

仿照例 4 的碳 14 断代流程。碳 14 半衰期为 5730 年,残留量 y=k(125730)xy = k\left(\sqrt[5730]{\frac12}\right)^x。残留量为初始量的 62.76%62.76\%:

(125730)x=0.6276⇒x=log⁡1/257300.6276=ln⁡0.6276ln⁡12×5730,\left(\sqrt[5730]{\frac12}\right)^x = 0.6276 \Rightarrow x = \log_{\sqrt[5730]{1/2}} 0.6276 = \frac{\ln 0.6276}{\ln \frac12} \times 5730, ln⁡0.6276ln⁡0.5=−0.4658−0.6931≈0.6721,x≈0.6721×5730≈3851(年).\frac{\ln 0.6276}{\ln 0.5} = \frac{-0.4658}{-0.6931} \approx 0.6721, \quad x \approx 0.6721 \times 5730 \approx 3851 \text{(年)}.

1959 年之前的约 3851 年是约公元前 1893 年,所以推断二里头遗址大概是 公元前 1900 年左右(约 3800 多年前)建成的,与考古学界公认的二里头遗址年代(约公元前 1900—前 1600 年)相符。

自检:残留比例越大说明年代越近:62.76%>55.2%62.76\% > 55.2\%(例 4 良渚的残留量),所以二里头应比良渚水坝(公元前 2903 年)晚,约公元前 1893 年晚于公元前 2903 年 ✓。也可验算反推:公元前 1893 年距今约 1893−1+1959=38511893 - 1 + 1959 = 3851 年,残留量 0.53851/5730=0.50.672≈0.62760.5^{3851/5730} = 0.5^{0.672} \approx 0.6276 ✓。注意”公元前 N 年”换算:年份差要减 1(公元纪年没有 0 年),课本例 4 的 2010 − 4912 得公元前 2903 年也是这么来的。

练习(第 161 页)第 1 题

  1. 某地今年1月,2月,3月患某种传染病的人数分别为52,61,68. 为了预测以后各月的患病人数,甲选择了模型 y=ax2+bx+cy = ax^{2} + bx + c,乙选择了模型 y=pqx+ry = pq^{x} + r,其中 yy 为患病人数, xx 为月份数, aa, bb, cc, pp, qq, rr 都是常数. 结果4月,5月,6月份的患病人数分别为74,78,83,你认为谁选择的模型更符合实际?

令 x=1,2,3x = 1, 2, 3 对应 1、2、3 月,y=52,61,68y = 52, 61, 68。

甲的二次模型:{a+b+c=524a+2b+c=619a+3b+c=68\begin{cases} a + b + c = 52 \\ 4a + 2b + c = 61 \\ 9a + 3b + c = 68 \end{cases}。两两相减得 3a+b=93a + b = 9、5a+b=75a + b = 7,解得 a=−1a = -1,b=12b = 12,c=41c = 41,即 y=−x2+12x+41y = -x^2 + 12x + 41。代入 4、5、6 月(x=4,5,6x = 4, 5, 6):y(4)=−16+48+41=73y(4) = -16 + 48 + 41 = 73,y(5)=−25+60+41=76y(5) = -25 + 60 + 41 = 76,y(6)=−36+72+41=77y(6) = -36 + 72 + 41 = 77。与实际 74、78、83 相比,偏差为 1、2、6。

乙的指数模型:pq+r=52pq + r = 52,pq2+r=61pq^2 + r = 61,pq3+r=68pq^3 + r = 68。两两相减得 pq(q−1)=9pq(q - 1) = 9、pq2(q−1)=7pq^2(q - 1) = 7,相除得 q=79q = \frac79,代回得 pq=9q−1=−812pq = \frac{9}{q-1} = -\frac{81}{2},p=pq÷q=−812×97=−72914p = pq \div q = -\frac{81}{2} \times \frac97 = -\frac{729}{14},r=68−pq3=68+72914×343729=68+492=1852r = 68 - pq^3 = 68 + \frac{729}{14} \times \frac{343}{729} = 68 + \frac{49}{2} = \frac{185}{2}。预测:y(4)=pq4+r=−34318+1852≈73.4y(4) = pq^4 + r = -\frac{343}{18} + \frac{185}{2} \approx 73.4,y(5)=pq5+r=−2401162+1852≈77.7y(5) = pq^5 + r = -\frac{2401}{162} + \frac{185}{2} \approx 77.7,y(6)=pq6+r=−168071458+1852≈81.0y(6) = pq^6 + r = -\frac{16807}{1458} + \frac{185}{2} \approx 81.0,偏差为 0.6、0.3、2.0。

比较两种模型的预测误差:对 4、5、6 三个月,甲模型偏差总和 1+2+6=91 + 2 + 6 = 9,乙模型偏差总和 0.6+0.3+2.0≈2.90.6 + 0.3 + 2.0 \approx 2.9——乙的模型更符合实际。

自检:两个模型都由 1~3 月的三点唯一确定(二次三参数、指数三参数),所以比较的是”外推能力”。甲模型预测 73/76/7773/76/77,到 6 月明显跟不上实际 83(偏差 6);乙模型 q=79<1q = \frac79 < 1 意味着患病人数增长放缓、趋向稳定值 1852=92.5\frac{185}{2} = 92.5,预测 73.4/77.7/81.073.4/77.7/81.0 与实际 74/78/8374/78/83 几乎逐月贴近——增长放缓的趋势正与 4~6 月实际相符(68 → 74 → 78 → 83 增量 6、4、5 在放缓),所以乙更优。这个结论与课本标准答案一致:指数模型描述”增速放缓、趋向饱和”的传染病传播,比二次模型贴切。注意 y(6)=81.0y(6) = 81.0 与实际 83 仍差 2.0,两个模型都不完美——题目只要求”更符合实际”,相对更好即可。

练习(第 161 页)第 2 题

  1. 由于提高了养殖技术并扩大了养殖规模,某地的肉鸡产量在不断增加。2008~2018年的11年,上市的肉鸡数量如下:

同期该地的人口数如下:

(1)分别求出能近似地反映上述两组数据变化规律的函数;

(2)如果2017年该地上市的肉鸡基本能满足本地的需求,那么2018年是否能满足市场的需求?

(3)按上述两表的变化趋势,你对该地2018年后肉鸡市场的发展有何建议?

题面附表(课本第 161 页):

时间/年20082009201020112012201320142015201620172018
肉鸡数量/吨76907850800081508310846086208770892090809230
时间/年20082009201020112012201320142015201620172018
人口数/万100.0101.2102.4103.6104.9106.1107.4108.7110.0111.3112.7

(1) 设 xx 为年份与 2008 的差(x=0,1,…,10x = 0, 1, \dots, 10 对应 2008~2018)。

肉鸡数量:每年增加量基本恒定(7690 → 7850 增 160,7850 → 8000 增 150,之后每年增 150 或 160),可用线性函数近似。取首尾两点定斜率:9230−769010=154\frac{9230 - 7690}{10} = 154,得

y=154x+7690(x∈[0,10]).y = 154x + 7690 \quad (x \in [0, 10]).

检验中间点:x=9x = 9(2017 年)时 y=154×9+7690=9076≈9080y = 154 \times 9 + 7690 = 9076 \approx 9080,与实际数据很接近。

人口数:每年增长比例基本恒定(101.2/100.0 ≈ 101.6/101.2 ≈ 103.6/102.4 ≈ 1.012),可用指数函数近似:

y=100×1.012x(x∈[0,10]).y = 100 \times 1.012^{x} \quad (x \in [0, 10]).

检验:100×1.0121=101.2100 \times 1.012^1 = 101.2,100×1.0122=102.4100 \times 1.012^2 = 102.4,100×1.0123=103.6100 \times 1.012^3 = 103.6,100×1.0129=111.3100 \times 1.012^9 = 111.3,100×1.01210=112.7100 \times 1.012^{10} = 112.7——与表中 11 个数据几乎全部吻合。

(2) 用”人均肉鸡量”衡量供需。2017 年:9080111.3≈81.6\frac{9080}{111.3} \approx 81.6(吨/万人);2018 年:9230112.7≈81.9\frac{9230}{112.7} \approx 81.9(吨/万人)。2018 年人均肉鸡量比 2017 年略高,而题设 2017 年已基本满足本地需求,所以 2018 年能继续满足市场的需求。

(3) 建议(开放,答出要点即可):肉鸡产量年增约 1547690≈2.0%\frac{154}{7690} \approx 2.0\%,人口年增约 1.2%,产量增速持续快于人口增速,人均肉鸡量逐年上升——2018 年后如不控制扩产速度,市场将出现供过于求;建议适度控制养殖规模扩张,或开拓外地市场、发展加工产业链,保持供需平衡。

自检:两个模型的选型依据是”变化量”:肉鸡每年增加的量基本固定(150~160 吨/年)→ 线性;人口每年增加的倍数基本固定(约 1.2%)→ 指数。这是 §4.4.3”直线上升 vs 指数增长”的直接应用。第 (2) 问的精确计算:9080/111.3=81.589080/111.3 = 81.58,9230/112.7=81.909230/112.7 = 81.90,2018 年人均略增 ✓。若只看总量(9230 > 9080)也得”能满足”的结论,但用人均才严谨——人口也在增长。

习题 4.5 第 1 题(复习巩固)

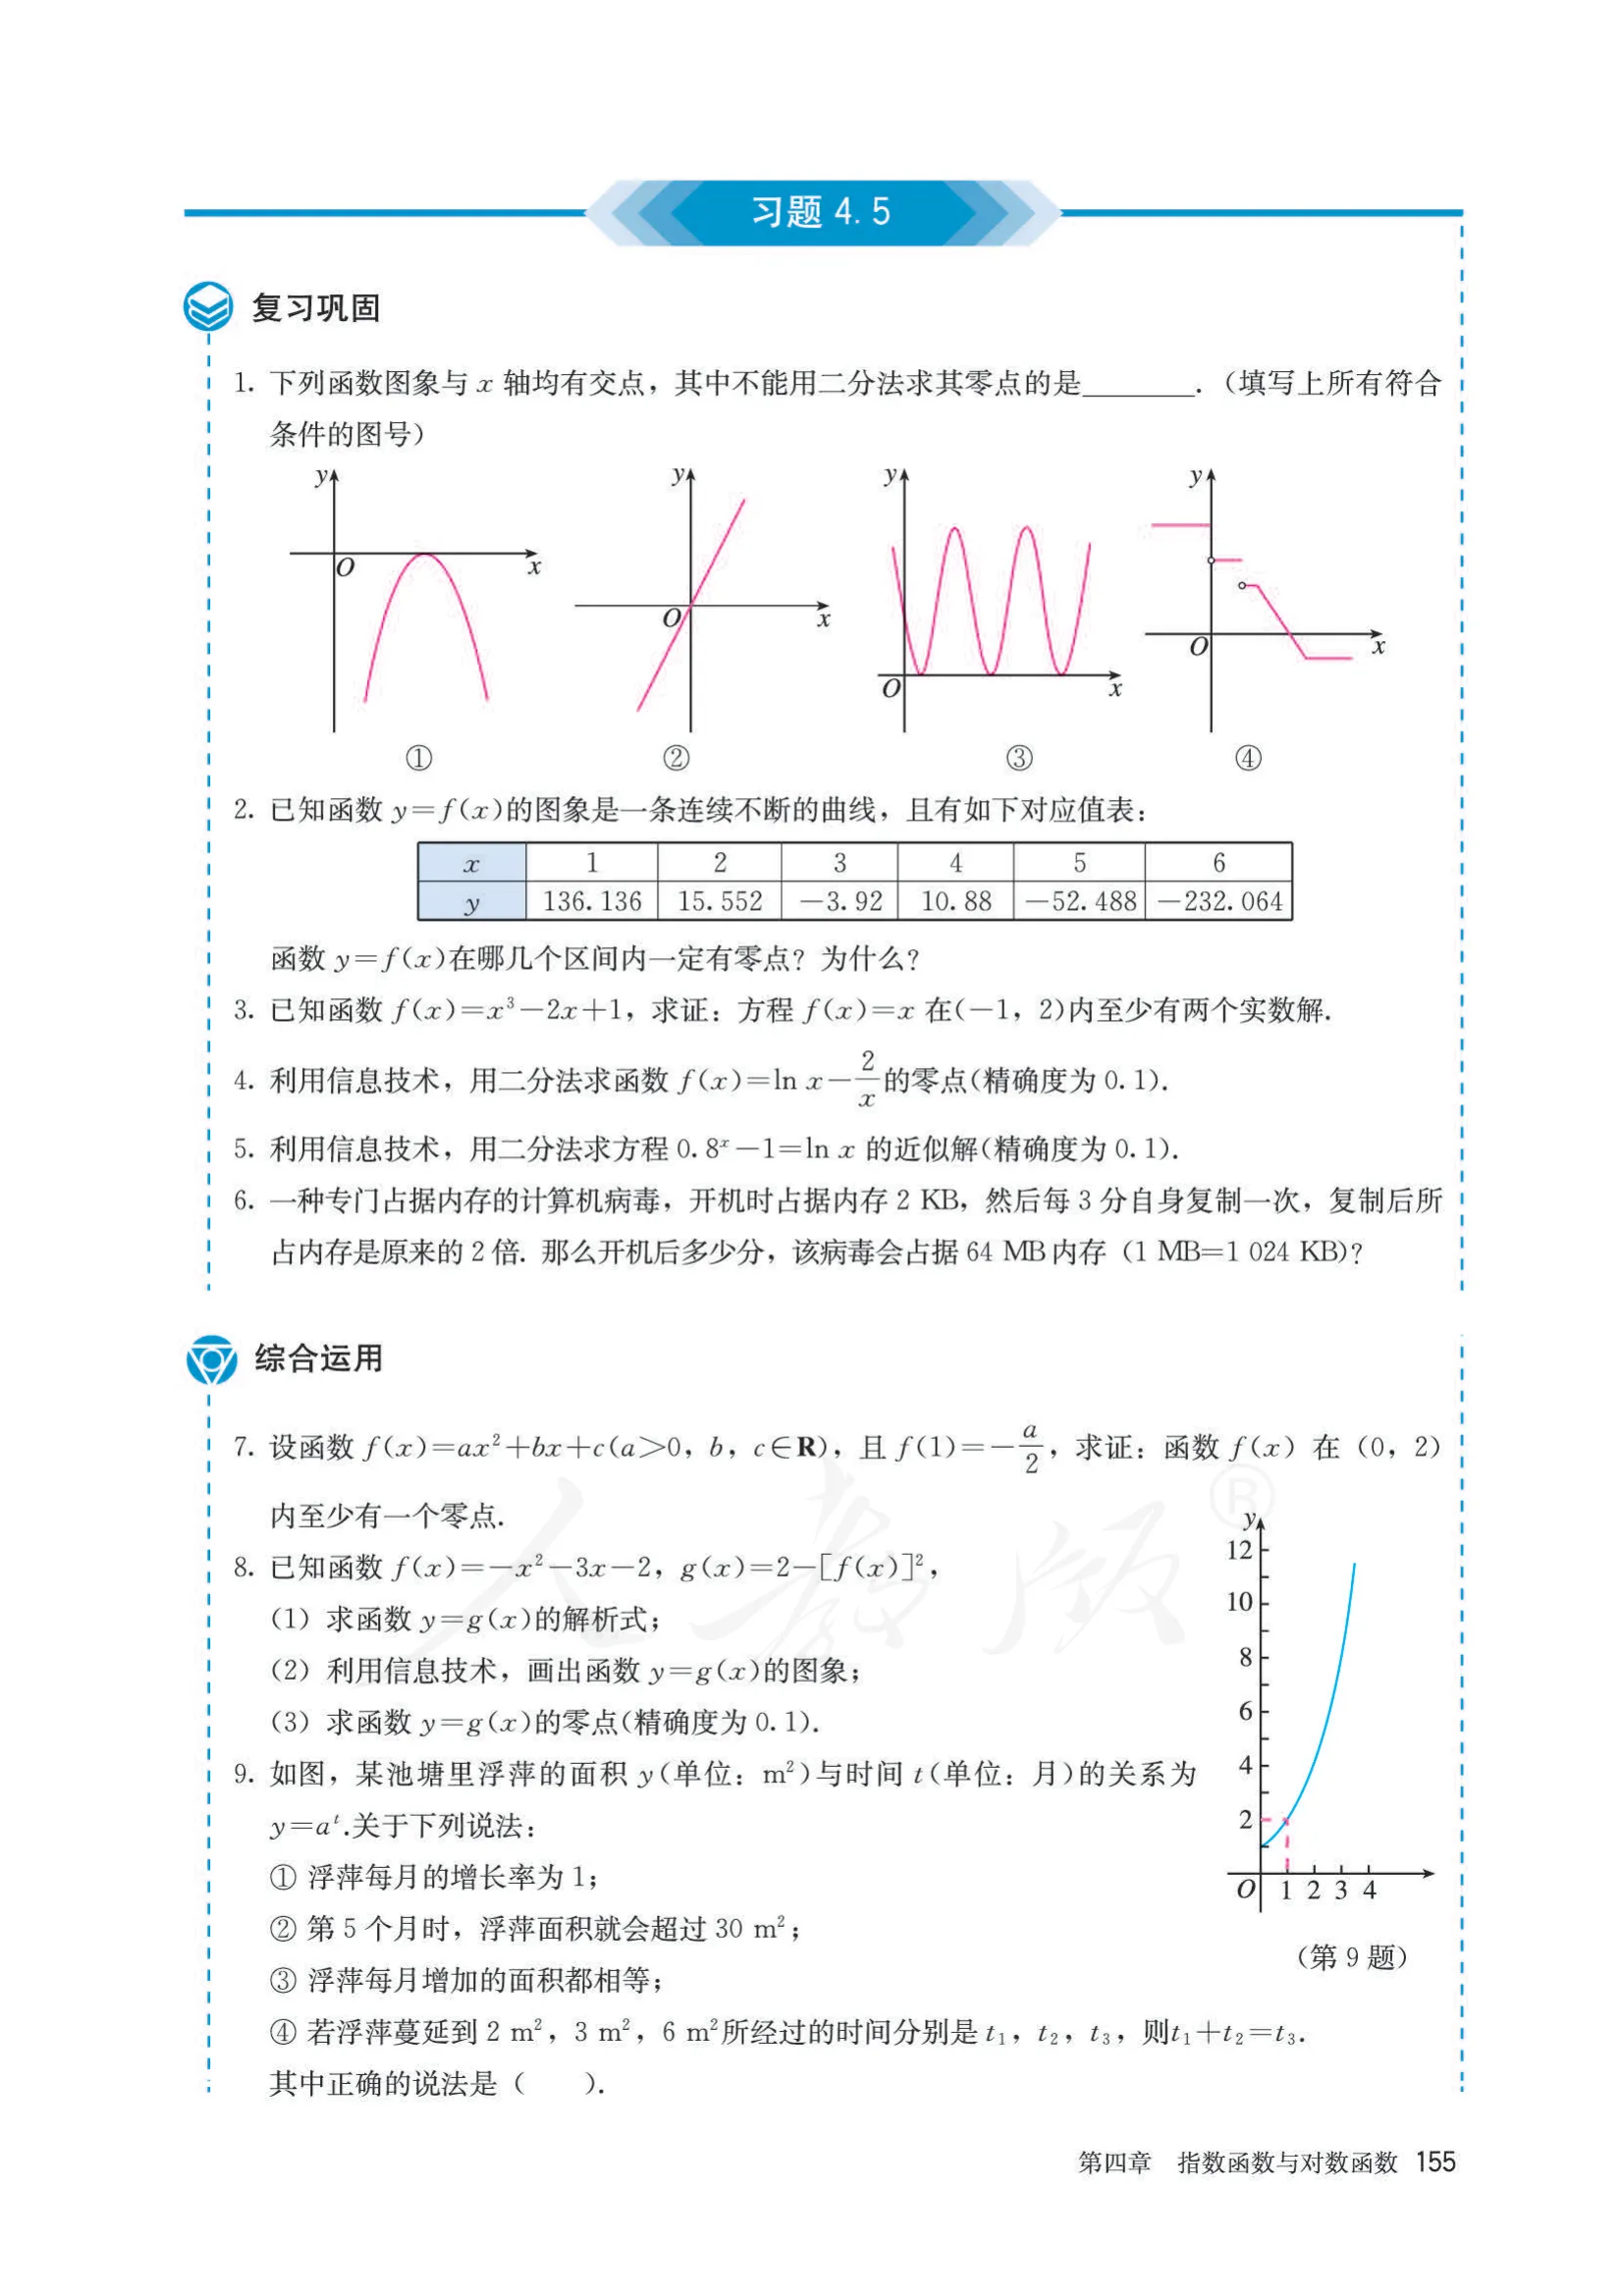
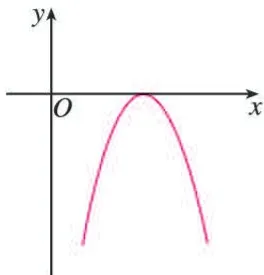
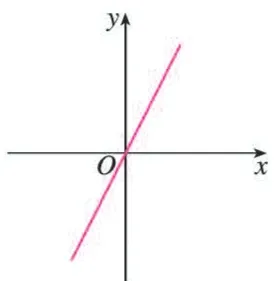
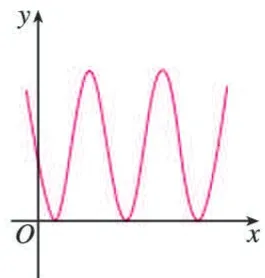
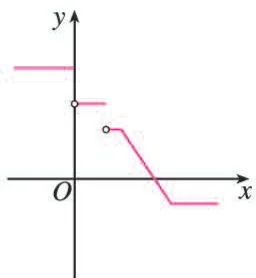
  1. 下列函数图象与 xx 轴均有交点, 其中不能用二分法求其零点的是____. (填至上所有符合条件的图号)

题面附图(课本第 162 页)四个图:① 开口向下的抛物线,顶点与 xx 轴相切(只接触、不穿过,零点两侧函数值不变号);② 过原点的直线,穿过 xx 轴一次(零点处变号);③ 波浪形曲线,与 xx 轴相切三次(均只接触不穿过,图象恒在 xx 轴上方,函数值不变号);④ 分段折线,有两处跳跃间断点(空心圈标记),其中一段穿过 xx 轴一次。

二分法要求两条前提:图象在区间上连续不断、区间端点函数值异号(f(a)f(b)<0f(a)f(b) < 0)。逐图判断:

  • 图①:零点处函数值不变号(顶点相切,两侧同号),任何区间两端同号,无法用 f(a)f(b)<0f(a)f(b) < 0 确定零点区间 → 不能用二分法;
  • 图②:连续且零点处变号,取 a<0<ba < 0 < b 即有 f(a)f(b)<0f(a)f(b) < 0 → 能用二分法;
  • 图③:与图①同理,三个零点都是切点,函数值始终不变号 → 不能用二分法;
  • 图④:图象不连续(有跳跃间断点),不满足二分法”图象连续不断”的前提 → 不能用二分法。

所以答案是 ①③④。

自检:二分法的两个前提缺一不可——①③ 死在”不变号”(图象与 xx 轴相切,零点存在但区间端点永远同号),④ 死在”不连续”(零点存在且变号,但二分法只对连续函数保证逼近)。② 的直线”穿过” xx 轴变号且连续,是唯一能用的。填”至上”即”填上”(原书排印如此,题目要求填所有符合条件的图号)。

习题 4.5 第 2 题(复习巩固)

函数 y=f(x)y = f(x) 在哪几个区间内一定有零点?为什么?

(课本原题题号因版面原因未印出,题面为完整第 2 题。)题面附表(课本第 162 页)——函数 y=f(x)y = f(x) 的对应值表:

x123456
y136.13615.552-3.9210.88-52.488-232.064

前提说明:本题只给对应值表,题面没有出现”图象连续不断”的字样。零点存在定理有两条前提——图象连续不断、端点函数值异号;仅凭有限个表值,严格地说推不出连续性(存在与表值完全一致、各开区间内取常值且处处无零点的间断函数)。但在教材语境下(4.5 节”用零点存在定理判断零点”的配套练习),这类”由对应值表判断零点”的题默认函数图象是连续不断的(否则无从谈起),以下按此默认作答。

用零点存在定理(连续 + 端点异号 → 区间内至少有一个零点):

  • (2,3)(2, 3):f(2)=15.552>0f(2) = 15.552 > 0,f(3)=−3.92<0f(3) = -3.92 < 0,异号 → 一定有零点;
  • (3,4)(3, 4):f(3)=−3.92<0f(3) = -3.92 < 0,f(4)=10.88>0f(4) = 10.88 > 0,异号 → 一定有零点;
  • (4,5)(4, 5):f(4)=10.88>0f(4) = 10.88 > 0,f(5)=−52.488<0f(5) = -52.488 < 0,异号 → 一定有零点;
  • (1,2)(1, 2):f(1)=136.136f(1) = 136.136、f(2)=15.552f(2) = 15.552 同号;(5,6)(5, 6):f(5)=−52.488f(5) = -52.488、f(6)=−232.064f(6) = -232.064 同号——不能由定理判断(同号也可能有零点,比如 y=x2y = x^2)。

所以函数 y=f(x)y = f(x) 在 (2, 3)、(3, 4)、(4, 5) 内一定有零点,依据是零点存在定理:ff 的图象连续(默认),且这些区间端点的函数值异号。

自检:f(2)f(3)=15.552×(−3.92)<0f(2)f(3) = 15.552 \times (-3.92) < 0 ✓,f(3)f(4)=(−3.92)×10.88<0f(3)f(4) = (-3.92) \times 10.88 < 0 ✓,f(4)f(5)=10.88×(−52.488)<0f(4)f(5) = 10.88 \times (-52.488) < 0 ✓。符号序列为 ++−+−−+ + - + - -:每相邻两项异号就有一次”穿轴”(2→3、3→4、4→5 共 3 次),与三个区间对应。问的是”一定有零点”,所以只答定理能保证的区间,同号的 (1, 2)、(5, 6) 不能答”有”(只能说”不一定”)。若不作”图象连续”的默认,那么严格答案只能是:异号区间可能有零点,但”一定有”无从保证——本题按教材默认连续作答。

习题 4.5 第 3 题(复习巩固)

  1. 已知函数 f(x)=x3−2x+1f(x) = x^3 - 2x + 1,求证:方程 f(x)=xf(x) = x 在 (−1,2)(-1, 2) 内至少有两个实数解.

方程 f(x)=xf(x) = x 即 x3−2x+1=xx^3 - 2x + 1 = x,移项得 x3−3x+1=0x^3 - 3x + 1 = 0。设 h(x)=x3−3x+1h(x) = x^3 - 3x + 1,则 hh 是多项式函数,在 R\mathbb{R} 上连续。计算:

h(−1)=−1+3+1=3>0,h(0)=1>0,h(1)=1−3+1=−1<0,h(2)=8−6+1=3>0.h(-1) = -1 + 3 + 1 = 3 > 0, \quad h(0) = 1 > 0, \quad h(1) = 1 - 3 + 1 = -1 < 0, \quad h(2) = 8 - 6 + 1 = 3 > 0.
  • 在 (0,1)(0, 1) 上:h(0)h(1)=1×(−1)<0h(0)h(1) = 1 \times (-1) < 0,由零点存在定理,hh 在 (0,1)(0, 1) 内至少有一个零点;
  • 在 (1,2)(1, 2) 上:h(1)h(2)=(−1)×3<0h(1)h(2) = (-1) \times 3 < 0,由零点存在定理,hh 在 (1,2)(1, 2) 内至少有一个零点。

两个区间互不相交,所以方程 f(x)=xf(x) = x 在 (−1,2)(-1, 2) 内至少有两个实数解。

自检:hh 的真实零点约 −1.88-1.88、0.350.35、1.531.53——其中 0.35∈(0,1)0.35 \in (0, 1)、1.53∈(1,2)1.53 \in (1, 2) 正是定理给出的两个区间(还有一个在 (−2,−1)(-2, -1) 内,但本题只需证”至少两个”)。注意 h(−1)>0h(-1) > 0 与 h(0)>0h(0) > 0 同号,说明第一个零点在 (0,1)(0, 1) 内而不是 (−1,0)(-1, 0)——定区间时要把端点值逐个算对。移项方向:f(x)=x⇒x3−3x+1=0f(x) = x \Rightarrow x^3 - 3x + 1 = 0,别把 2x2x 留在左边。

习题 4.5 第 4 题(复习巩固)

  1. 利用信息技术,用二分法求函数 f(x)=ln⁡x−2xf(x) = \ln x - \frac{2}{x} 的零点(精确度为0.1).

先找初始区间:f(2)=ln⁡2−1≈−0.307<0f(2) = \ln 2 - 1 \approx -0.307 < 0,f(3)=ln⁡3−23≈0.432>0f(3) = \ln 3 - \frac23 \approx 0.432 > 0,f(2)f(3)<0f(2)f(3) < 0,且 ff 在 (0,+∞)(0, +\infty) 上连续,可以进行二分。逐次取中点:

区间中点 ccf(c)f(c) 的近似值零点所在新区间
(2,3)(2, 3)2.5f(2.5)=ln⁡2.5−0.8≈0.116>0f(2.5) = \ln 2.5 - 0.8 \approx 0.116 > 0(2,2.5)(2, 2.5)
(2,2.5)(2, 2.5)2.25f(2.25)=ln⁡2.25−22.25≈−0.078<0f(2.25) = \ln 2.25 - \frac{2}{2.25} \approx -0.078 < 0(2.25,2.5)(2.25, 2.5)
(2.25,2.5)(2.25, 2.5)2.375f(2.375)≈0.023>0f(2.375) \approx 0.023 > 0(2.25,2.375)(2.25, 2.375)
(2.25,2.375)(2.25, 2.375)2.3125f(2.3125)≈−0.027<0f(2.3125) \approx -0.027 < 0(2.3125,2.375)(2.3125, 2.375)

此时 ∣2.375−2.3125∣=0.0625<0.1|2.375 - 2.3125| = 0.0625 < 0.1,达到精确度,停止。零点近似值可取 2.3125(或 2.375,区间内任意一点都满足精确度)。

自检:真实零点约 2.352.35(ln⁡x=2x\ln x = \frac2x 即 xln⁡x=2x \ln x = 2,解得 x≈2.3458x \approx 2.3458),落在 [2.3125,2.375][2.3125, 2.375] 内且与近似值距离 <0.1< 0.1 ✓。每步判号:f(2.5)>0f(2.5) > 0 且 f(2)<0f(2) < 0 → 零点在 (2,2.5)(2, 2.5),方向别拿反。ff 在 (0,+∞)(0, +\infty) 上单调递增(ln⁡x\ln x 增、−2x-\frac2x 增),零点唯一,二分不会漏解。

习题 4.5 第 5 题(复习巩固)

  1. 利用信息技术,用二分法求方程 0.8x−1=ln⁡x0.8^{x} - 1 = \ln x 的近似解(精确度为0.1).

移项设 f(x)=0.8x−1−ln⁡xf(x) = 0.8^x - 1 - \ln x(定义域 x>0x > 0)。找初始区间:f(0.5)=0.80.5−1−ln⁡0.5≈0.894−1+0.693=0.587>0f(0.5) = 0.8^{0.5} - 1 - \ln 0.5 \approx 0.894 - 1 + 0.693 = 0.587 > 0,f(1)=0.8−1−0=−0.2<0f(1) = 0.8 - 1 - 0 = -0.2 < 0,f(0.5)f(1)<0f(0.5)f(1) < 0,且 ff 在 (0.5,1)(0.5, 1) 上连续,可以进行二分。逐次取中点:

区间中点 ccf(c)f(c) 的近似值零点所在新区间
(0.5,1)(0.5, 1)0.75f(0.75)≈0.134>0f(0.75) \approx 0.134 > 0(0.75,1)(0.75, 1)
(0.75,1)(0.75, 1)0.875f(0.875)≈−0.044<0f(0.875) \approx -0.044 < 0(0.75,0.875)(0.75, 0.875)
(0.75,0.875)(0.75, 0.875)0.8125f(0.8125)≈0.042>0f(0.8125) \approx 0.042 > 0(0.8125,0.875)(0.8125, 0.875)

此时 ∣0.875−0.8125∣=0.0625<0.1|0.875 - 0.8125| = 0.0625 < 0.1,达到精确度,停止。原方程的近似解可取 0.8125(或 0.875)。

自检:真实解约 0.840.84(0.80.84≈0.8280.8^{0.84} \approx 0.828,1+ln⁡0.84≈0.8261 + \ln 0.84 \approx 0.826),落在 [0.8125,0.875][0.8125, 0.875] 内 ✓。注意 f(0.75)>0f(0.75) > 0 与 f(0.5)>0f(0.5) > 0 同号,零点在 (0.75,1)(0.75, 1) 而不在 (0.5,0.75)(0.5, 0.75)——二分法每步只保留与端点异号的一半区间。唯一性论证:f(x)=0.8x−1−ln⁡xf(x) = 0.8^x - 1 - \ln x 在定义域 (0,+∞)(0, +\infty) 上严格递减(0.8x0.8^x 严格递减,−ln⁡x-\ln x 严格递减,两项之和仍严格递减),且 lim⁡x→0+f(x)=+∞\lim\limits_{x \to 0^+} f(x) = +\infty(−ln⁡x→+∞-\ln x \to +\infty 主导),lim⁡x→+∞f(x)=−∞\lim\limits_{x \to +\infty} f(x) = -\infty(0.8x→00.8^x \to 0,−ln⁡x→−∞-\ln x \to -\infty)。连续严格递减函数在每个取值上恰好穿过一次,所以方程恰有一个实根——已由二分区间 (0.5,1)(0.5, 1) 套住(f(2)≈0.64−1−0.69=−1.05<0f(2) \approx 0.64 - 1 - 0.69 = -1.05 < 0 后保持为负,与单调性一致)。

习题 4.5 第 6 题(复习巩固)

  1. 一种专门占据内存的计算机病毒,开机时占据内存 2 KB,然后每 3 分自身复制一次,复制后所占内存是原来的 2 倍。那么开机后多少分,该病毒会占据 64 MB 内存(1 MB=1024 KB)?

每 3 分钟翻一番,这是指数增长:开机 tt 分钟后占据内存

M(t)=2×2t/3(KB).M(t) = 2 \times 2^{t/3} \text{(KB)}.

64 MB =64×1024=65536= 64 \times 1024 = 65536 KB。令 M(t)=65536M(t) = 65536:

2×2t/3=65536⇒2t/3=215⇒t3=15⇒t=45(分).2 \times 2^{t/3} = 65536 \Rightarrow 2^{t/3} = 2^{15} \Rightarrow \frac{t}{3} = 15 \Rightarrow t = 45 \text{(分)}.

所以开机后 45 分钟,该病毒占据 64 MB 内存。

自检:65536=21665536 = 2^{16},故 2×2t/3=216⇒2t/3=2152 \times 2^{t/3} = 2^{16} \Rightarrow 2^{t/3} = 2^{15},即从 2 KB 到 64 MB 共翻 1515 番,每番 3 分钟,15×3=4515 \times 3 = 45 分钟 ✓。逐次验证:45 分钟时 2×215=655362 \times 2^{15} = 65536 KB =64= 64 MB ✓;42 分钟时 2×214=327682 \times 2^{14} = 32768 KB =32= 32 MB,还不到——所以 45 分钟是首次达到 64 MB 的时刻。单位换算(1 MB = 1024 KB)在这题里最关键,别按 1000 换。

习题 4.5 第 7 题(综合运用)

  1. 设函数 f(x)=ax2+bx+c(a>0,b,c∈R)f(x) = ax^{2} + bx + c (a > 0, b, c \in \mathbb{R}),且 f(1)=−a2f(1) = -\frac{a}{2},求证:函数 f(x)f(x) 在 (0, 2)

(课本此处排版断行,完整题面为”求证:函数 f(x)f(x) 在 (0,2)(0, 2) 内至少有一个零点”。)

由 f(1)=−a2f(1) = -\frac{a}{2} 得 a+b+c=−a2a + b + c = -\frac{a}{2},即 b+c=−3a2b + c = -\frac{3a}{2}。于是

f(0)=c,f(2)=4a+2b+c=4a+2b+(−3a2−b)=5a2+b.f(0) = c, \qquad f(2) = 4a + 2b + c = 4a + 2b + \left(-\frac{3a}{2} - b\right) = \frac{5a}{2} + b.

两式相加:f(0)+f(2)=5a2+b+c=5a2−3a2=a>0f(0) + f(2) = \frac{5a}{2} + b + c = \frac{5a}{2} - \frac{3a}{2} = a > 0(题设 a>0a > 0)。

所以 f(0)f(0) 与 f(2)f(2) 中至少有一个为正。而 f(1)=−a2<0f(1) = -\frac{a}{2} < 0:

  • 若 f(0)>0f(0) > 0,则 f(0)f(1)<0f(0)f(1) < 0,由零点存在定理,ff 在 (0,1)(0, 1) 内至少有一个零点;
  • 若 f(0)⩽0f(0) \leqslant 0(此时 f(2)=a−f(0)>0f(2) = a - f(0) > 0),则 f(1)f(2)<0f(1)f(2) < 0,由零点存在定理,ff 在 (1,2)(1, 2) 内至少有一个零点。

两种情形都推出 ff 在 (0,2)(0, 2) 内至少有一个零点,得证。

自检:思路要点是”从 f(0)+f(2)=a>0f(0) + f(2) = a > 0 推出端点至少一个与 f(1)<0f(1) < 0 异号”。验算 f(2)f(2) 的化简:f(2)=4a+2b+cf(2) = 4a + 2b + c,代入 c=−3a2−bc = -\frac{3a}{2} - b 得 4a+2b−3a2−b=5a2+b4a + 2b - \frac{3a}{2} - b = \frac{5a}{2} + b ✓;f(0)+f(2)=c+5a2+b=(b+c)+5a2=−3a2+5a2=af(0) + f(2) = c + \frac{5a}{2} + b = (b + c) + \frac{5a}{2} = -\frac{3a}{2} + \frac{5a}{2} = a ✓。二次函数 ff 在 R\mathbb{R} 上连续,零点存在定理可用。举例验证:取 a=2a = 2,b=−5b = -5,c=2c = 2(满足 b+c=−3=−3a2b + c = -3 = -\frac{3a}{2}),则 f(x)=2x2−5x+2f(x) = 2x^2 - 5x + 2,零点 x=12x = \frac12 和 x=2x = 2——12∈(0,2)\frac12 \in (0, 2) ✓,且 f(0)=2>0f(0) = 2 > 0 走第一种情形。此题”至少有一个零点”用零点存在定理即可,不必证唯一。

习题 4.5 第 8 题(综合运用)

  1. 已知函数 f(x)=−x2−3x−2f(x) = -x^{2} - 3x - 2,g(x)=2−[f(x)]2g(x) = 2 - [f(x)]^{2},

(1) 求函数 y=g(x)y=g(x) 的解析式;

(2) 利用信息技术,画出函数 y=g(x)y=g(x) 的图象;

(3) 求函数 y=g(x)y=g(x) 的零点(精确度为 0.1).

(1) 代入 f(x)f(x):

g(x)=2−[f(x)]2=2−(−x2−3x−2)2=2−(x2+3x+2)2.g(x) = 2 - [f(x)]^2 = 2 - (-x^2 - 3x - 2)^2 = 2 - (x^2 + 3x + 2)^2.

((−x2−3x−2)2=(x2+3x+2)2(-x^2 - 3x - 2)^2 = (x^2 + 3x + 2)^2,因为平方去掉符号。)

(2) 图象(由信息技术画出):g(x)=2−(x2+3x+2)2g(x) = 2 - (x^2 + 3x + 2)^2 在 x≈−2.8x \approx -2.8 与 x≈−0.2x \approx -0.2 处与 xx 轴相交,中间 (x2+3x+2=0)\left(x^2 + 3x + 2 = 0\right) 即 x=−2x = -2 或 x=−1x = -1 时 gg 取得最大值 22——所以图象在 (−2,−1)(-2, -1) 附近有一个向上的尖峰(峰值 2),两翼下降到 xx 轴下方。

(3) 令 g(x)=0g(x) = 0,即 [f(x)]2=2[f(x)]^2 = 2,即 f(x)=2f(x) = \sqrt{2} 或 f(x)=−2f(x) = -\sqrt{2}。

先看 f(x)=2f(x) = \sqrt{2}:f(x)=−x2−3x−2f(x) = -x^2 - 3x - 2 是开口向下的抛物线,顶点 x=−32x = -\frac{3}{2} 处 f(−32)=14f\left(-\frac32\right) = \frac14——ff 的最大值只有 14<2≈1.414\frac14 < \sqrt{2} \approx 1.414,所以 f(x)=2f(x) = \sqrt{2} 无解。

再看 f(x)=−2f(x) = -\sqrt{2}:

−x2−3x−2=−2⇒x2+3x+(2−2)=0,-x^2 - 3x - 2 = -\sqrt{2} \Rightarrow x^2 + 3x + (2 - \sqrt{2}) = 0, x=−3±9−4(2−2)2=−3±1+422.x = \frac{-3 \pm \sqrt{9 - 4(2 - \sqrt{2})}}{2} = \frac{-3 \pm \sqrt{1 + 4\sqrt{2}}}{2}.

1+42≈6.657≈2.580\sqrt{1 + 4\sqrt{2}} \approx \sqrt{6.657} \approx 2.580,所以 x≈−3+2.582=−0.21x \approx \frac{-3 + 2.58}{2} = -0.21 或 x≈−3−2.582=−2.79x \approx \frac{-3 - 2.58}{2} = -2.79。精确到 0.1,g(x)g(x) 的零点为约 −2.8-2.8 和 −0.2-0.2。

自检:f(x)=−x2−3x−2=−(x+1)(x+2)f(x) = -x^2 - 3x - 2 = -(x + 1)(x + 2) 的最大值在 x=−32x = -\frac32:−94+92−2=14-\frac94 + \frac92 - 2 = \frac14,确实 <2< \sqrt2,所以 f(x)=2f(x) = \sqrt2 的情形被排除(用最大值排除,比硬解判别式更干净);f(x)=−2f(x) = -\sqrt2 的判别式 Δ=9−4(2−2)=1+42>0\Delta = 9 - 4(2 - \sqrt2) = 1 + 4\sqrt2 > 0,两个根 −2.79-2.79、−0.21-0.21 分别落在 (−3,−2)(-3, -2) 与 (−1,0)(-1, 0) 内 ✓。精确值 −0.210-0.210、−2.790-2.790 四舍五入到一位小数即 −0.2-0.2、−2.8-2.8。注意 (3) 问的”零点”是 gg 与 xx 轴交点,即 [f(x)]2=2[f(x)]^2 = 2——不要理解成 g(x)=0g(x) = 0 时 ff 的零点。

习题 4.5 第 9 题(综合运用)

  1. 如图,某池塘里浮萍的面积 yy (单位: m2\mathrm{m}^2 )与时间 tt (单位:月)的关系为 y=aty = a^t. 关于下列说法:

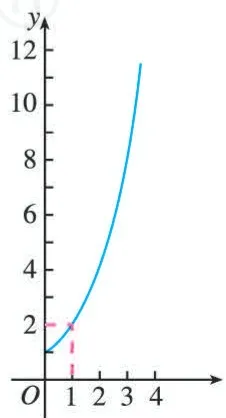
题面附图(课本第 162 页):指数曲线 y=aty = a^t 上虚线标出点 (1,2)(1, 2),代入 y=aty = a^t 得 a=2a = 2,即 y=2ty = 2^t。课本给出的下列说法:

① 浮萍每月的增长率为 1;

② 第 5 个月时,浮萍面积就会超过 30 m230 \, m^{2} ;

③ 浮萍每月增加的面积都相等;

(第9题)

④ 若浮萍蔓延到 2m22\mathrm{m}^2 , 3m23\mathrm{m}^2 , 6m26\mathrm{m}^2 所经过的时间分别是 t1t_1 , t2t_2 , t3t_3 ,则 t1+t2=t3t_1 + t_2 = t_3

其中正确的说法是().

逐条判断:

① 每月增长率:面积从 2t2^t 增到 2t+12^{t+1},增长率 =2t+1−2t2t=2−1=1= \frac{2^{t+1} - 2^t}{2^t} = 2 - 1 = 1,即每月翻一番、增长率为 1 ✓ 正确;

② 第 5 个月:25=32>302^5 = 32 > 30(m2\mathrm{m}^2)✓ 正确;

③ 每月增加的面积:第 tt 月比第 t−1t-1 月增加 2t−2t−1=2t−12^t - 2^{t-1} = 2^{t-1}(m2\mathrm{m}^2)——随 tt 增长而增长,不相等 ✗ 错误;

④ 由 2t1=22^{t_1} = 2、2t2=32^{t_2} = 3、2t3=62^{t_3} = 6 得 t1=log⁡22=1t_1 = \log_2 2 = 1,t2=log⁡23t_2 = \log_2 3,t3=log⁡26=log⁡2(2×3)=log⁡22+log⁡23=1+t2t_3 = \log_2 6 = \log_2 (2 \times 3) = \log_2 2 + \log_2 3 = 1 + t_2,所以 t1+t2=t3t_1 + t_2 = t_3 ✓ 正确。

正确的说法是 ①②④,选 (C)。

自检:①的增长率 1 是”相对增长”(翻倍 = 增长 100%),与 ③的”绝对增量”(2t−12^{t-1} 逐月增大)是一对经典陷阱——指数增长”增长率恒定、增量越来越大”,区别于线性增长”增量恒定”。④ 用的是对数运算律 log⁡a(mn)=log⁡am+log⁡an\log_a (mn) = \log_a m + \log_a n。若图上点不是 (1,2)(1, 2),则 aa 取该点坐标,其余步骤不变。选项排查:③ 错则 (B)(D) 排除,(A) 缺 ④ 排除,故选 C。

习题 4.5 第 10 题(综合运用)

  1. 一种药在病人血液中的量保持在 1500mg1500 \mathrm{mg} 以上时才有疗效,而低于 500mg500 \mathrm{mg} 时病人就有危险。现给某病人的静脉注射了这种药 2500mg2500 \mathrm{mg},如果药在血液中以每小时 20%20\% 的比例衰减,那么应在什么时间范围再向病人的血液补充这种药(精确到 0.1 h0.1 \mathrm{~h})?

药量每小时衰减 20%,即每小时乘以 1−20%=0.81 - 20\% = 0.8。注射后 tt 小时药量为

y(t)=2500×0.8t(mg).y(t) = 2500 \times 0.8^t \text{(mg)}.

降到 1500 mg(疗效下限)的时刻:

2500×0.8t=1500⇒0.8t=0.6⇒t=ln⁡0.6ln⁡0.8≈−0.5108−0.2231≈2.29≈2.3(h).2500 \times 0.8^t = 1500 \Rightarrow 0.8^t = 0.6 \Rightarrow t = \frac{\ln 0.6}{\ln 0.8} \approx \frac{-0.5108}{-0.2231} \approx 2.29 \approx 2.3 \text{(h)}.

降到 500 mg(危险下限)的时刻:

2500×0.8t=500⇒0.8t=0.2⇒t=ln⁡0.2ln⁡0.8≈−1.6094−0.2231≈7.21≈7.2(h).2500 \times 0.8^t = 500 \Rightarrow 0.8^t = 0.2 \Rightarrow t = \frac{\ln 0.2}{\ln 0.8} \approx \frac{-1.6094}{-0.2231} \approx 7.21 \approx 7.2 \text{(h)}.

所以在注射后 约 2.3 h 至 7.2 h 的时间范围内应向病人补充这种药:晚于 2.3 h 补,药量会掉到 1500 mg 以下失去疗效;晚于 7.2 h 补,药量会低于 500 mg 危及病人。

自检:衰减模型 y=2500×0.8ty = 2500 \times 0.8^t 单调递减:y(0)=2500y(0) = 2500,y(2.3)=2500×0.82.29≈2500×0.600≈1500y(2.3) = 2500 \times 0.8^{2.29} \approx 2500 \times 0.600 \approx 1500 ✓,y(7.2)=2500×0.87.21≈2500×0.200≈500y(7.2) = 2500 \times 0.8^{7.21} \approx 2500 \times 0.200 \approx 500 ✓。所以补充时间窗是 [2.3,7.2][2.3, 7.2] h。这是指数方程的对数求解:at=b⇒t=ln⁡bln⁡aa^t = b \Rightarrow t = \frac{\ln b}{\ln a},注意 0.8<10.8 < 1,ln⁡0.8<0\ln 0.8 < 0、ln⁡0.6<0\ln 0.6 < 0,比值为正。若题目问”最迟”则答 7.2 h,问”最早”则答 2.3 h——本题问时间范围,两个都要给。

习题 4.5 第 11 题(综合运用)

  1. 人类已进入大数据时代. 目前, 数据量已经从 TB (1 TB = 1024 GB) 级别跃升到 PB (1 PB = 1024 TB), EB (1 EB = 1024 PB) 乃至 ZB (1 ZB = 1024 EB) 级别. 曾经的研究结果表明, 2008 年全球产生的数据量为 0.49 ZB, 2009 年的数据量为 0.8 ZB, 2010 年增长到 1.2 ZB, 2011 年的数据量更是高达 1.82 ZB.

(1)为了较好地描述2008年起全球产生的数据量与时间 xx (单位:年)的关系,根据上述数据信息,从函数 f(x)=kx+bf(x) = kx + b 和 g(x)=abxg(x) = ab^{x} 中选择一个,并求出解析式.

(2) 根据(1)中所求函数模型,估计 2018 年全球所产生的数据量,并与所公布数据比较,你有何看法?

(1) 令 x=0,1,2,3x = 0, 1, 2, 3 对应 2008~2011 年,数据量为 y=0.49,0.8,1.2,1.82y = 0.49, 0.8, 1.2, 1.82(ZB)。

先看增长方式:相邻两年比值 0.8/0.49≈1.630.8/0.49 \approx 1.63,1.2/0.8=1.51.2/0.8 = 1.5,1.82/1.2≈1.521.82/1.2 \approx 1.52——比值基本稳定在 1.5 上下,说明数据量大致按固定的倍数增长(指数增长的特征);而相邻两年差值为 0.31、0.40、0.62,越来越大,不满足线性模型”差值恒定”的特征。所以应选择指数模型 g(x)=abxg(x) = ab^x。

取 2008 年与 2011 年两组数据确定参数:ab0=0.49ab^0 = 0.49,ab3=1.82ab^3 = 1.82,得

a=0.49,b3=1.820.49≈3.7143⇒b≈1.5487,a = 0.49, \quad b^3 = \frac{1.82}{0.49} \approx 3.7143 \Rightarrow b \approx 1.5487,

所以 g(x)=0.49×1.5487xg(x) = 0.49 \times 1.5487^x(xx 为年份减 2008)。检验中间点:g(1)=0.49×1.5487≈0.759g(1) = 0.49 \times 1.5487 \approx 0.759(实际 0.8),g(2)=0.49×1.54872≈1.175g(2) = 0.49 \times 1.5487^2 \approx 1.175(实际 1.2)——与实际数据相当接近。

(2) 2018 年对应 x=10x = 10:

g(10)=0.49×1.548710≈0.49×79.3≈38.9≈39(ZB).g(10) = 0.49 \times 1.5487^{10} \approx 0.49 \times 79.3 \approx 38.9 \approx 39 \text{(ZB)}.

估计 2018 年全球数据量约为 39 ZB。与实际公布的 2018 年全球数据量(约 33 ZB)相比,模型估计偏高一些——说明 2011 年之后全球数据量的增长速度比前几年有所放缓,指数模型对未来做了偏高外推;但模型在数量级上仍相当接近,用它描述 2008~2011 年的增长规律是合适的。

自检:1.548710=e10ln⁡1.5487=e10×0.4374=e4.374≈79.31.5487^{10} = \mathrm{e}^{10 \ln 1.5487} = \mathrm{e}^{10 \times 0.4374} = \mathrm{e}^{4.374} \approx 79.3,0.49×79.3≈38.90.49 \times 79.3 \approx 38.9 ✓。模型选择的依据要说成”比值恒定 vs 差值恒定”(对应 §4.4.3 指数增长 vs 直线上升),不要只凭”看起来像”下结论。若用最小二乘拟合全部四点得 g(x)≈0.50×1.54xg(x) \approx 0.50 \times 1.54^x,2018 年估计 ≈38.5\approx 38.5 ZB,与上面首尾两点法的 38.9 基本一致——两种定参法结论稳健。

习题 4.5 第 12 题(综合运用)

  1. 某地不同身高的未成年男性的体重平均值如下表:

(1) 根据表中提供的数据建立恰当的函数模型,使它能近似地反映这个地区未成年男性平均体重 yy (单位: kg\mathrm{kg} )与身高 xx (单位: cm\mathrm{cm} )的函数关系,并写出这个函数的解析式.

(2) 若体重超过相同身高男性体重平均值的 1.2 倍为偏胖,低于 0.8 倍为偏瘦,那么该地一名身高为 175 cm,体重为 78 kg 的在校男生的体重是否正常?

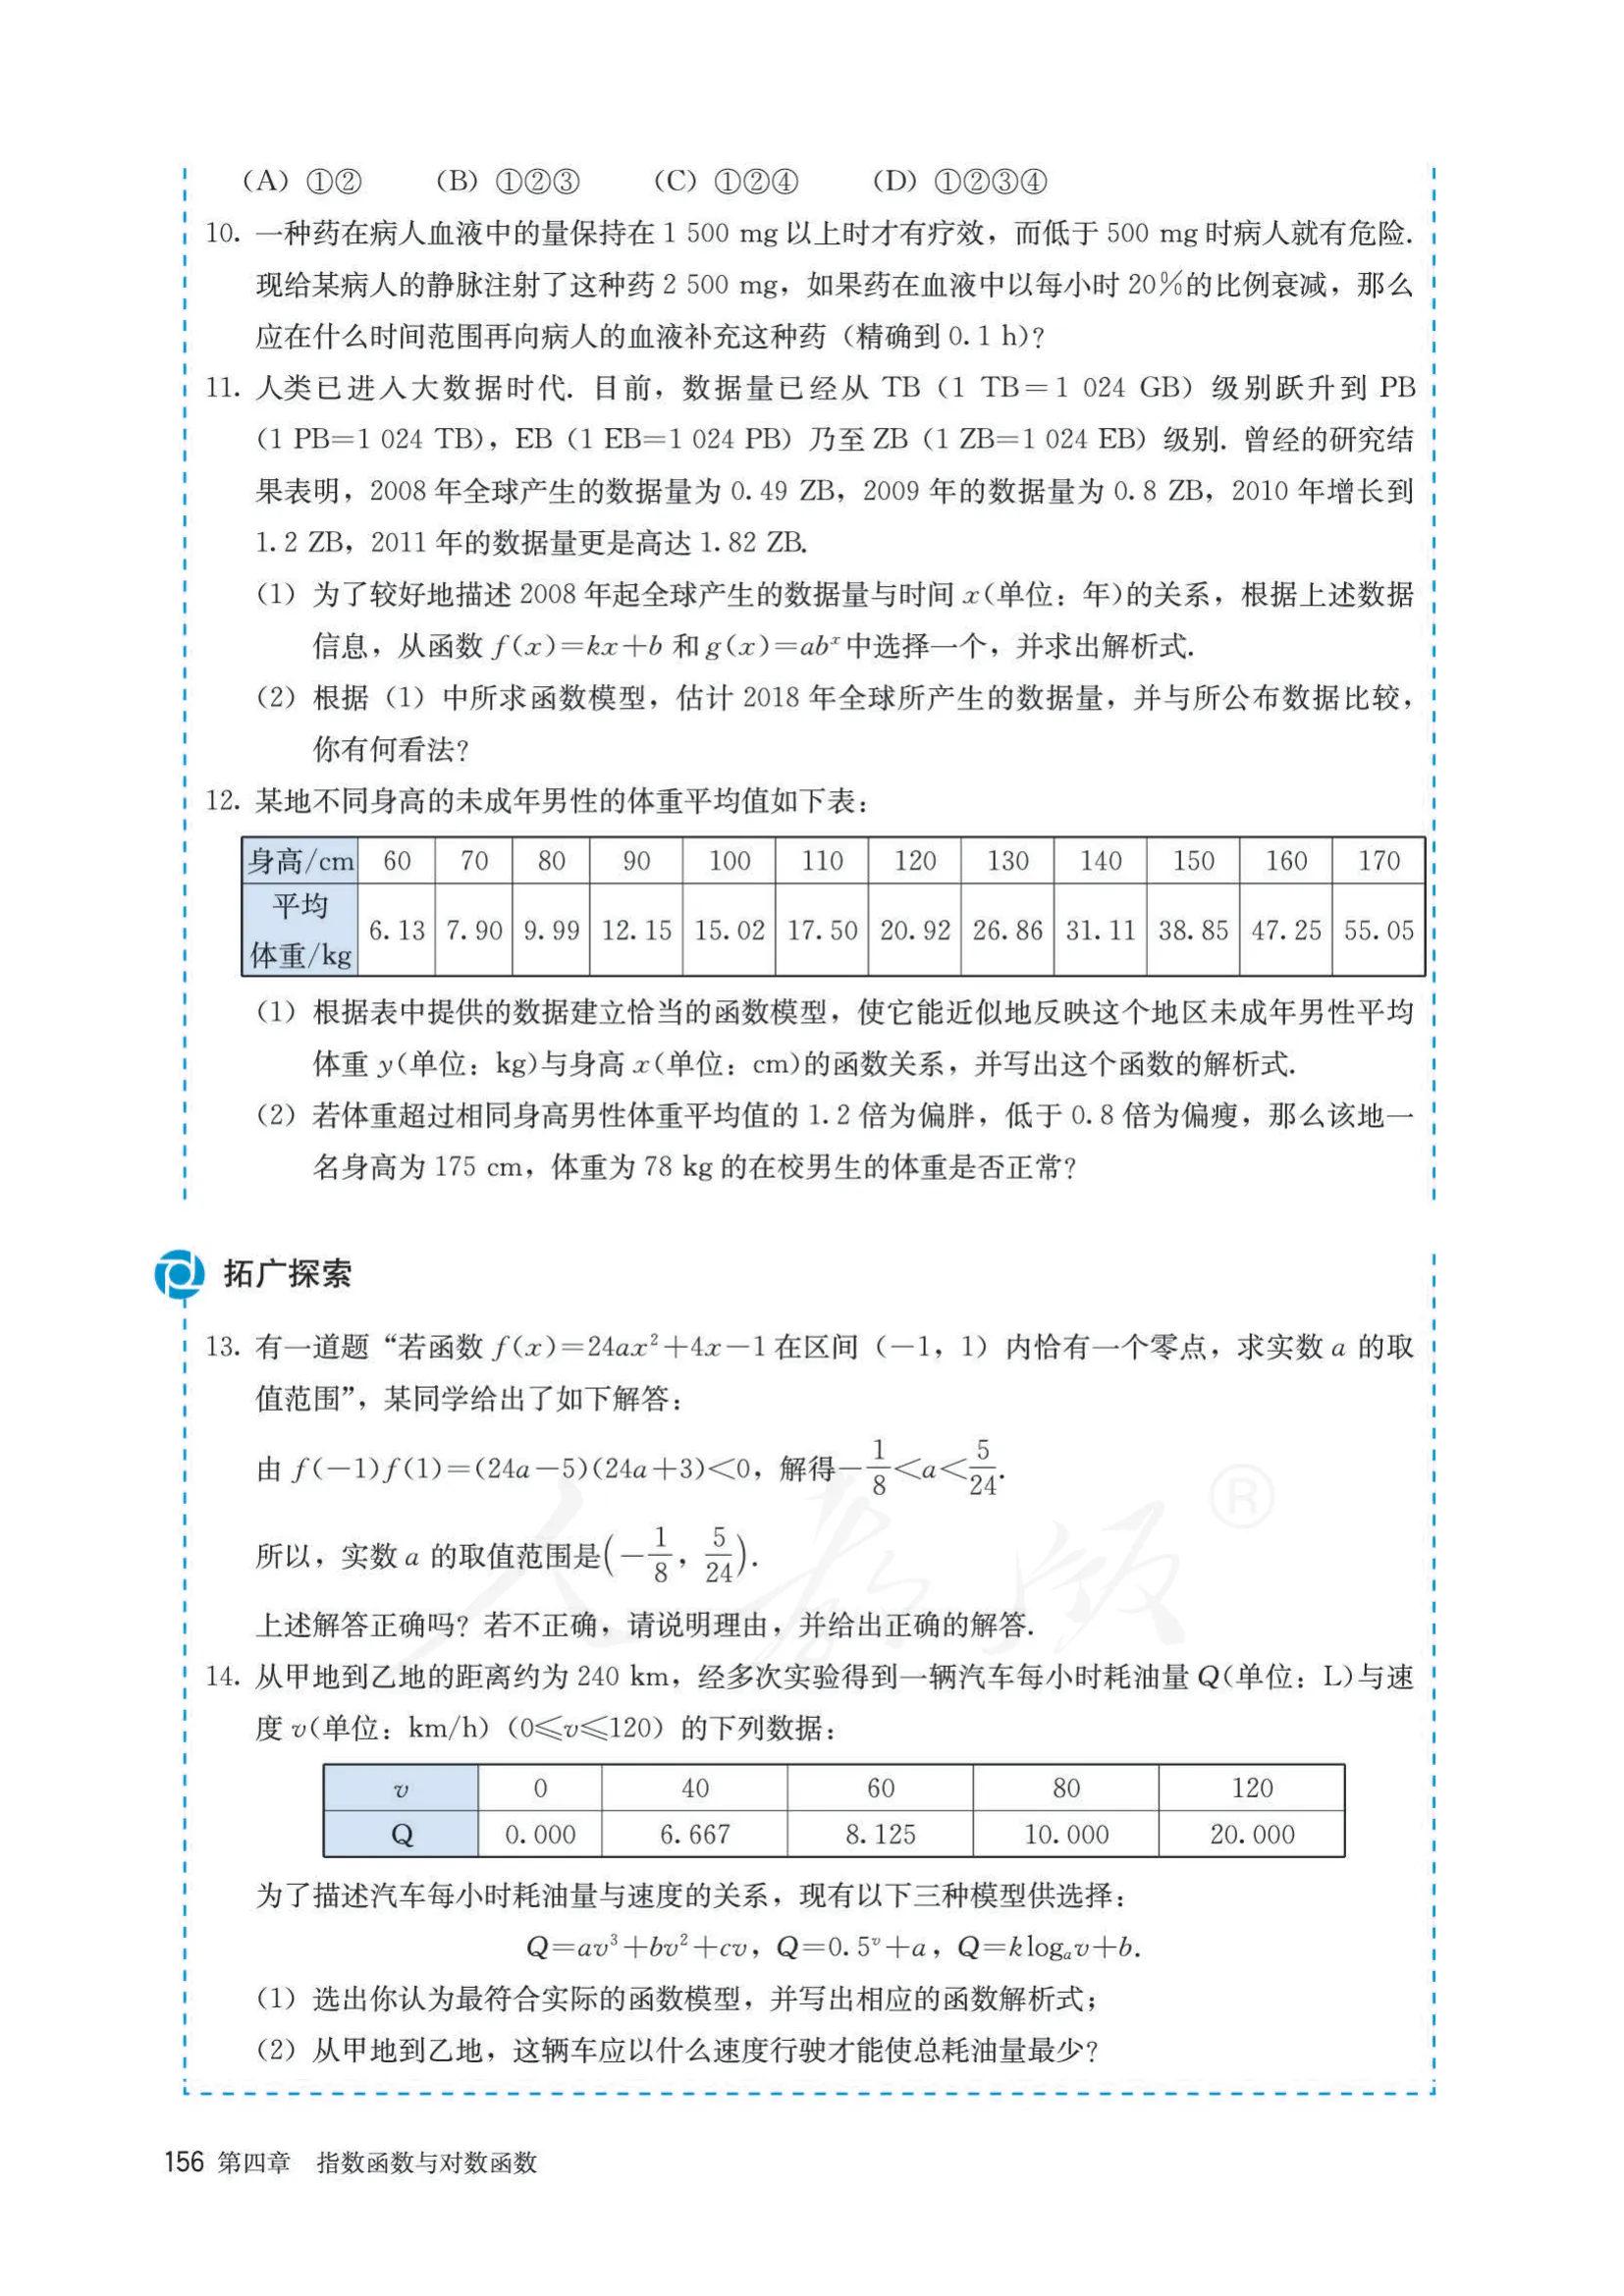
题面附表(课本第 163 页):

身高 x/cm60708090100110120130140150160170
平均体重 y/kg6.137.909.9912.1515.0217.5020.9226.8631.1138.8547.2555.05

(1) 观察数据:身高从 60 到 170 cm(约 2.8 倍),体重从 6.13 到 55.05 kg(约 9.0 倍)——体重增长远快于身高增长。生物学常识和图形都提示体重与身高的平方大致成正比(身形近似等比放大,体积/质量与尺度平方相关),用二次函数 y=ax2y = ax^2 建模。由第一组数据(x=60x = 60,y=6.13y = 6.13)定参数:

a=6.13602≈0.0017,a = \frac{6.13}{60^2} \approx 0.0017,

取 y=0.0017x2y = 0.0017x^2。检验几个点:x=60x = 60 时 y=0.0017×3600=6.12y = 0.0017 \times 3600 = 6.12(实际 6.13,几乎重合);x=150x = 150 时 y=0.0017×22500=38.25y = 0.0017 \times 22500 = 38.25(实际 38.85);x=170x = 170 时 y=0.0017×28900=49.13y = 0.0017 \times 28900 = 49.13(实际 55.05)——中等身高段误差较小,较高段略偏低,整体能近似反映体重随身高的增长规律。所以函数解析式为

y=0.0017x2(60⩽x⩽175).y = 0.0017x^2 \quad (60 \leqslant x \leqslant 175).

(2) 用模型预测身高 175 cm 的平均体重:y=0.0017×1752=0.0017×30625≈52.1y = 0.0017 \times 175^2 = 0.0017 \times 30625 \approx 52.1(kg)。该男生体重 78 kg,7852.1≈1.50>1.2\frac{78}{52.1} \approx 1.50 > 1.2,超过平均值的 1.5 倍——属于偏胖,体重不正常。

自检:6.13/3600=0.0017036.13/3600 = 0.001703,55.05/28900=0.00190555.05/28900 = 0.001905,两端的 aa 略有差异,取近似 0.00170.0017 是合理的折中(150 cm 处 38.2538.25 vs 实际 38.8538.85,误差不到 2%)。判定是否偏胖只与比值 78/52.1≈1.5078/52.1 \approx 1.50 有关:即使改用两端拟合的另一组参数(a≈0.0019a \approx 0.0019,y(175)≈58.1y(175) \approx 58.1 kg),比值 78/58.1≈1.3478/58.1 \approx 1.34 仍大于 1.2——结论稳健,无论用哪种合理模型,该男生都偏胖。这题的关键是”建模型 → 代入预测 → 与 1.2 倍阈值比较”,模型不必完美,结论要经得起参数扰动。

习题 4.5 第 13 题(拓广探索)

  1. 有一道题 “若函数 f(x)=24ax2+4x−1f(x)=24ax^{2}+4x-1 在区间 (−1,1)(-1,1) 内恰有一个零点,求实数 a 的取值范围”,某同学给出了如下解答: 由 f(−1)f(1)=(24a−5)(24a+3)<0f(-1)f(1)=(24a-5)(24a+3)<0 ,解得 −18<a<524-\frac{1}{8}<a<\frac{5}{24} . 所以,实数 a 的取值范围是 (−18,524)\left(-\frac{1}{8}, \frac{5}{24}\right) . 上述解答正确吗?若不正确,请说明理由,并给出正确的解答.

不正确。同学只处理了 f(−1)f(1)<0f(-1)f(1) < 0(图象”跨过”区间)的情形,漏掉了三种”恰有一个零点”但端点函数值不异号的情形。

正确的完整解答,分情况讨论:

情形一:a=0a = 0。f(x)=4x−1f(x) = 4x - 1 是一次函数,零点 x=14∈(−1,1)x = \frac14 \in (-1, 1),恰有一个 ✓。同学把 a=0a = 0 代入 f(−1)f(1)=(24a−5)(24a+3)=−15<0f(-1)f(1) = (24a-5)(24a+3) = -15 < 0 也满足不等式,所以 a=0a = 0 其实落在他的区间 (−1/8,5/24)(-1/8, 5/24) 内——但他在推导中把 ff 当作二次函数处理,逻辑上有缺陷。

情形二:f(−1)f(1)<0f(-1)f(1) < 0(a≠0a \neq 0)。由零点存在定理,ff 在 (−1,1)(-1, 1) 内至少有一个零点;而二次函数 f(−1)f(-1) 与 f(1)f(1) 异号时零点个数为奇数个(跨轴),二次方程至多两个实根,故恰好一个:

(24a−5)(24a+3)<0⇒−18<a<524.(24a - 5)(24a + 3) < 0 \Rightarrow -\frac18 < a < \frac{5}{24}.

情形三:f(−1)=0f(-1) = 0 或 f(1)=0f(1) = 0(零点在端点)。f(−1)=24a−5=0⇒a=524f(-1) = 24a - 5 = 0 \Rightarrow a = \frac{5}{24}:f(x)=5x2+4x−1=(5x−1)(x+1)f(x) = 5x^2 + 4x - 1 = (5x - 1)(x + 1),零点 x=15x = \frac15(在 (−1,1)(-1,1) 内)与 x=−1x = -1(端点,不在开区间内)——恰有一个在 (−1,1)(-1,1) 内 ✓。f(1)=24a+3=0⇒a=−18f(1) = 24a + 3 = 0 \Rightarrow a = -\frac18:f(x)=−3x2+4x−1=−(3x−1)(x−1)f(x) = -3x^2 + 4x - 1 = -(3x - 1)(x - 1),零点 x=13x = \frac13(在区间内)与 x=1x = 1(端点)——恰有一个在 (−1,1)(-1,1) 内 ✓。这两个端点值要单独讨论,f(−1)f(1)=0f(-1)f(1) = 0 时同学的"<0< 0"条件不适用。

情形四:Δ=0\Delta = 0(图象与 xx 轴相切)。f(x)=24ax2+4x−1f(x) = 24ax^2 + 4x - 1 的判别式 Δ=16+96a=0⇒a=−16\Delta = 16 + 96a = 0 \Rightarrow a = -\frac16。此时 f(x)=−4x2+4x−1=−(2x−1)2f(x) = -4x^2 + 4x - 1 = -\left(2x - 1\right)^2,零点 x=12∈(−1,1)x = \frac12 \in (-1, 1)(二重根,恰一个零点)✓。而 f(−1)f(1)=(−9)×(−1)=9>0f(-1)f(1) = (-9) \times (-1) = 9 > 0,端点同号,同学的解答覆盖不到。

综合四种情形:

a∈{−16}∪[−18,524].a \in \left\{-\frac16\right\} \cup \left[-\frac18, \frac{5}{24}\right].

自检:逐情形验证——a=0a = 0:4x−1=04x - 1 = 0 的根 14∈(−1,1)\frac14 \in (-1,1) ✓;a=−18a = -\frac18:−(3x−1)(x−1)-(3x-1)(x-1) 在开区间内只有 x=13x = \frac13 ✓(x=1x = 1 是端点,(−1,1)(-1,1) 不含端点);a=524a = \frac{5}{24}:(5x−1)(x+1)(5x-1)(x+1) 在开区间内只有 x=15x = \frac15 ✓;a=−16a = -\frac16:−(2x−1)2-\left(2x-1\right)^2 的零点 x=12x = \frac12 ✓。a∈(−1/8,5/24)a \in (-1/8, 5/24) 开区间内的情形由情形二覆盖,端点 −18-\frac18、524\frac{5}{24} 由情形三补充,−16-\frac16 由情形四补充。同学的解答错在:只写了”端点异号”这一种充分条件,没有穷举”恰有一个零点”的全部可能(端点取零、判别式为零、一次函数)。这类”给出解答请你评判”的题,先找反例(如 a=0a = 0)说明不完整,再分情况补全。

习题 4.5 第 14 题(拓广探索)

  1. 从甲地到乙地的距离约为 240 km,经多次实验得到一辆汽车每小时耗油量 Q(单位:L)与速度 v(单位:km/h)(0≤v≤120)的下列数据:

为了描述汽车每小时耗油量与速度的关系,现有以下三种模型供选择:

Q=av3+bv2+cv,Q=0.5v+a,Q=klog⁡av+b.Q = a v ^ {3} + b v ^ {2} + c v, Q = 0. 5 ^ {v} + a, Q = k \log_ {a} v + b.

(1) 选出你认为最符合实际的函数模型,并写出相应的函数解析式;

(2) 从甲地到乙地,这辆车应以什么速度行驶才能使总耗油量最少?

题面附表(课本第 163 页):

v/(km/h)0406080120
Q/(L/h)0.0006.6678.12510.00020.000

(1) 先排除两个模型:Q=0.5v+aQ = 0.5^v + a 随 vv 增大单调递减并趋于常数 aa,而数据先升后升且 v=0v = 0 时 Q=0Q = 0 要求 a=−1a = -1,与”高速耗油大”不符;Q=klog⁡av+bQ = k\log_a v + b 在 v=0v = 0 处无定义,无法刻画 Q(0)=0Q(0) = 0,且对数函数无最小值点。所以选三次模型 Q=av3+bv2+cvQ = av^3 + bv^2 + cv(它过原点 Q(0)=0Q(0) = 0,与数据吻合)。

用三组数据 (40,6.667)(40, 6.667)、(60,8.125)(60, 8.125)、(80,10)(80, 10) 定参数:

{64000a+1600b+40c=6.667216000a+3600b+60c=8.125512000a+6400b+80c=10\begin{cases} 64000a + 1600b + 40c = 6.667 \\ 216000a + 3600b + 60c = 8.125 \\ 512000a + 6400b + 80c = 10 \end{cases}

解得 a=138400a = \frac{1}{38400},b=−1240b = -\frac{1}{240},c=724c = \frac{7}{24},即

Q=v338400−v2240+7v24.Q = \frac{v^3}{38400} - \frac{v^2}{240} + \frac{7v}{24}.

用第 4 组数据检验:v=120v = 120 时 Q=120338400−1202240+7×12024=45−60+35=20Q = \frac{120^3}{38400} - \frac{120^2}{240} + \frac{7 \times 120}{24} = 45 - 60 + 35 = 20,与实际数据 20 完全吻合 ✓。

(2) 从甲到乙距离 240 km,以速度 vv 行驶需 240v\frac{240}{v} 小时,总耗油量

W(v)=Q⋅240v=(v338400−v2240+7v24)⋅240v=240(v238400−v240+724).W(v) = Q \cdot \frac{240}{v} = \left(\frac{v^3}{38400} - \frac{v^2}{240} + \frac{7v}{24}\right) \cdot \frac{240}{v} = 240\left(\frac{v^2}{38400} - \frac{v}{240} + \frac{7}{24}\right).

括号内是开口向上的二次函数,最小值在顶点:

v=−−1/2402×(1/38400)=1240×19200=80(km/h).v = -\frac{-1/240}{2 \times (1/38400)} = \frac{1}{240} \times 19200 = 80 \text{(km/h)}.

所以这辆车应以 80 km/h 的速度行驶,总耗油量最少,最少耗油 W(80)=240×(80238400−80240+724)=240×18=30W(80) = 240 \times \left(\frac{80^2}{38400} - \frac{80}{240} + \frac{7}{24}\right) = 240 \times \frac18 = 30(L)。

自检:三次模型在 v=0v = 0、40、60、80、120 五点上的值:Q(0)=0Q(0) = 0 ✓,Q(40)=6400038400−1600240+28024=53−203+353=203≈6.667Q(40) = \frac{64000}{38400} - \frac{1600}{240} + \frac{280}{24} = \frac53 - \frac{20}{3} + \frac{35}{3} = \frac{20}{3} \approx 6.667 ✓,Q(60)=21600038400−3600240+42024=5.625−15+17.5=8.125Q(60) = \frac{216000}{38400} - \frac{3600}{240} + \frac{420}{24} = 5.625 - 15 + 17.5 = 8.125 ✓,Q(80)=51200038400−6400240+56024=403−803+703=10Q(80) = \frac{512000}{38400} - \frac{6400}{240} + \frac{560}{24} = \frac{40}{3} - \frac{80}{3} + \frac{70}{3} = 10 ✓,Q(120)=20Q(120) = 20 ✓——五个点全部命中,所以这个三次模型是”插值”出来的精确拟合,用它求最省油速度 v=80v = 80 km/h 是可靠的。总耗油 W(v)=240(av2+bv+c)W(v) = 240(av^2 + bv + c) 的化简:Q⋅240v=(av3+bv2+cv)⋅240v=240av2+240bv+240cQ \cdot \frac{240}{v} = (av^3 + bv^2 + cv) \cdot \frac{240}{v} = 240av^2 + 240bv + 240c ✓。速度 v=80v = 80 落在定义域 0≤v≤1200 \le v \le 120 内,答案有效。这题是”先选模型(排除法 + 过原点)→ 定参(解三元一次方程组)→ 检验(第 4 个点)→ 求最值(二次函数顶点)“的完整应用流程。

原书转写(OCR,供核对)

共 20 页· 默认折起

机器转写,如有出入以上方扫描图为准。它是原文可搜索、可复制公式、读屏器读得出的形态, 也是教材原文引文的逐字比对靶。

4.5.3 函数模型的应用

我们知道,函数是描述客观世界变化规律的数学模型,不同的变化规律需要用不同的函数模型来刻画。面临一个实际问题,该如何选择恰当的函数模型来刻画它呢?

例 3 人口问题是当今世界各国普遍关注的问题. 认识人口数量的变化规律, 可以为制定一系列相关政策提供依据. 早在 1798 年, 英国经济学家马尔萨斯 (T. R. Malthus, 1766—1834) 就提出了自然状态下的人口增长模型

y=y0ert,y = y _ {0} \mathrm{e} ^ {r t},

其中 t 表示经过的时间, y0y_{0} 表示 t=0 时的人口数,r 表示人口的增长率.

(1)根据国家统计局网站公布的数据,我国1950年末、1959年末的人口总数分别为55196万和67207万。根据这

尽管对马尔萨斯人口理论存在一些争议,但它对人口学和经济学的发展都产生了一定的影响。上网了解,还有哪些人口模型,它们与我们所学的函数有怎样的关系?

些数据,用马尔萨斯人口增长模型建立我国在1950~1959年期间的具体人口增长模型.

(2)利用(1)中的模型计算 1951~1958 年各年末的人口总数。查阅国家统计局网站公布的我国在 1951~1958 年间各年末的实际人口总数,检验所得模型与实际人口数据是否相符。

(3) 以 (1) 中的模型作预测, 大约在什么时候我国人口总数达到 13 亿?

分析:用马尔萨斯人口增长模型建立具体人口增长模型,就是要确定其中的初始量 y0y_{0} 和增长率r.

解:(1)由题意知 y0=55196y_0 = 55196,设 1950∼19591950 \sim 1959 年期间我国人口的年平均增长率为 rr,根据马尔萨斯人口增长模型,有

67207=55196e9r,6 7 2 0 7 = 5 5 1 9 6 \mathrm{e} ^ {9 r},

由计算工具得

r≈0.021876.r \approx 0. 0 2 1 8 7 6.

因此我国在 1950∼19591950\sim 1959 年期间的人口增长模型为

y=55196e0.021876t,t∈[0,9].y = 5 5 1 9 6 \mathrm{e} ^ {0. 0 2 1 8 7 6 t}, t \in [ 0, 9 ].

(2)分别取 t=1,2,…,8t = 1, 2, \dots, 8 ,由 y=55196e0.021876ty = 55196\mathrm{e}^{0.021876t} 可得我国在 1951∼19581951\sim 1958 年间的各年末人口总数;查阅国家统计局网站,得到我国 1951∼19581951\sim 1958 年各年末的实际人口总数,如表4.5-4所示.

根据 1950~1959 年我国人口总数的实际数据画出散点图,并画出函数 y=55196e0.021876ty = 55196e^{0.021876t} ( t∈[0,9]t \in [0, 9] )的图象(图 4.5-6).

由表 4.5-4 和图 4.5-6 可以看出,所得模型与 1950~1959 年的实际人口数据基本吻合.

(3) 将 y=130 000 代入

y=55196e0.021876t,y = 5 5 1 9 6 \mathrm{e} ^ {0. 0 2 1 8 7 6 t},

由计算工具得

t≈39.15.t \approx 3 9. 1 5.

所以,如果人口按照(1)中的模型增长,那么大约在1950年后的第40年(即1990年),我国的人口就已达到13亿.

思考

事实上,我国1990年的人口数为11.43亿,直到2005年才突破13亿。对由函数模型所得的结果与实际情况不符,你有何看法?

因为人口基数较大,人口增长过快,与我国经济发展水平产生了较大矛盾,所以我国从20世纪70年代逐步实施了计划生育政策。因此这一阶段的人口增长条件并不符合马尔萨斯人口增长模型的条件,自然就出现了依模型得到的结果与实际不符的情况。

• •

在用已知的函数模型刻画实际问题时,应注意模型的适用条件.

下面来解决章引言中的问题.

例 4 2010 年,考古学家对良渚古城水利系统中一条水坝的建筑材料(草裹泥)上提取的草茎遗存进行碳 14 年代学检测,检测出碳 14 的残留量约为初始量的 55.2%,能否以此推断此水坝大概是什么年代建成的?

分析:因为死亡生物机体内碳14的初始量按确定的衰减率衰减,属于指数衰减,所以应选择函数 y=kax(k∈Ry = ka^{x} (k \in \mathbb{R},且 k≠0k \neq 0;a>0a > 0,且 a≠1a \neq 1 建立数学模型.

解:设样本中碳14的初始量为 kk ,衰减率为 p(0<p<1)p(0 < p < 1) ,经过 xx 年后,残余量为yy .根据问题的实际意义,可选择如下模型:

y=k(1−p)xy = k(1 - p)^x (k∈R(k\in \mathbf{R} ,且 k≠0k\neq 0 0<p<10 < p < 1 x⩾0)x\geqslant 0)

由碳 14 的半衰期为 5 730 年,得

k(1−p)5730=12k.k (1 - p) ^ {5 7 3 0} = \frac {1}{2} k.

于是

1−p=125730,1 - p = \sqrt [ 5 7 3 0 ]{\frac {1}{2}},

所以

y=k(125730)x.y = k \left(\sqrt [ 5 7 3 0 ]{\frac {1}{2}}\right) ^ {x}.

由样本中碳 14 的残余量约为初始量的 55.2% 可知,

k(125730)x=55.2%k,k \left(\sqrt [ 5 7 3 0 ]{\frac {1}{2}}\right) ^ {x} = 5 5. 2 \% k,

即

(125730)x=0.552.\left(\sqrt [ 5 7 3 0 ]{\frac {1}{2}}\right) ^ {x} = 0. 5 5 2.

解得

由计算工具得

x=log⁡1257300.552.x≈4912.\begin{array}{r l} x & = \log_ {\sqrt [ 5 7 3 0 ]{\frac {1}{2}}} 0. 5 5 2. \\ x & \approx 4 9 1 2. \end{array}

因为 2010 年之前的 4 912 年是公元前 2903 年,所以推断此水坝大概是公元前 2903 年建成的.

练习

  1. 已知 1650 年世界人口为 5 亿,当时人口的年增长率为 0.3%;1970 年世界人口为 36 亿,当时人口的年增长率为 2.1%.

(1)用马尔萨斯人口模型计算,什么时候世界人口是1650年的2倍?什么时候世界人口是1970年的2倍?

(2)实际上,1850年以前世界人口就超过了10亿;而2004年世界人口还没有达到72亿。你对同样的模型得出的两个结果有何看法?

  1. 在一段时间内,某地的野兔快速繁殖,野兔总只数的倍增期为 21 个月,那么 1 万只野兔增长到 1 亿只野兔大约需要多少年?

3.1959年,考古学家在河南洛阳偃师市区二里头村发掘出了一批古建筑群,从其中的某样本中检测出碳14的残余量约为初始量的 62.76%62.76\% ,能否以此推断二里头遗址大概是什么年代的?

在实际问题中,有的能应用已知的函数模型解决,有的需要根据问题的条件建立函数模型加以解决.

例 5 假设你有一笔资金用于投资,现有三种投资方案供你选择,这三种方案的回报如下:

方案一:每天回报 40 元;

方案二:第一天回报10元,以后每天比前一天多回报10元;

方案三:第一天回报0.4元,以后每天的回报比前一天翻一番.

请问,你会选择哪种投资方案?

分析:我们可以先建立三种投资方案所对应的函数模型,再通过比较它们的增长情况,为选择投资方案提供依据.

解:设第 xx 天所得回报是 yy 元,则方案一可以用函数 y=40(x∈N∗)y = 40(x \in \mathbf{N}^{*}) 进行描述;方案二可以用函数 y=10x(x∈N∗)y = 10x(x \in \mathbf{N}^{*}) 进行描述;方案三可以用函数 y=0.4×2x−1(x∈N∗)y = 0.4 \times 2^{x - 1}(x \in \mathbf{N}^{*}) 进行描述。三个模型中,第一个是常数函数,后两个都是增函数。要对三个方案作出选择,就要对它们的增长情况进行分析。

我们先用信息技术计算一下三种方案所得回报的增长情况(表 4.5-5).

再画出三个函数的图象(图 4.5-7).

函数图象是分析问题的好帮手。为了便于观察,用虚线连接离散的点。

由表4.5-5和图4.5-7可知,方案一的函数是常数函数,方案二、方案三的函数都是增函数,但方案三的函数与方案二的函数的增长情况很不相同。可以看到,尽管方案一、方案二在第1天所得回报分别是方案三的100倍和25倍,但它们的增长量固定不变,而方案三是“指数增长”,其“增长量”是成倍增加的,从第7天开始,方案三比其他两个方案增长得快得多,这种增长速度是方案一、方案二所无法企及的。从每天所得回报看,在第 1∼31\sim 3 天,方案一最

根据这里的分析,是否应作这样的选择:投资5天以下选方案一,投资5~8天选方案二,投资8天以上选方案三?

多;在第4天,方案一和方案二一样多,方案三最少;在第5~8天,方案二最多;第9天开始,方案三比其他两个方案所得回报多得多,到第30天,所得回报已超过2亿元.

下面再看累计的回报数. 通过信息技术列表如下(表4.5-6).

因此,投资1~6天,应选择方案一;投资7天,应选择方案一或方案二;投资8~10天,应选择方案二;投资11天(含11天)以上,则应选择方案三.

上述例子只是一种假想情况,但从中可以看到,不同的函数增长模型,增长变化存在很大差异.

例 6 某公司为了实现 1 000 万元利润的目标,准备制定一个激励销售人员的奖励方案:在销售利润达到 10 万元时,按销售利润进行奖励,且奖金 y(单位:万元)随销售利润 x(单位:万元)的增加而增加,但奖金总数不超过 5 万元,同时奖金不超过利润的 25%。现有三个奖励模型: y=0.25x, y=log⁡7x+1, y=1.002xy=0.25x,\ y=\log_{7}x+1,\ y=1.002^{x} ,其中哪个模型能符合公司的要求?

分析:本例提供了三个不同增长方式的奖励模型,按要求选择其中一个函数作为刻画奖金总数与销售利润的关系。由于公司总的利润目标为1000万元,所以销售人员的销售利润一般不会超过公司总的利润。于是,只需在区间[10,1000]上,寻找并验证所选函数是否满足两条要求:第一,奖金总数不超过5万元,即最大值不大于5;第二,奖金不超过利润的 25%25\% ,即 y⩽0.25xy \leqslant 0.25x 。

不妨先画出函数图象,通过观察函数图象,得到初步的结论,再通过具体计算,确认结果.

解:借助信息技术画出函数 y=5y = 5,y=0.25xy = 0.25x,y=log⁡7x+1y = \log_7 x + 1,y=1.002xy = 1.002^x 的图象(图4.5-8)。观察图象发现,在区间[10,1000]上,模型 y=0.25xy = 0.25x,y=1.002xy = 1.002^x 的图象都有一部分在直线 y=5y = 5 的上方,只有模型 y=log⁡7x+1y = \log_7 x + 1 的图象始终在 y=5y = 5 的下方,这说明只有按模型 y=log⁡7x+1y = \log_7 x + 1 进行奖励时才符合公司的要求。

下面通过计算确认上述判断.

先计算哪个模型的奖金总数不超过 5 万元.

对于模型 y=0.25xy = 0.25x,它在区间[10, 1000]上单调递增,而且当 x=20x = 20 时,y=5y = 5,因此,当 x>20x > 20 时,y>5y > 5,所以该模型不符合要求;

对于模型 y=1.002xy = 1.002^x,由函数图象,并利用信息技术,可知在区间(805,806)内有一个点 x0x_0 满足 1.002x0=51.002^{x_0} = 5,由于它在区间[10,1000]上单调递增,因此当 x>x0x > x_0 时,y>5y > 5,所以该模型也不符合要求;

对于模型 y=log⁡7x+1y = \log_7 x + 1,它在区间[10, 1000]上单调递增,而且当 x=1000x = 1000 时,y=log⁡71000+1≈4.55<5y = \log_7 1000 + 1 \approx 4.55 < 5,所以它符合奖金总数不超过5万元的要求.

再计算按模型 y=log⁡7x+1y = \log_7 x + 1 奖励时,奖金是否不超过利润的 25%25\%,即当 x∈[10,1000]x \in [10, 1000] 时,是否有 y⩽0.25xy \leqslant 0.25x,即 log⁡7x+1⩽0.25x\log_7 x + 1 \leqslant 0.25x 成立.

令 f(x)=log⁡7x+1−0.25x,x∈[10,1 000]f(x)=\log_{7}x+1-0.25x,\quad x\in[10,1\ 000] ,利用信息技术画出它的图象(图 4.5-9).

由图象可知函数 f(x)f(x) 在区间 [10,1 000][10, 1\ 000] 上单调递减,因此

f(x)⩽f(10)≈−0.3167<0,f (x) \leqslant f (1 0) \approx - 0. 3 1 6 7 < 0,

即

log⁡7x+1<0.25x.\log_ {7} x + 1 < 0. 2 5 x.

所以,当 x∈[10,1000]x \in [10, 1000] 时,y⩽0.25xy \leqslant 0.25x,说明按模型 y=log⁡7x+1y = \log_7 x + 1 奖励,奖金不会超过利润的 25%25\%.

综上所述,模型 y=log⁡7x+1y=\log_{7}x+1 确实能符合公司要求.

归纳

用函数建立数学模型解决实际问题的基本过程如下:

这一过程包括分析和理解实际问题的增长情况(是“对数增长”“直线上升”还是“指数爆炸”);根据增长情况选择函数类型构建数学模型,将实际问题化归为数学问题;通过运算、推理求解函数模型;用得到的函数模型描述实际问题的变化规律,解决有关问题。在这一过程中,往往需要利用信息技术帮助画图、运算等。

练习

  1. 某地今年1月,2月,3月患某种传染病的人数分别为52,61,68. 为了预测以后各月的患病人数,甲选择了模型 y=ax2+bx+cy = ax^{2} + bx + c,乙选择了模型 y=pqx+ry = pq^{x} + r,其中 yy 为患病人数, xx 为月份数, aa, bb, cc, pp, qq, rr 都是常数. 结果4月,5月,6月份的患病人数分别为74,78,83,你认为谁选择的模型更符合实际?

  2. 由于提高了养殖技术并扩大了养殖规模,某地的肉鸡产量在不断增加。2008~2018年的11年,上市的肉鸡数量如下:

同期该地的人口数如下:

(1)分别求出能近似地反映上述两组数据变化规律的函数;

(2)如果2017年该地上市的肉鸡基本能满足本地的需求,那么2018年是否能满足市场的需求?

(3)按上述两表的变化趋势,你对该地2018年后肉鸡市场的发展有何建议?

习题4.5

复习巩固

  1. 下列函数图象与 xx 轴均有交点, 其中不能用二分法求其零点的是____. (填至上所有符合条件的图号)
①
②
③
④

函数 y=f(x)y = f(x) 在哪几个区间内一定有零点?为什么?

  1. 已知函数 f(x)=x3−2x+1f(x) = x^3 - 2x + 1,求证:方程 f(x)=xf(x) = x 在 (−1,2)(-1, 2) 内至少有两个实数解.

  2. 利用信息技术,用二分法求函数 f(x)=ln⁡x−2xf(x) = \ln x - \frac{2}{x} 的零点(精确度为0.1).

  3. 利用信息技术,用二分法求方程 0.8x−1=ln⁡x0.8^{x} - 1 = \ln x 的近似解(精确度为0.1).

  4. 一种专门占据内存的计算机病毒,开机时占据内存 2 KB,然后每 3 分自身复制一次,复制后所占内存是原来的 2 倍。那么开机后多少分,该病毒会占据 64 MB 内存(1 MB=1024 KB)?

综合运用

  1. 设函数 f(x)=ax2+bx+c(a>0,b,c∈R)f(x) = ax^{2} + bx + c (a > 0, b, c \in \mathbb{R}),且 f(1)=−a2f(1) = -\frac{a}{2},求证:函数 f(x)f(x) 在 (0, 2)

  2. 已知函数 f(x)=−x2−3x−2f(x) = -x^{2} - 3x - 2,g(x)=2−[f(x)]2g(x) = 2 - [f(x)]^{2},

(1) 求函数 y=g(x)y=g(x) 的解析式;

(2) 利用信息技术,画出函数 y=g(x)y=g(x) 的图象;

(3) 求函数 y=g(x)y=g(x) 的零点(精确度为 0.1).

  1. 如图,某池塘里浮萍的面积 yy (单位: m2\mathrm{m}^2 )与时间 tt (单位:月)的关系为 y=aty = a^t. 关于下列说法:

① 浮萍每月的增长率为 1;

② 第 5 个月时,浮萍面积就会超过 30 m230 \, m^{2} ;

③ 浮萍每月增加的面积都相等;

(第9题)

④ 若浮萍蔓延到 2m22\mathrm{m}^2 , 3m23\mathrm{m}^2 , 6m26\mathrm{m}^2 所经过的时间分别是 t1t_1 , t2t_2 , t3t_3 ,则 t1+t2=t3t_1 + t_2 = t_3

其中正确的说法是().

(A) ①② (B) ①②③ (C) ①②④ (D) ①②③④

  1. 一种药在病人血液中的量保持在 1500mg1500 \mathrm{mg} 以上时才有疗效,而低于 500mg500 \mathrm{mg} 时病人就有危险。现给某病人的静脉注射了这种药 2500mg2500 \mathrm{mg},如果药在血液中以每小时 20%20\% 的比例衰减,那么应在什么时间范围再向病人的血液补充这种药(精确到 0.1 h0.1 \mathrm{~h})?

  2. 人类已进入大数据时代. 目前, 数据量已经从 TB (1 TB = 1024 GB) 级别跃升到 PB (1 PB = 1024 TB), EB (1 EB = 1024 PB) 乃至 ZB (1 ZB = 1024 EB) 级别. 曾经的研究结果表明, 2008 年全球产生的数据量为 0.49 ZB, 2009 年的数据量为 0.8 ZB, 2010 年增长到 1.2 ZB, 2011 年的数据量更是高达 1.82 ZB.

(1)为了较好地描述2008年起全球产生的数据量与时间 xx (单位:年)的关系,根据上述数据信息,从函数 f(x)=kx+bf(x) = kx + b 和 g(x)=abxg(x) = ab^{x} 中选择一个,并求出解析式.

(2) 根据(1)中所求函数模型,估计 2018 年全球所产生的数据量,并与所公布数据比较,你有何看法?

  1. 某地不同身高的未成年男性的体重平均值如下表:

(1) 根据表中提供的数据建立恰当的函数模型,使它能近似地反映这个地区未成年男性平均体重 yy (单位: kg\mathrm{kg} )与身高 xx (单位: cm\mathrm{cm} )的函数关系,并写出这个函数的解析式.

(2) 若体重超过相同身高男性体重平均值的 1.2 倍为偏胖,低于 0.8 倍为偏瘦,那么该地一名身高为 175 cm,体重为 78 kg 的在校男生的体重是否正常?

拓广探索

  1. 有一道题 “若函数 f(x)=24ax2+4x−1f(x)=24ax^{2}+4x-1 在区间 (−1,1)(-1,1) 内恰有一个零点,求实数 a 的取值范围”,某同学给出了如下解答: 由 f(−1)f(1)=(24a−5)(24a+3)<0f(-1)f(1)=(24a-5)(24a+3)<0 ,解得 −18<a<524-\frac{1}{8}<a<\frac{5}{24} . 所以,实数 a 的取值范围是 (−18,524)\left(-\frac{1}{8}, \frac{5}{24}\right) . 上述解答正确吗?若不正确,请说明理由,并给出正确的解答.

  2. 从甲地到乙地的距离约为 240 km,经多次实验得到一辆汽车每小时耗油量 Q(单位:L)与速度 v(单位:km/h)(0≤v≤120)的下列数据:

为了描述汽车每小时耗油量与速度的关系,现有以下三种模型供选择:

Q=av3+bv2+cv,Q=0.5v+a,Q=klog⁡av+b.Q = a v ^ {3} + b v ^ {2} + c v, Q = 0. 5 ^ {v} + a, Q = k \log_ {a} v + b.

(1) 选出你认为最符合实际的函数模型,并写出相应的函数解析式;

(2) 从甲地到乙地,这辆车应以什么速度行驶才能使总耗油量最少?

文献阅读与数学写作

对数概念的形成与发展

对数的发明、解析几何的创始和微积分的建立被恩格斯并称为17世纪数学的三大成就。对数的发明及其计算是数学史上的重大事件,天文学界更是以近乎狂喜的心情来迎接这一发明。意大利科学家伽利略(Galileo Galilei,1564—1642)说:“给我空间、时间及对数,我就可以创造一个宇宙。”法国数学家拉普拉斯(P._S. Laplace,1749—1827)也曾评价道:“因为省时省力,对数倍增了天文学家的寿命。”

作为重要而简便的计算工具,对数是如何产生和发展的?在数学的发展、人类社会的发展历史中起了什么作用?请你按以下要求,查阅与对数有关的文献,自己选题,写一篇数学小论文。

一、主题

  1. 对数概念形成和发展的过程.

  2. 对数对简化运算的作用.

二、实施建议

  1. 选题:根据个人兴趣,围绕主题,初步确定选题范围.

  2. 分组:将相近选题的 5~6 人分为一个小组,确定一名组长.

  3. 分配任务:根据个人的具体情况,经小组共同商议,由组长确定每人的具体任务。

  4. 搜集资料:针对具体的论文题目,通过互联网、书店、图书馆等多种途径搜集素材,包括文字、图片、数据以及音像资料,并记录相关资料。

  5. 素材整理:用论文的形式展现小组的实践成果.

  6. 交流讨论:开展组内或全班的交流、讨论和总结.

三、参考选题

  1. 对数产生的背景.

  2. 对数发明的过程.

  3. 对数的具体应用.

  4. 对数对简化运算的作用.

  5. 对数对人类文明进步的贡献.

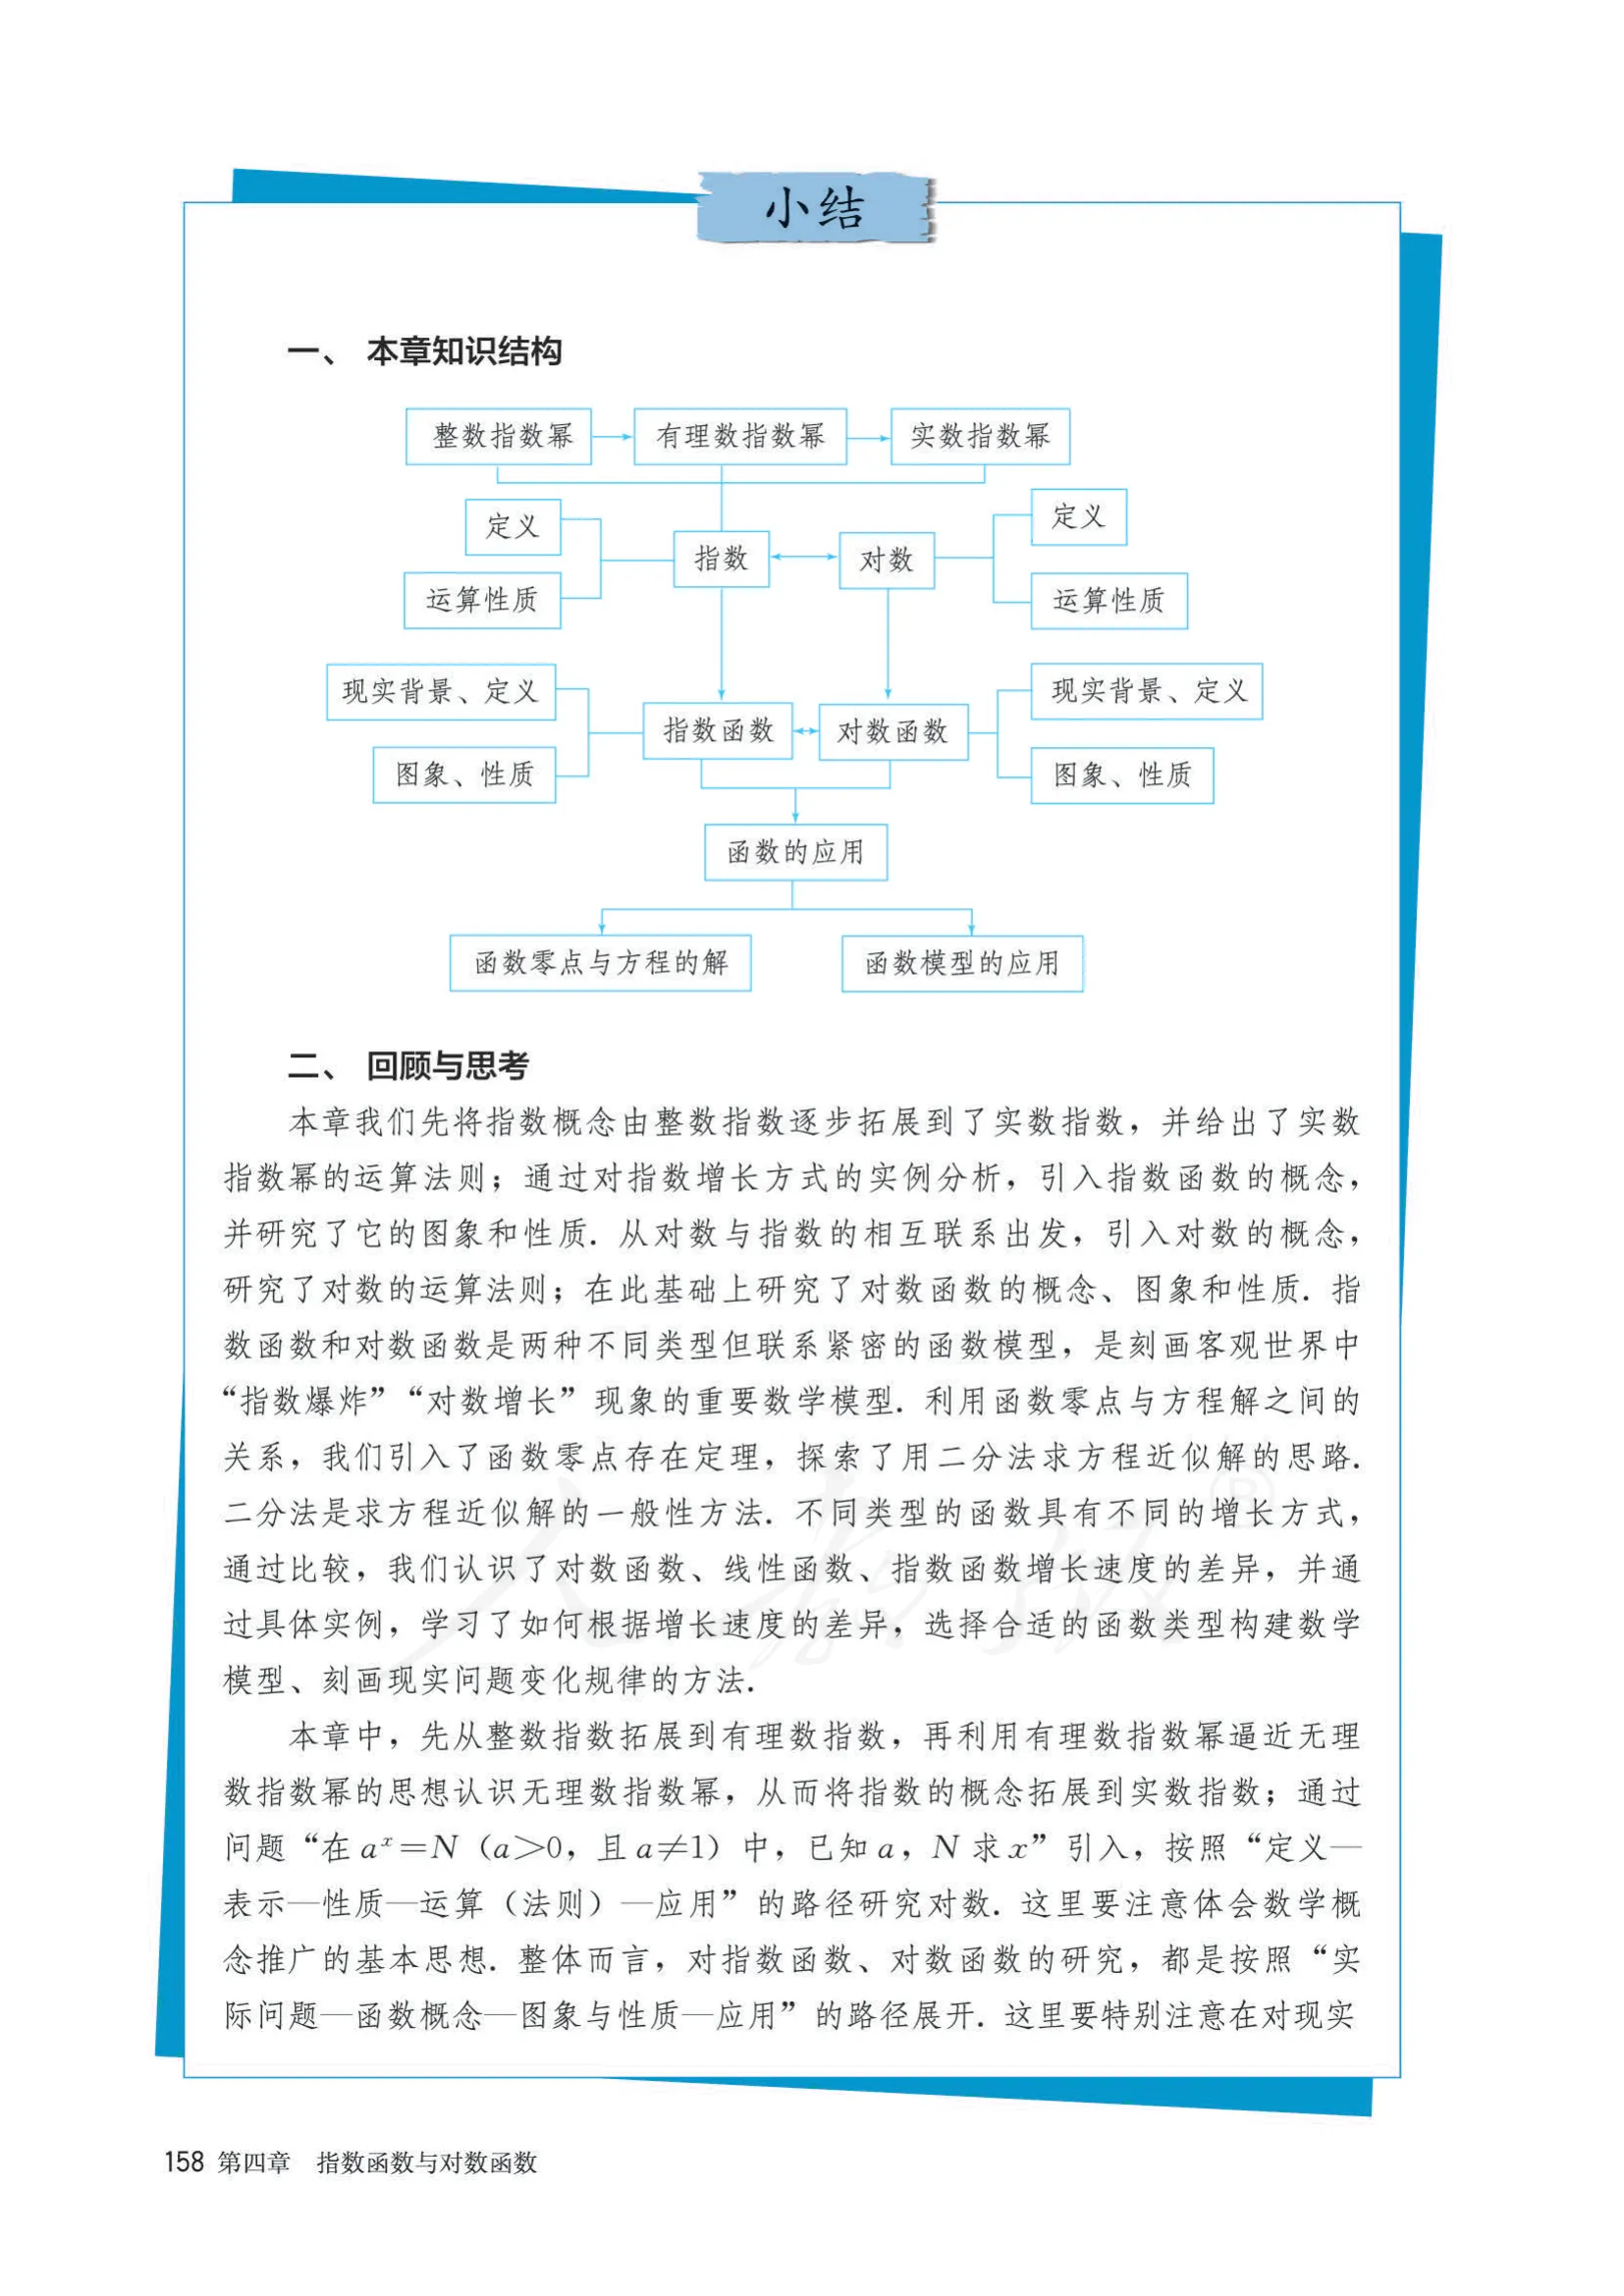
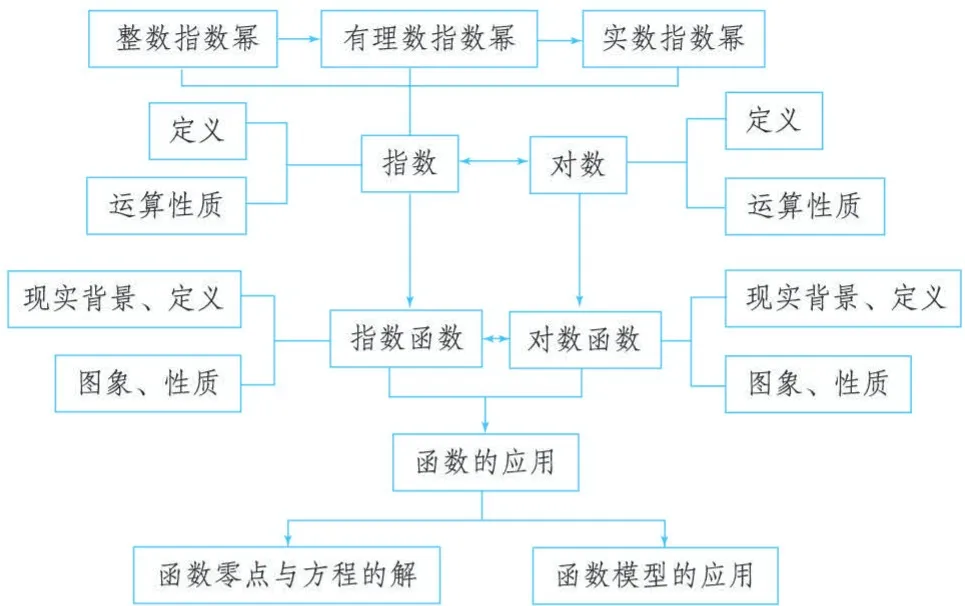
一、本章知识结构

二、回顾与思考

本章我们先将指数概念由整数指数逐步拓展到了实数指数,并给出了实数指数幂的运算法则;通过对指数增长方式的实例分析,引入指数函数的概念,并研究了它的图象和性质。从对数与指数的相互联系出发,引入对数的概念,研究了对数的运算法则;在此基础上研究了对数函数的概念、图象和性质。指数函数和对数函数是两种不同类型但联系紧密的函数模型,是刻画客观世界中“指数爆炸”“对数增长”现象的重要数学模型。利用函数零点与方程解之间的关系,我们引入了函数零点存在定理,探索了用二分法求方程近似解的思路。二分法是求方程近似解的一般性方法。不同类型的函数具有不同的增长方式,通过比较,我们认识了对数函数、线性函数、指数函数增长速度的差异,并通过具体实例,学习了如何根据增长速度的差异,选择合适的函数类型构建数学模型、刻画现实问题变化规律的方法。

本章中,先从整数指数拓展到有理数指数,再利用有理数指数幂逼近无理数指数幂的思想认识无理数指数幂,从而将指数的概念拓展到实数指数;通过问题“在 ax=Na^x = N (a>0a > 0,且 a≠1a \neq 1)中,已知 aa,NN 求 xx”引入,按照“定义—表示—性质—运算(法则)—应用”的路径研究对数。这里要注意体会数学概念推广的基本思想。整体而言,对指数函数、对数函数的研究,都是按照“实际问题—函数概念—图象与性质—应用”的路径展开。这里要特别注意在对现实问题增长方式分析的基础上引入相应的函数概念,再通过对函数图象、性质的研究,把握相应函数的本质。这是建立函数模型解决实际问题的基础。

在应用函数解决实际问题时,首先应注意分析实际问题属于哪种类型的增长方式,这是选择和建立函数模型的基础;其次,要注意理解用函数构建数学模型的基本过程,体会运用模型思想发现和提出问题、分析和解决问题的数学方法。

请你带着下面的问题,复习一下全章内容吧!

  1. 指数和对数的概念都有现实背景,你能举出一些实际例子吗?

  2. 概述指数概念的拓展过程,你能由此说说数学概念拓展的过程与方法吗?

  3. 对数概念是如何提出来的?它对发现和提出问题有什么启示?

  4. 回忆指数函数、对数函数的研究过程,你能由此说说如何研究一类函数吗?例如研究的内容、过程和方法。

  5. 不同函数模型刻画了现实世界不同类型问题的变化规律,你能说说指数函数和对数函数分别刻画了怎样的变化规律吗?你能举出“直线上升”“对数增长”“指数爆炸”的实际例子吗?

  6. 你能举例说明函数的零点与方程解的关系吗?在什么条件下,函数在 (a,b)(a, b) 内一定有零点?

  7. 你能说说用二分法求方程近似解的一般步骤吗?

  8. 你能结合实例说明应用函数模型解决问题的基本过程吗?

  9. 函数图象是研究函数性质的重要载体,信息技术是研究函数图象与性质的有力工具,你能结合实例谈谈这方面的体会吗?

复习参考题4

复习巩固

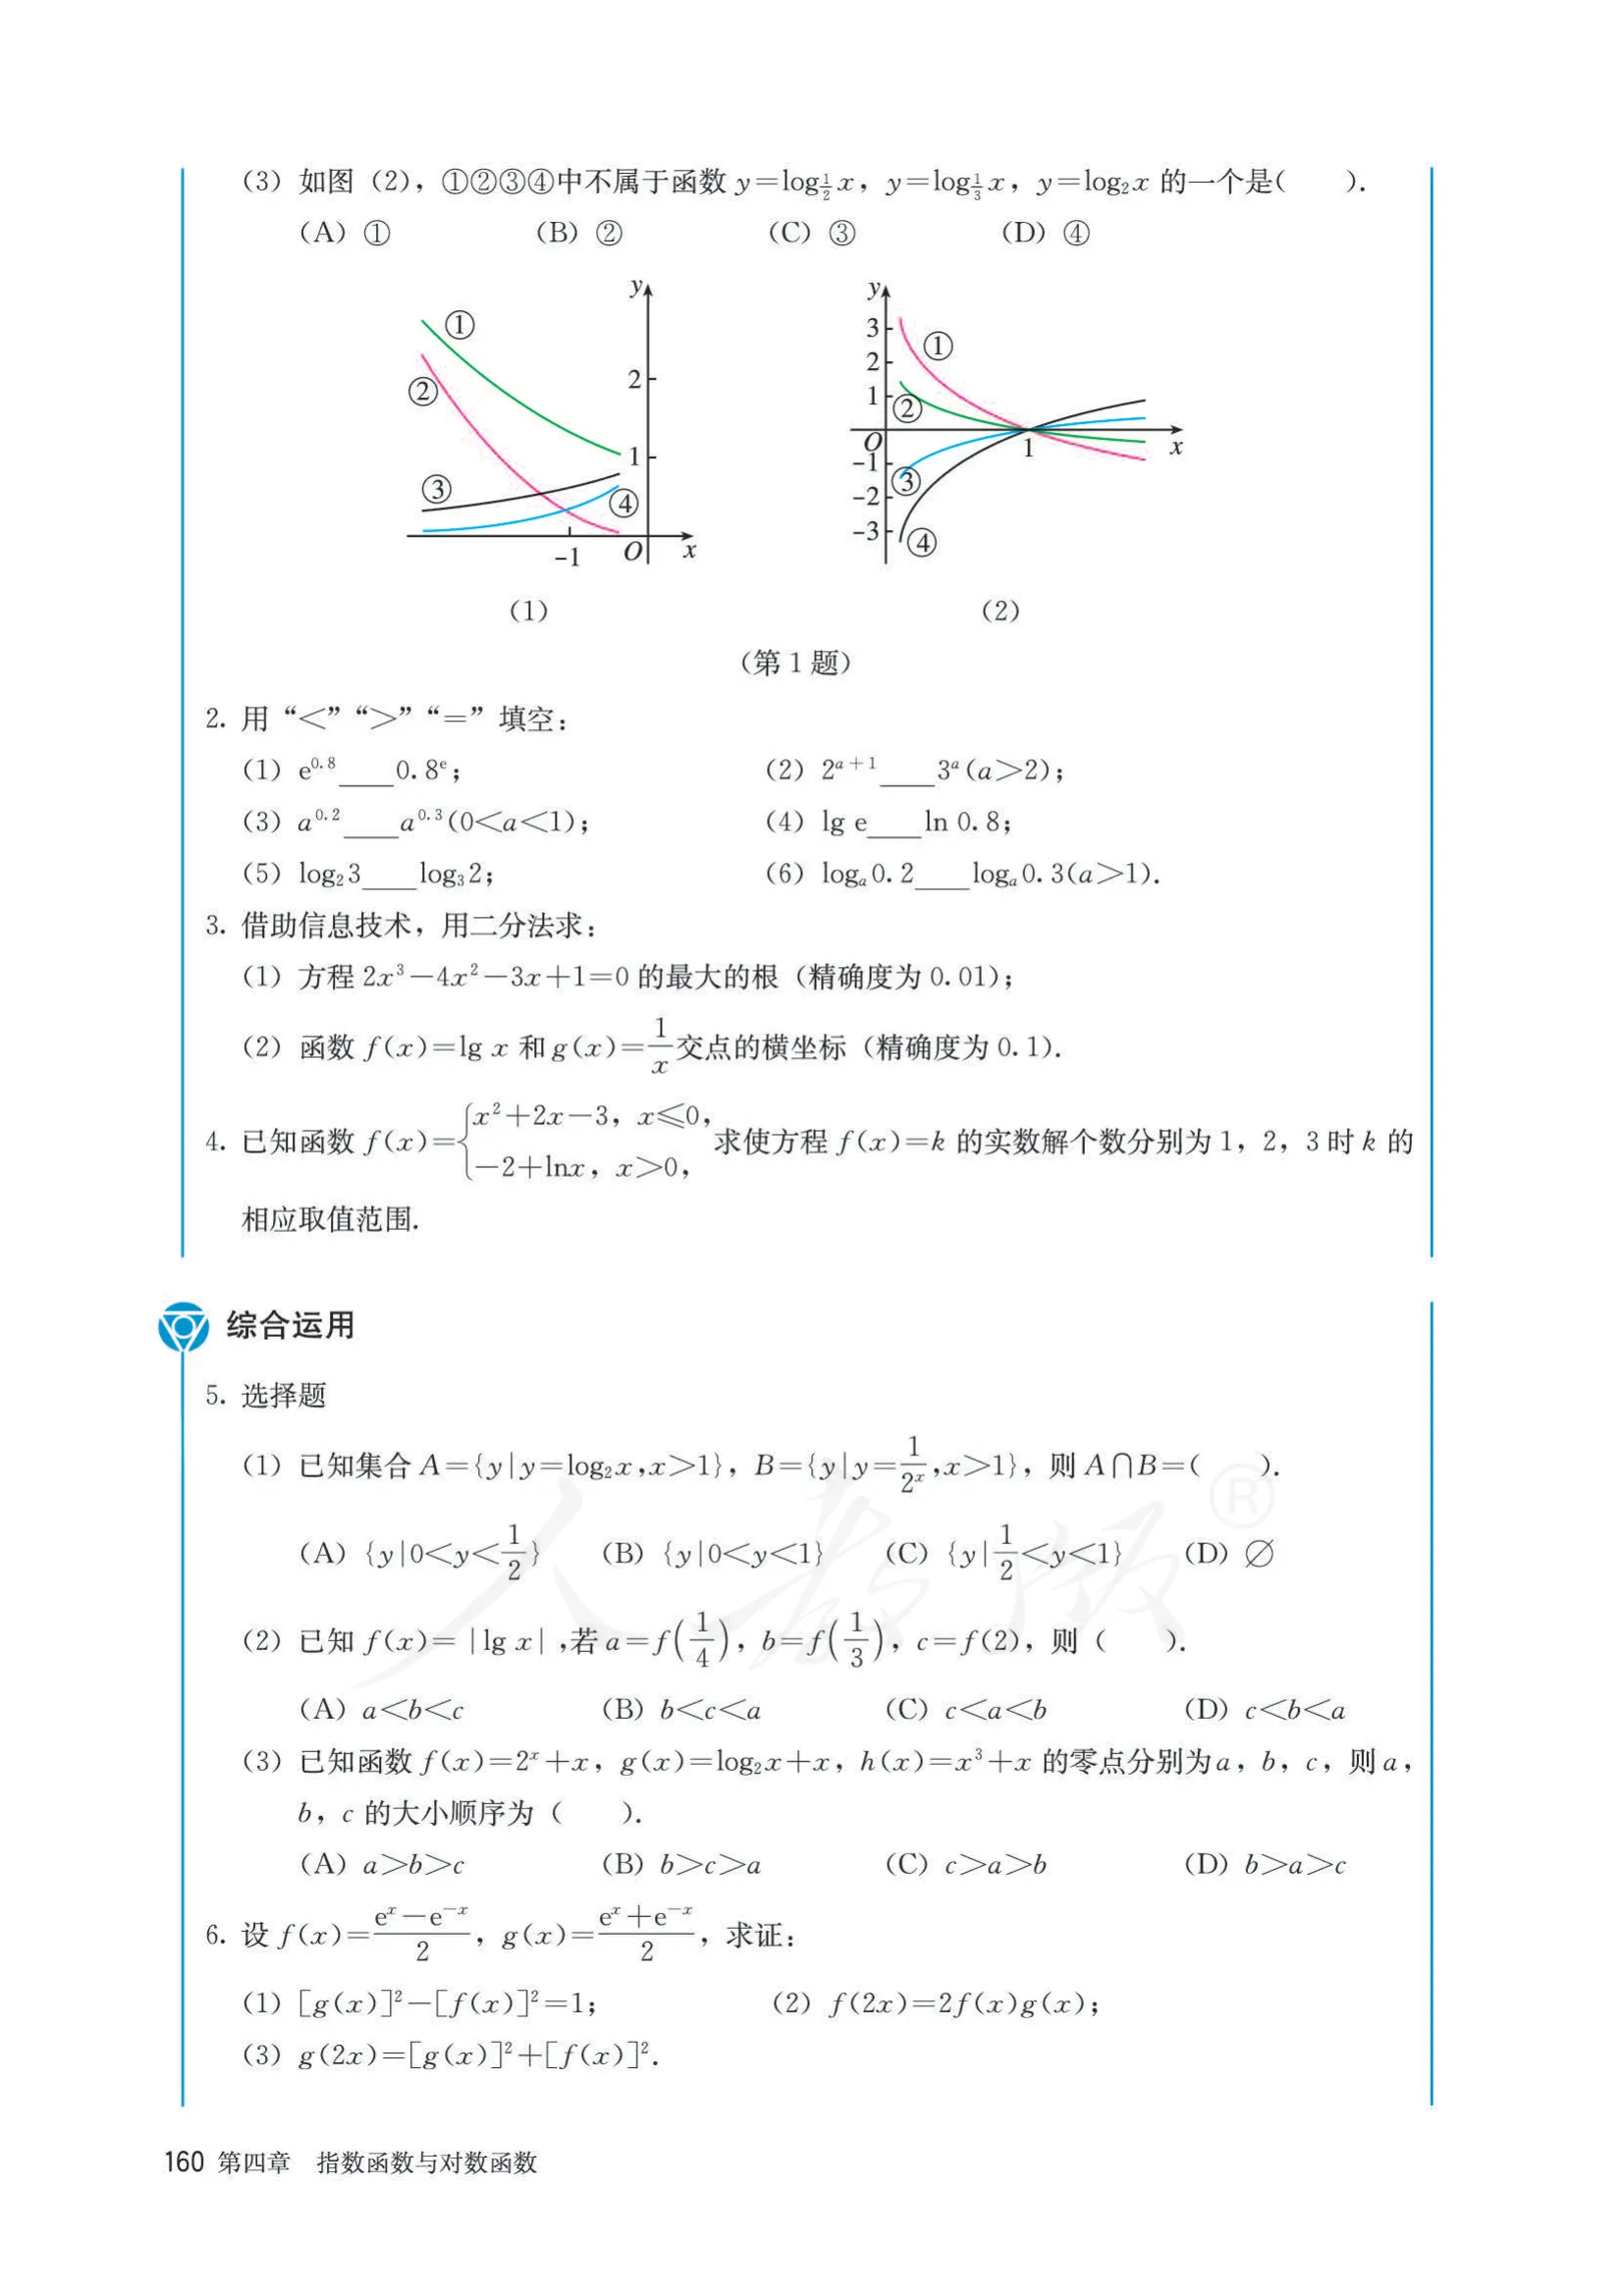
  1. 选择题

(1) 函数 y=−2−xy = -2^{-x} 与 y=2xy = 2^{x} 的图象(). (A) 关于 x 轴对称 (B) 关于 y 轴对称 (C) 关于原点对称 (D) 关于直线 y = x 对称

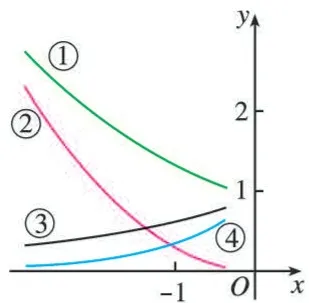
(2) 如图 (1), ①②③④中不属于函数 y=2xy = 2^{x}, y=6xy = 6^{x}, y=(12)xy = \left(\frac{1}{2}\right)^{x} 的一个是 ( ). (A) ① (B) ② (C) ③ (D) ④

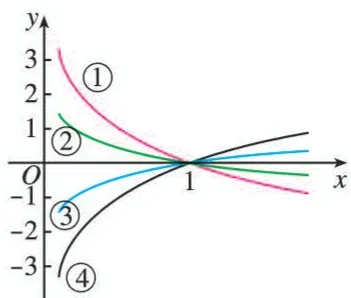
(3) 如图 (2), ①②③④中不属于函数 y=log⁡12xy = \log_{\frac{1}{2}}x, y=log⁡13xy = \log_{\frac{1}{3}}x, y=log⁡2xy = \log_2x 的一个是 ( ). (A) ① (B) ② (C) ③ (D) ④

(1)

(2)

(第1题)

  1. 用“<”“>”“=”填空: (1) e0.8e^{0.8} ____ 0.8 e^{e} ; (2) 2a+12^{a+1} ____ 3a(a>2)3^{a}(a>2) ; (3) a0.2a^{0.2} ____ a0.3(0<a<1)a^{0.3}(0<a<1) ; (4) lg⁡eln⁡0.8;\lg e \ln 0.8; (5) log⁡23\log_{2}3 ____ log⁡32;\log_{3}2; (6) log⁡a0.2\log_{a}0.2 ____ log⁡a0.3(a>1).\log_{a}0.3(a>1).

  2. 借助信息技术,用二分法求:

(1) 方程 2x3−4x2−3x+1=02x^{3}-4x^{2}-3x+1=0 的最大的根(精确度为 0.01);

(2) 函数 f(x)=lg⁡xf(x)=\lg x 和 g(x)=1xg(x)=\frac{1}{x} 交点的横坐标(精确度为 0.1).

  1. 已知函数 f(x)={x2+2x−3,x⩽0,−2+ln⁡x,x>0,f(x) = \begin{cases} x^2 + 2x - 3, & x \leqslant 0, \\ -2 + \ln x, & x > 0, \end{cases} 求使方程 f(x)=kf(x) = k 的实数解个数分别为 1, 2, 3 时 kk 的相应取值范围.

综合运用

5. 选择题

(1) 已知集合 A={y∣y=log⁡2x,x>1}A = \{y \mid y = \log_2 x, x > 1\},B={y∣y=12x,x>1}B = \{y \mid y = \frac{1}{2^x}, x > 1\},则 A∩B=()A \cap B = (\quad)。

(A) {y∣0<y<12}\{y \mid 0 < y < \frac{1}{2}\} (B) {y∣0<y<1}\{y \mid 0 < y < 1\} (C) {y∣12<y<1}\{y \mid \frac{1}{2} < y < 1\} (D) ∅\varnothing

(2) 已知 f(x)=∣lg⁡x∣f(x)=|\lg x| ,若 a=f(14)a=f\left(\frac{1}{4}\right) , b=f(13)b=f\left(\frac{1}{3}\right) ,c=f(2),则(). (A) a < b < c (B) b < c < a (C) c < a < b (D) c < b < a

(3) 已知函数 f(x)=2x+xf(x) = 2^x + x,g(x)=log⁡2x+xg(x) = \log_2 x + x,h(x)=x3+xh(x) = x^3 + x 的零点分别为 a,b,ca, b, c,则 a,b,ca, b, c 的大小顺序为().

(A) a>b>ca > b > c (B) b>c>ab > c > a (C) c>a>bc > a > b (D) b>a>cb > a > c

  1. 设 f(x)=ex−e−x2f(x) = \frac{\mathrm{e}^x - \mathrm{e}^{-x}}{2},g(x)=ex+e−x2g(x) = \frac{\mathrm{e}^x + \mathrm{e}^{-x}}{2},求证:(1) [g(x)]2−[f(x)]2=1[g(x)]^2 - [f(x)]^2 = 1;(2) f(2x)=2f(x)g(x)f(2x) = 2f(x)g(x); (3) g(2x)=[g(x)]2+[f(x)]2g(2x) = [g(x)]^2 + [f(x)]^2.
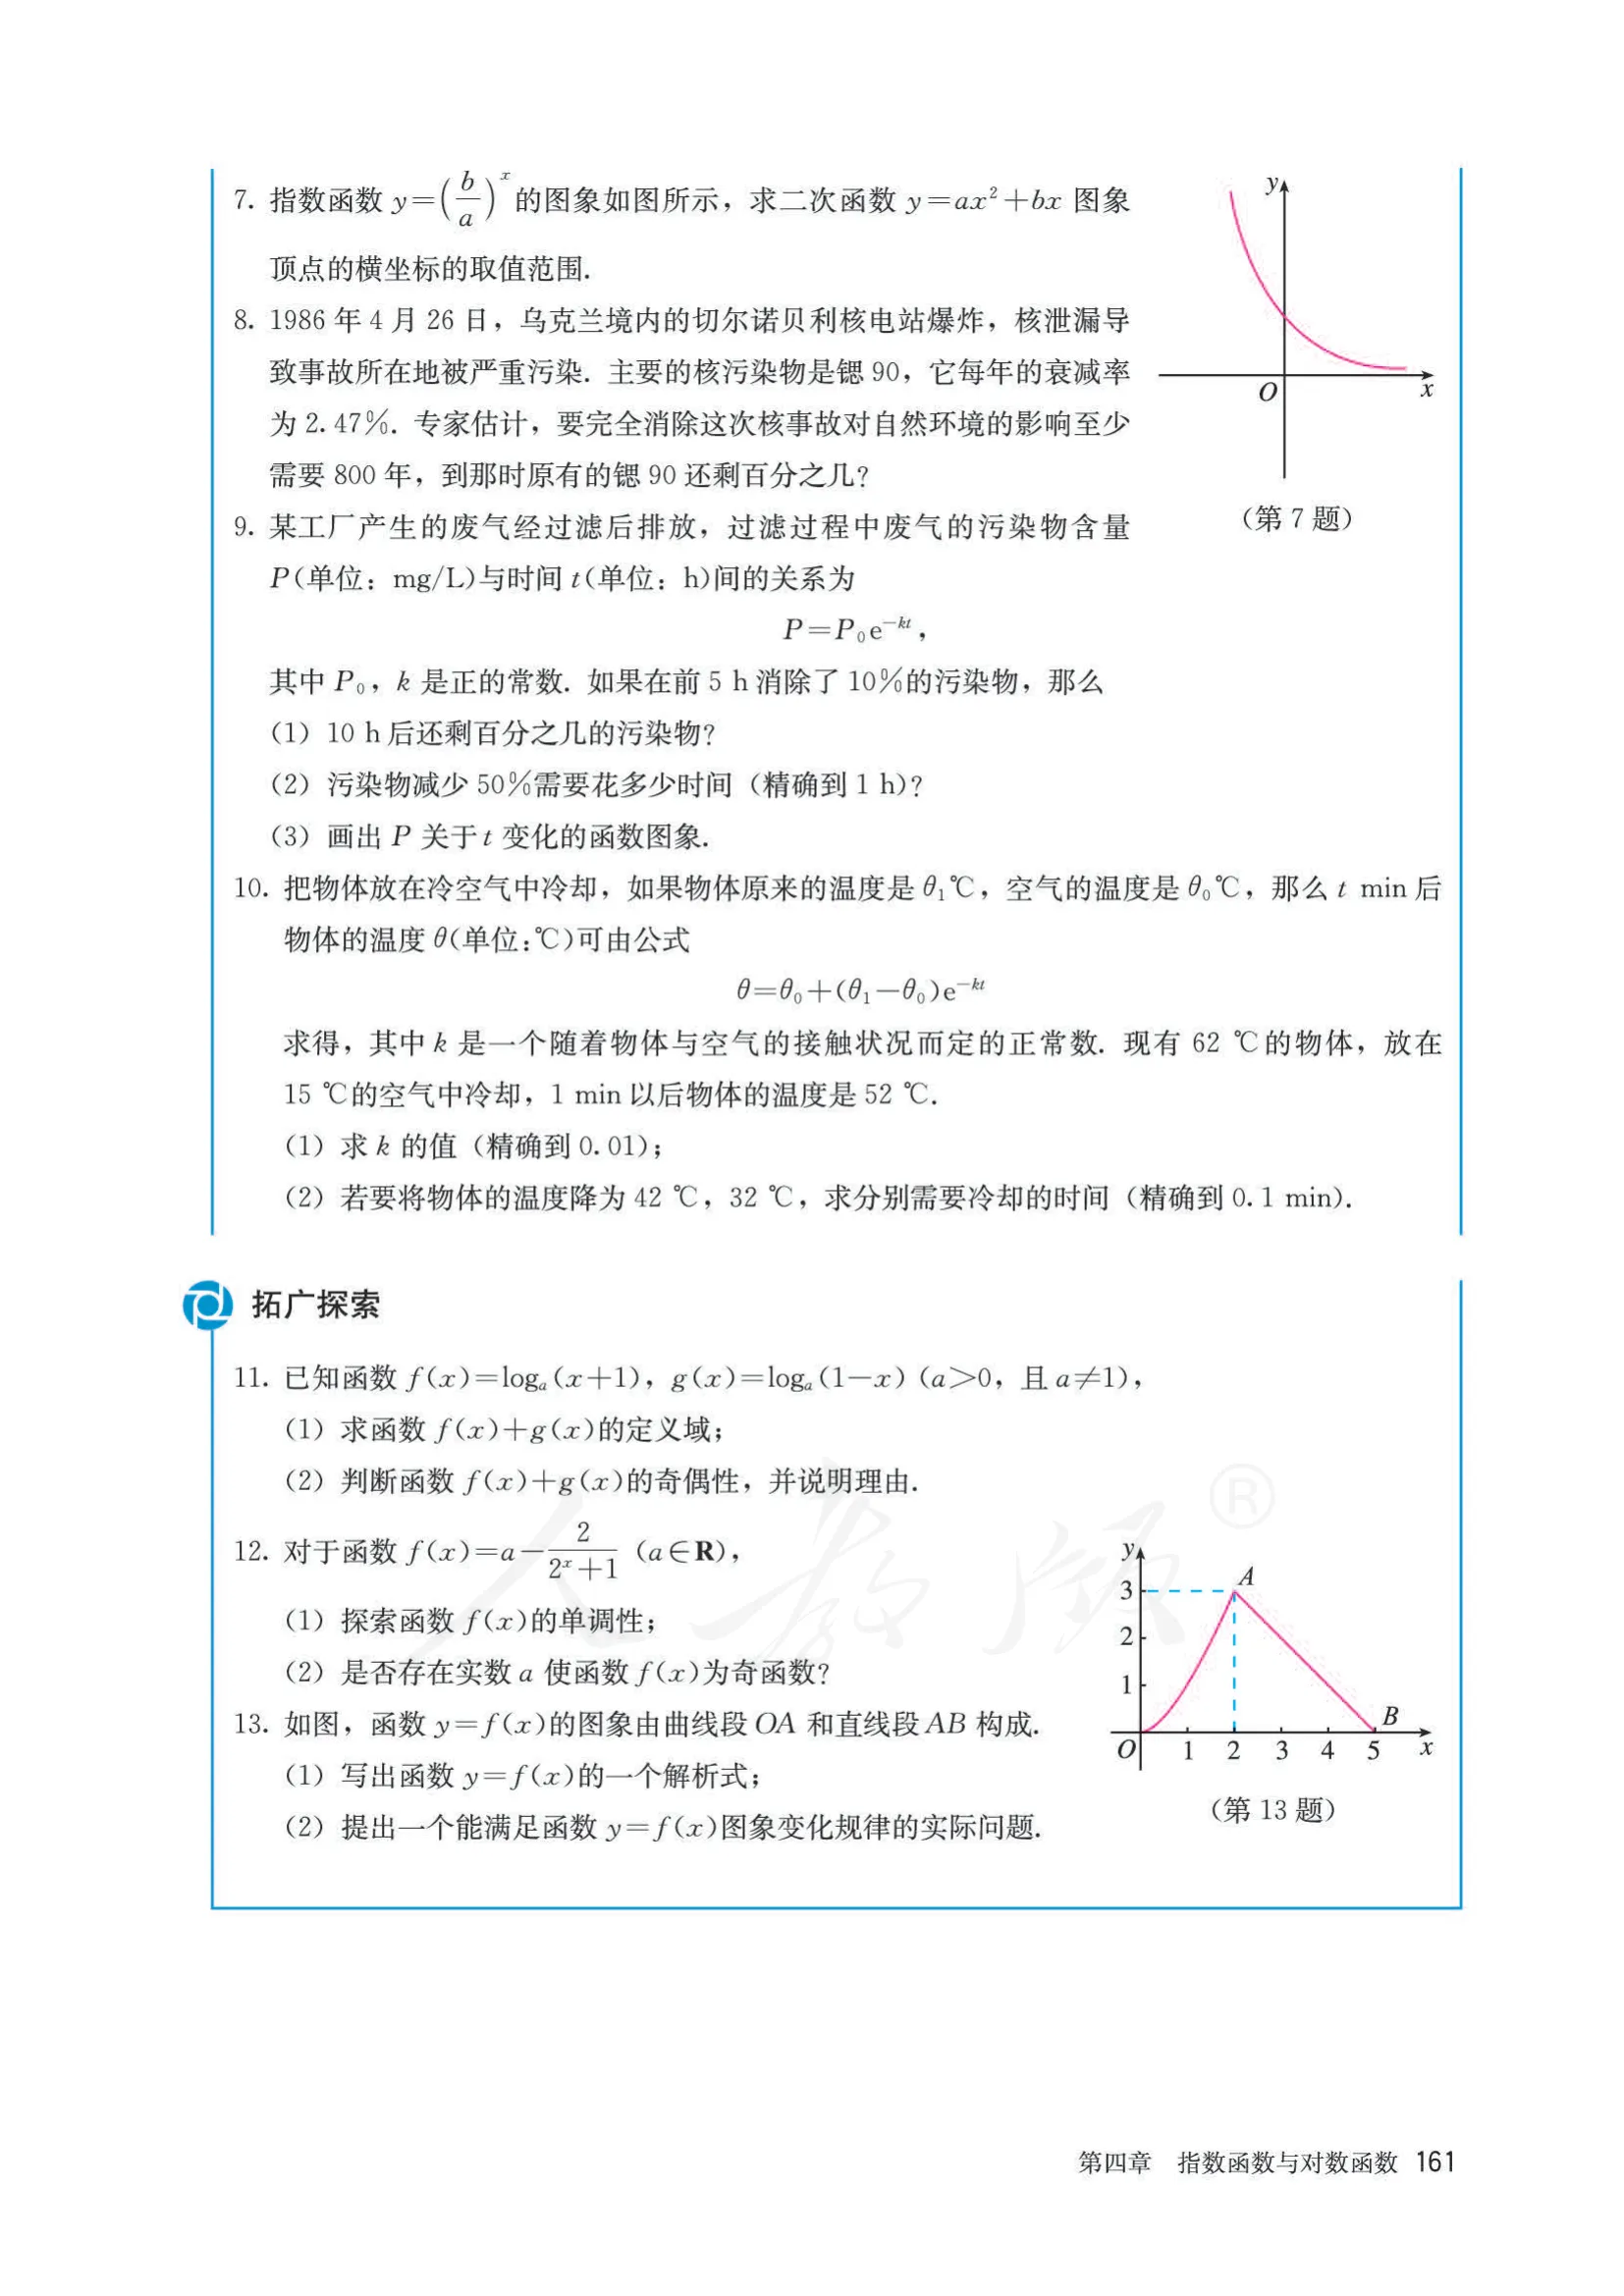
  1. 指数函数 y=(ba)xy = \left(\frac{b}{a}\right)^x 的图象如图所示,求二次函数 y=ax2+bxy = ax^2 + bx 图象顶点的横坐标的取值范围.

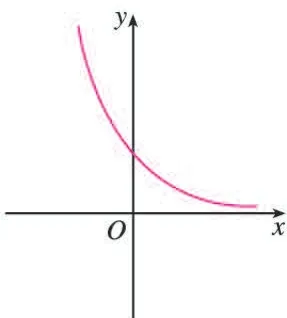
  2. 1986 年 4 月 26 日,乌克兰境内的切尔诺贝利核电站爆炸,核泄漏导致事故所在地被严重污染。主要的核污染物是锶 90,它每年的衰减率为 2.47%。专家估计,要完全消除这次核事故对自然环境的影响至少需要 800 年,到那时原有的锶 90 还剩百分之几?
(第7题)

  1. 某工厂产生的废气经过滤后排放,过滤过程中废气的污染物含量 PP (单位: mg/L\mathrm{mg / L} )与时间 tt (单位: h\mathrm{h} )间的关系为

P=P0e−kt,P = P _ {0} \mathrm{e} ^ {- k t},

其中 P0P_0 , kk 是正的常数.如果在前 5h5\mathrm{h} 消除了 10%10\% 的污染物,那么(1) 10h10\mathrm{h} 后还剩百分之几的污染物?(2)污染物减少 50%50\% 需要花多少时间(精确到 1h)1\mathrm{h}) ?(3)画出 PP 关于 tt 变化的函数图象.

  1. 把物体放在冷空气中冷却,如果物体原来的温度是 θ1∘C\theta_{1}^{\circ}C ,空气的温度是 θ0∘C\theta_{0}^{\circ}C ,那么 t min 后物体的温度 θ\theta (单位:℃)可由公式

θ=θ0+(θ1−θ0)e−kt\theta=\theta_{0}+(\theta_{1}-\theta_{0})\mathrm{e}^{-kt}

求得,其中 k 是一个随着物体与空气的接触状况而定的正常数。现有 62∘C62^{\circ}C 的物体,放在 15∘C15^{\circ}C 的空气中冷却,1 min 以后物体的温度是 52∘C52^{\circ}C 。

(1) 求 k 的值(精确到 0.01); (2) 若要将物体的温度降为 42∘C42^{\circ}C , 32∘C32^{\circ}C ,求分别需要冷却的时间(精确到 0.1 min)。

拓广探索

  1. 已知函数 f(x)=log⁡a(x+1)f(x) = \log_a(x + 1),g(x)=log⁡a(1−x)g(x) = \log_a(1 - x) (a>0a > 0,且 a≠1a \neq 1), (1) 求函数 f(x)+g(x)f(x) + g(x) 的定义域; (2) 判断函数 f(x)+g(x)f(x) + g(x) 的奇偶性,并说明理由.
  2. 对于函数 f(x)=a−22x+1f(x) = a - \frac{2}{2^x + 1} (a∈Ra \in \mathbb{R}), (1) 探索函数 f(x)f(x) 的单调性; (2) 是否存在实数 aa 使函数 f(x)f(x) 为奇函数?
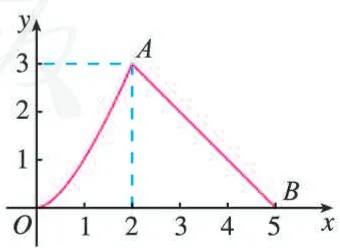
  3. 如图,函数 y=f(x)y = f(x) 的图象由曲线段 OAOA 和直线段 ABAB 构成。 (1) 写出函数 y=f(x)y = f(x) 的一个解析式; (2) 提出一个能满足函数 y=f(x)y = f(x) 图象变化规律的实际问题.

(第 13 题)

建立函数模型解决实际问题

我们知道,用函数构建数学模型解决实际问题时,首先要对实际问题中的变化过程进行分析,析出其中的常量、变量及其相互关系;明确其运动变化的基本特征,从而确定它的运动变化类型。然后根据分析结果,选择适当的函数类型构建数学模型,将实际问题化归为数学问题;再通过运算、推理,求解函数模型。最后利用函数模型的解说明实际问题的变化规律,达到解决问题的目的。在构建函数模型时,经常会遇到没有现成数据可用的情况,这时就需要先收集数据。

一、数学建模活动的一个实例

1. 观察实际情景,发现和提出问题

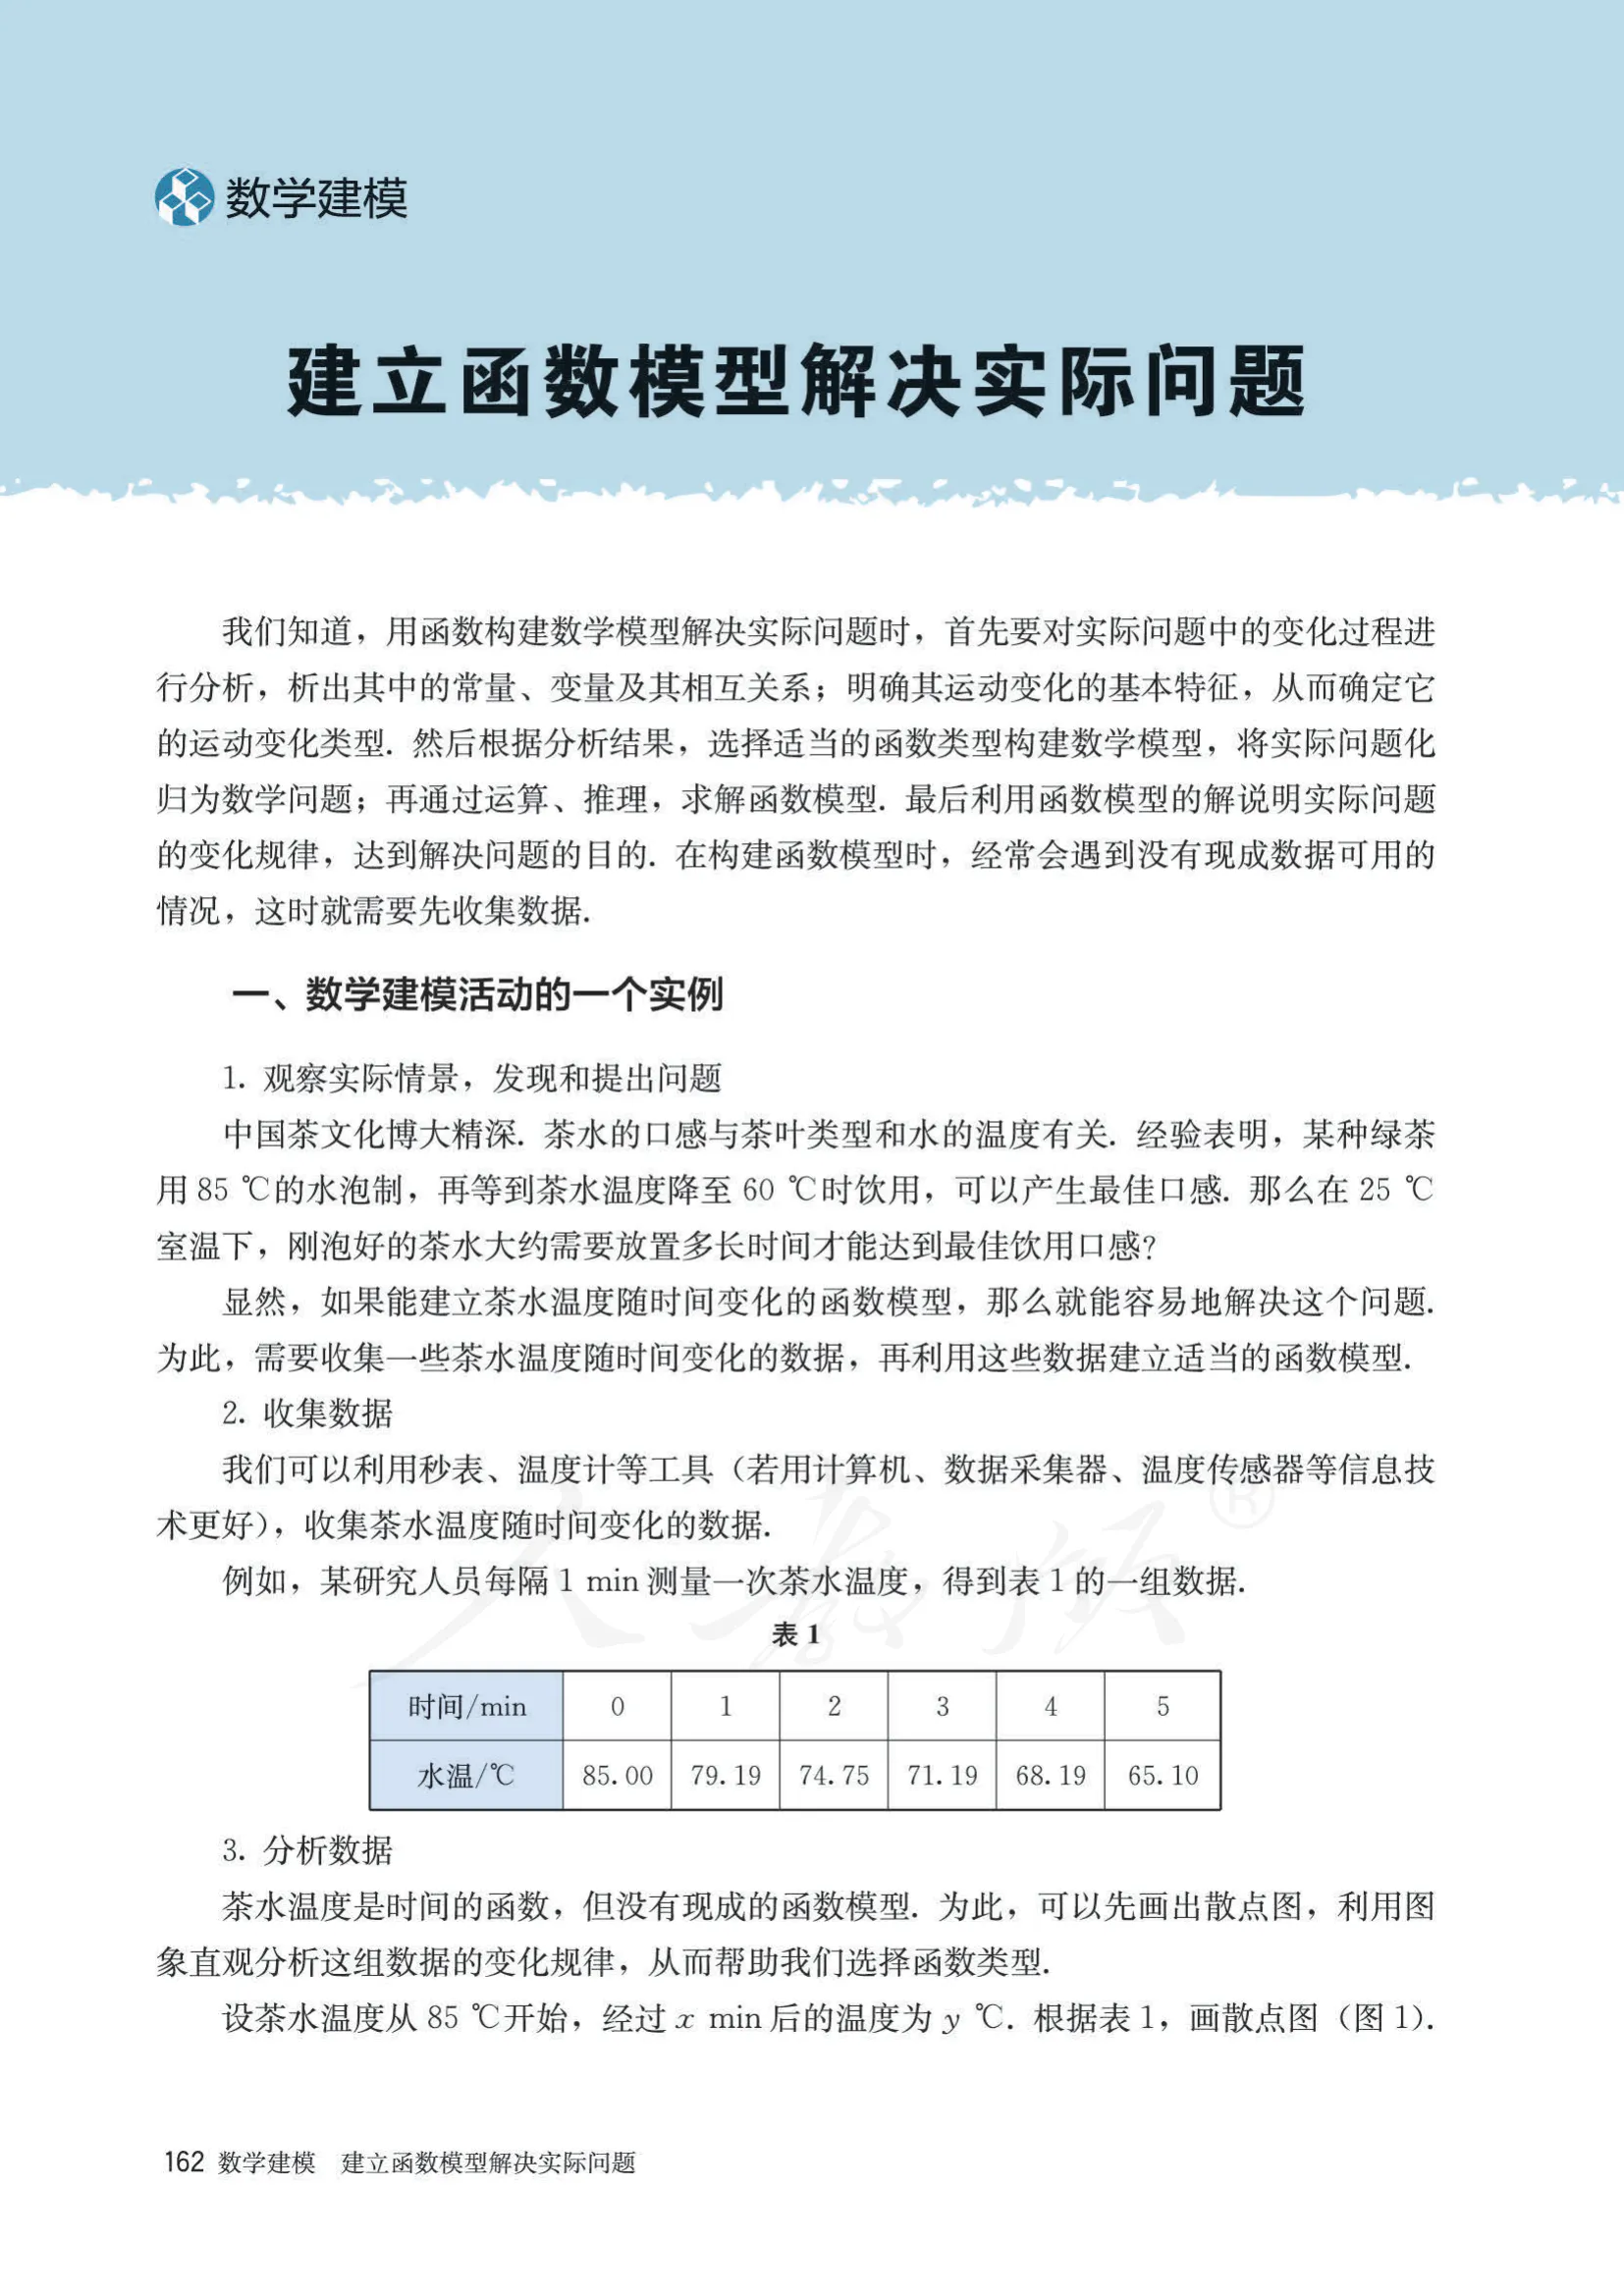
中国茶文化博大精深. 茶水的口感与茶叶类型和水的温度有关. 经验表明, 某种绿茶用 85∘C85^{\circ} \mathrm{C} 的水泡制, 再等到茶水温度降至 60∘C60^{\circ} \mathrm{C} 时饮用, 可以产生最佳口感. 那么在 25∘C25^{\circ} \mathrm{C} 室温下, 刚泡好的茶水大约需要放置多长时间才能达到最佳饮用口感?

显然,如果能建立茶水温度随时间变化的函数模型,那么就能容易地解决这个问题。为此,需要收集一些茶水温度随时间变化的数据,再利用这些数据建立适当的函数模型。

2. 收集数据

我们可以利用秒表、温度计等工具(若用计算机、数据采集器、温度传感器等信息技术更好),收集茶水温度随时间变化的数据。

例如,某研究人员每隔 1 min1 \, min 测量一次茶水温度,得到表 1 的一组数据.

3. 分析数据

茶水温度是时间的函数,但没有现成的函数模型。为此,可以先画出散点图,利用图象直观分析这组数据的变化规律,从而帮助我们选择函数类型。

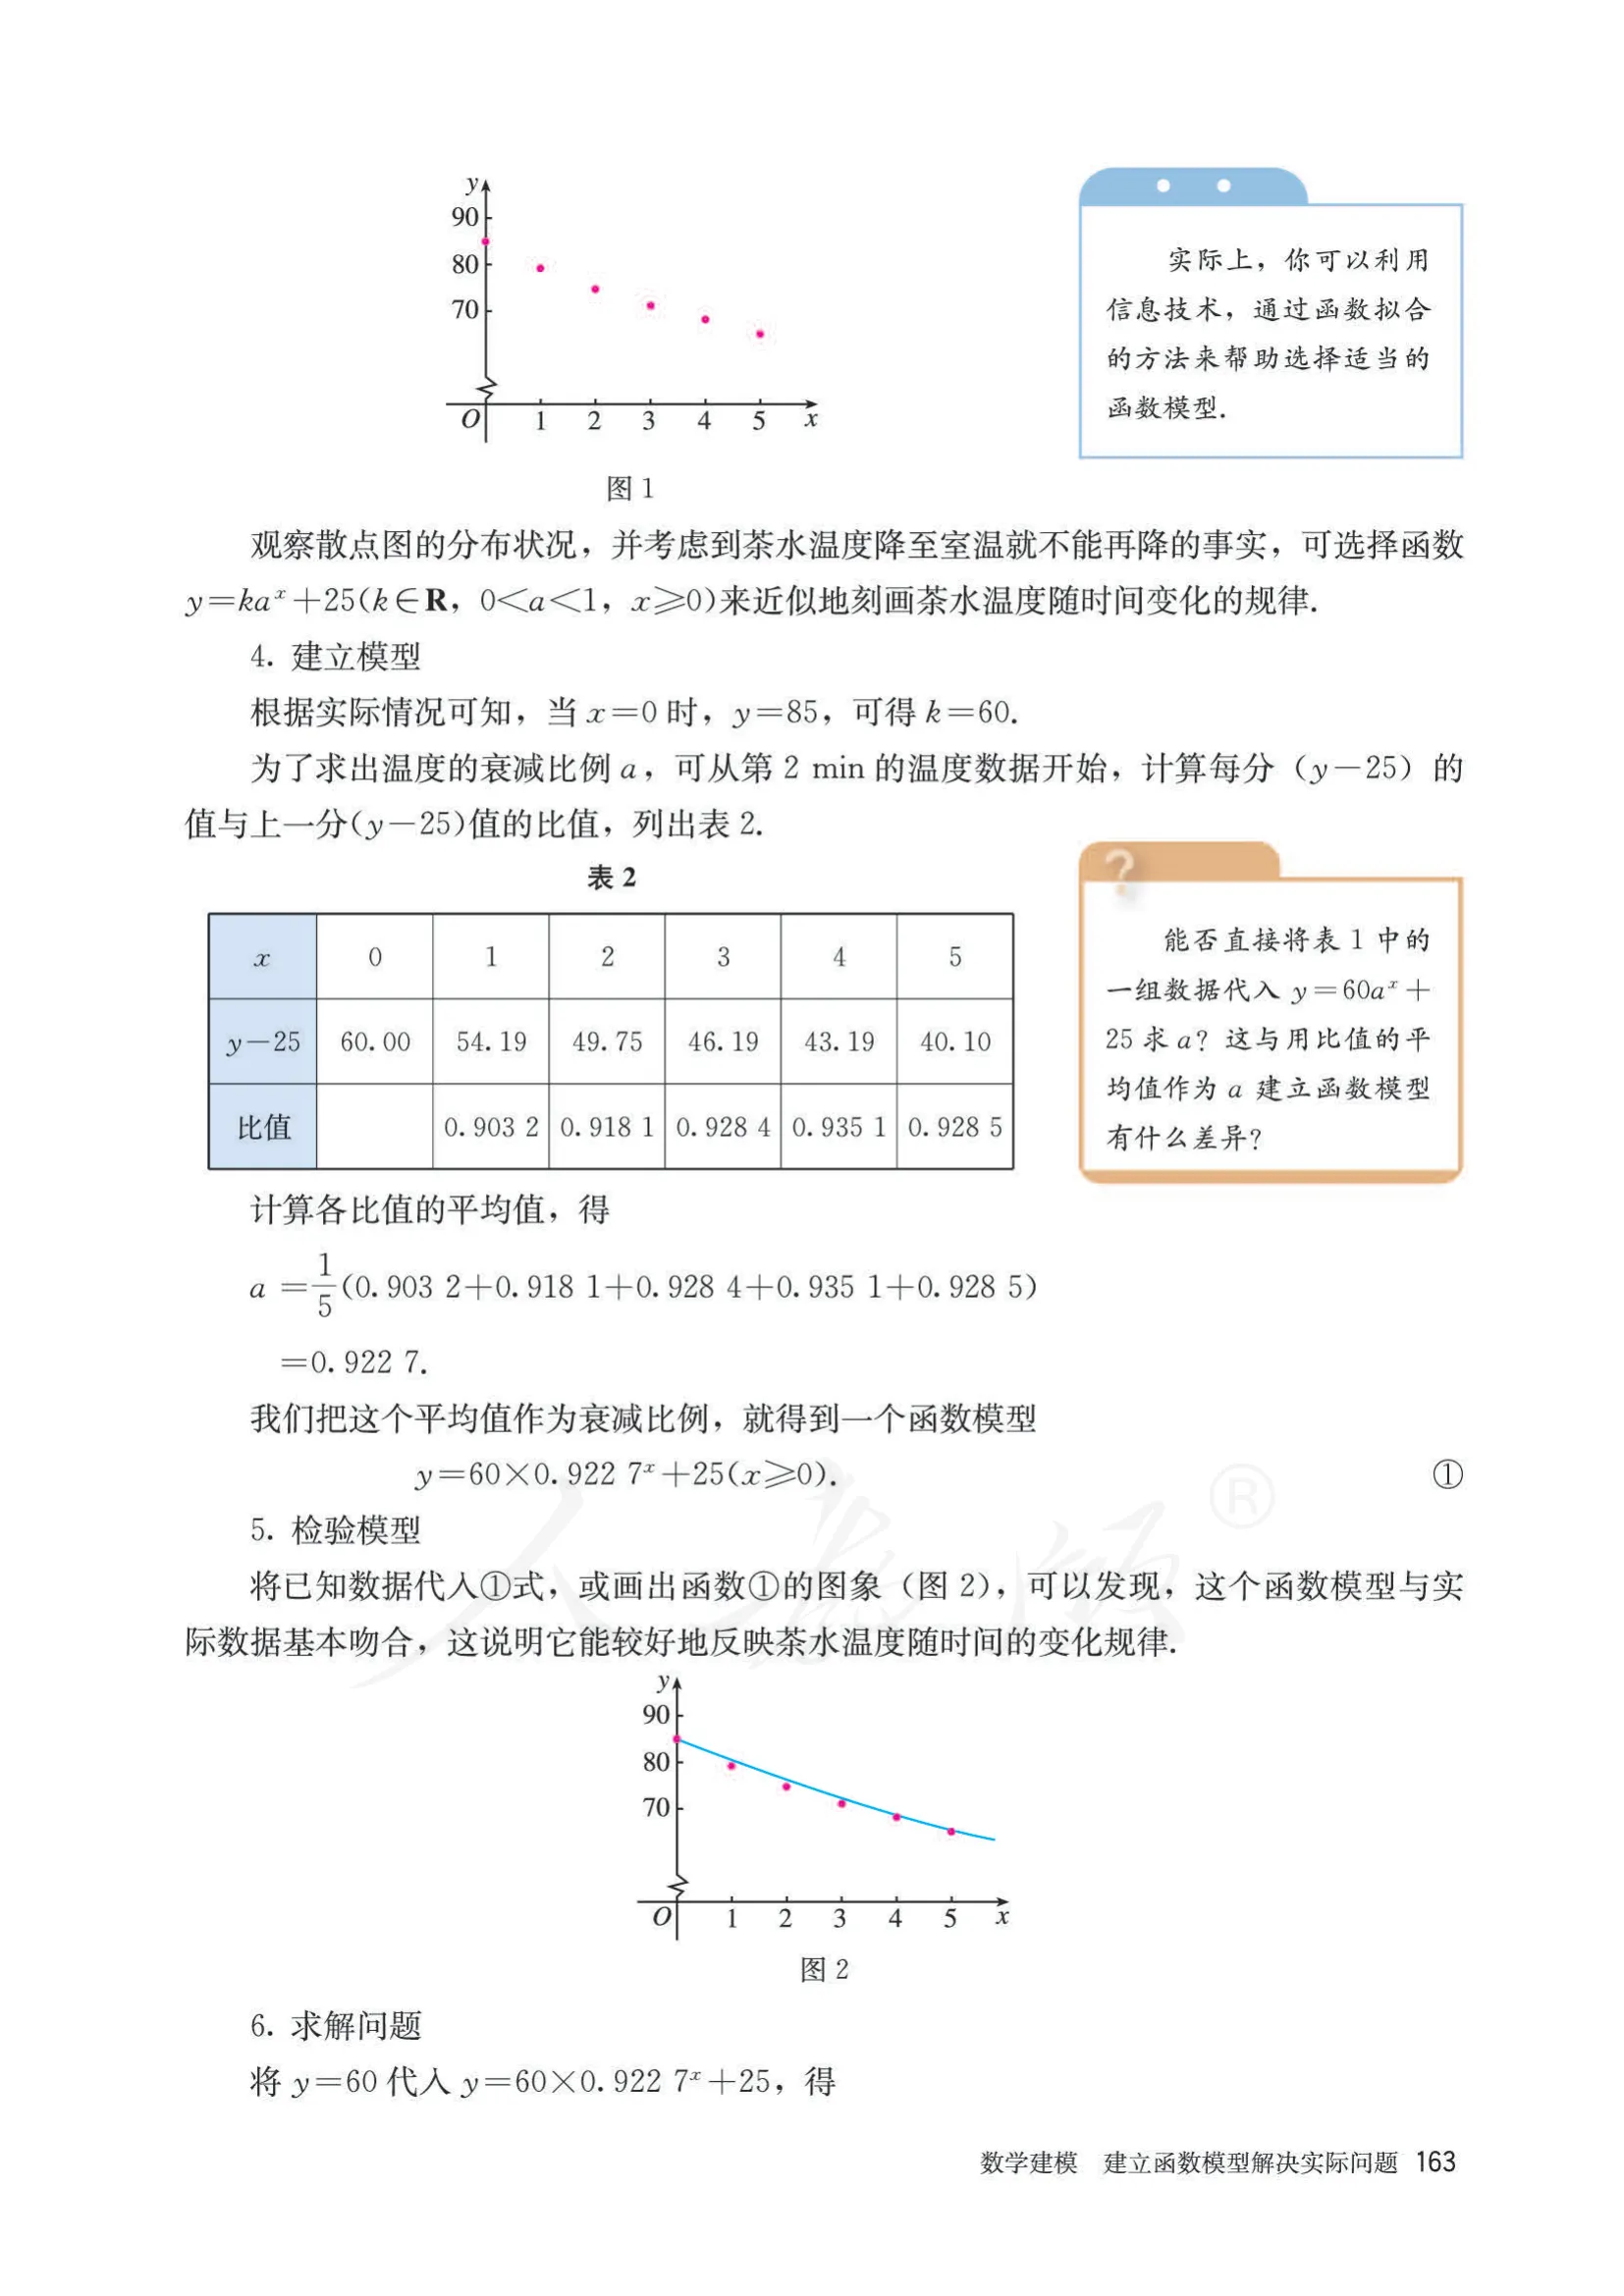
设茶水温度从 85∘85^{\circ} C 开始,经过 x min⁡x \, \min 后的温度为 y∘y^{\circ} C。根据表 1,画散点图(图 1)。

● ●

实际上,你可以利用信息技术,通过函数拟合的方法来帮助选择适当的函数模型.

观察散点图的分布状况,并考虑到茶水温度降至室温就不能再降的事实,可选择函数 y=kax+25(k∈R,0<a<1,x⩾0)y = ka^{x} + 25 (k \in \mathbb{R}, 0 < a < 1, x \geqslant 0) 来近似地刻画茶水温度随时间变化的规律.

4. 建立模型

根据实际情况可知,当 x=0 时,y=85,可得 k=60。

为了求出温度的衰减比例 aa ,可从第 2min2\mathrm{min} 的温度数据开始,计算每分(y−25y - 25)的值与上一分 (y−25)(y - 25) 值的比值,列出表2.

能否直接将表1中的一组数据代入 y=60ax+25y=60a^{x}+25 求 a?这与用比值的平均值作为 a 建立函数模型有什么差异?

计算各比值的平均值,得

a=15(0.9032+0.9181+0.9284+0.9351+0.9285)=0.9227.\begin{array}{r l} a & = \frac {1}{5} (0. 9 0 3 2 + 0. 9 1 8 1 + 0. 9 2 8 4 + 0. 9 3 5 1 + 0. 9 2 8 5) \\ & = 0. 9 2 2 7. \end{array}

我们把这个平均值作为衰减比例,就得到一个函数模型

y=60×0.9227x+25(x⩾0).(1◯)y = 6 0 \times 0. 9 2 2 7 ^ {x} + 2 5 (x \geqslant 0).\tag{\text{\textcircled{1}}}

5. 检验模型

将已知数据代入①式,或画出函数①的图象(图2),可以发现,这个函数模型与实际数据基本吻合,这说明它能较好地反映茶水温度随时间的变化规律.

6. 求解问题

将 y=60y = 60 代入 y=60×0.9227x+25y = 60 \times 0.9227^{x} + 25,得

60×0.9227x+25=60.6 0 \times 0. 9 2 2 7 ^ {x} + 2 5 = 6 0.

解得

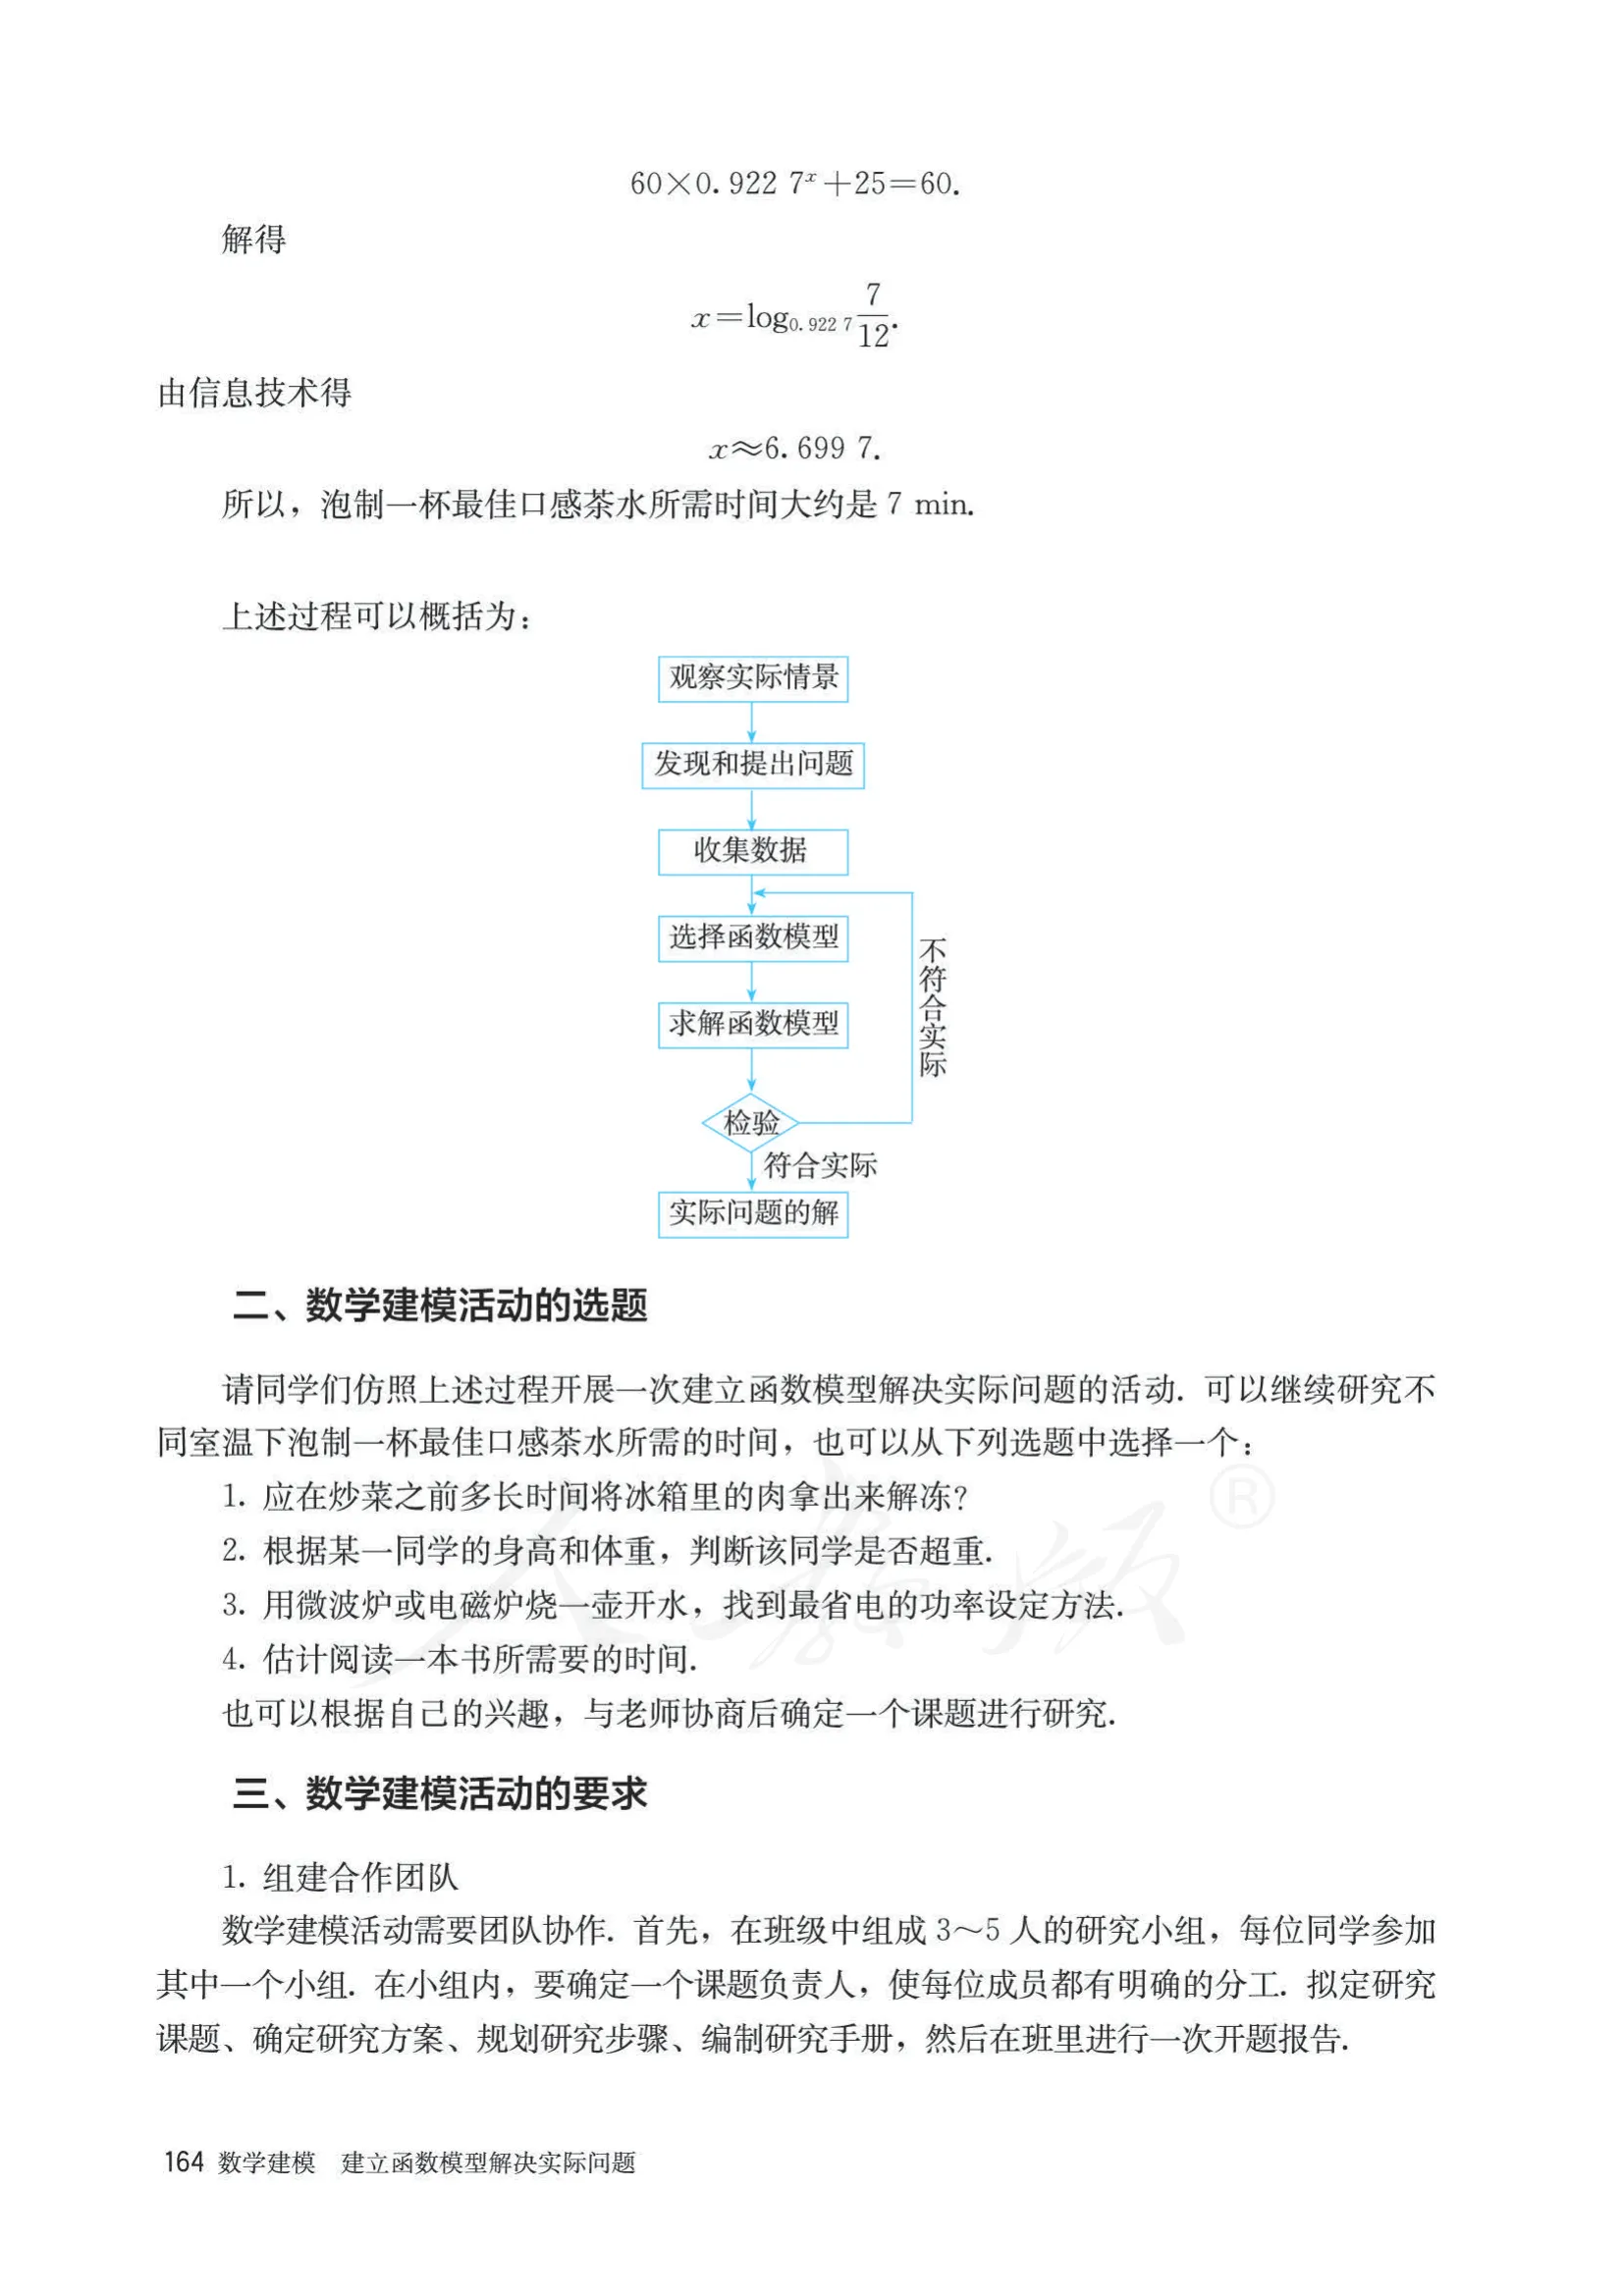
x=log⁡0.9227712.x = \log_ {0. 9 2 2 7} \frac {7}{1 2}.

由信息技术得

x≈6.6997.x \approx 6. 6 9 9 7.

所以,泡制一杯最佳口感茶水所需时间大约是 7 min.

上述过程可以概括为:
二、数学建模活动的选题

请同学们仿照上述过程开展一次建立函数模型解决实际问题的活动。可以继续研究不同室温下泡制一杯最佳口感茶水所需的时间,也可以从下列选题中选择一个:

  1. 应在炒菜之前多长时间将冰箱里的肉拿出来解冻?

  2. 根据某一同学的身高和体重,判断该同学是否超重.

  3. 用微波炉或电磁炉烧一壶开水,找到最省电的功率设定方法.

  4. 估计阅读一本书所需要的时间.

也可以根据自己的兴趣,与老师协商后确定一个课题进行研究.

三、数学建模活动的要求

1. 组建合作团队

数学建模活动需要团队协作。首先,在班级中组成3~5人的研究小组,每位同学参加其中一个小组。在小组内,要确定一个课题负责人,使每位成员都有明确的分工。拟定研究课题、确定研究方案、规划研究步骤、编制研究手册,然后在班里进行一次开题报告。

2. 开展研究活动

根据开题报告所规划的研究步骤,通过背景分析、数据收集、数据分析、数学建模、获得结论等过程,完成课题研究。在研究过程中,可以借助信息技术解决问题。

3. 撰写研究报告

以小组为单位,撰写一份研究报告.

4. 交流展示

(1)对同一个课题,先由3~4个小组进行小组交流,每个小组都展示自己的研究成果,相互借鉴、取长补短。在小组研究报告的基础上形成大组的研究报告。选定代表,制作向全班汇报的演示文稿。

(2) 与老师一起进行全班研究成果展示与交流, 在各组代表作研究报告的基础上, 通过质疑、辩论、评价, 总结成果, 分享体会, 分析不足. 开展自我评价、同学评价和老师评价, 完成本次数学建模活动.

四、数学建模活动研究报告的参考形式

建立函数模型解决实际问题

____年____班

完成时间:

  1. 研究结果

  2. 收获与体会

  3. 对此研究的评价(由评价小组或老师填写)

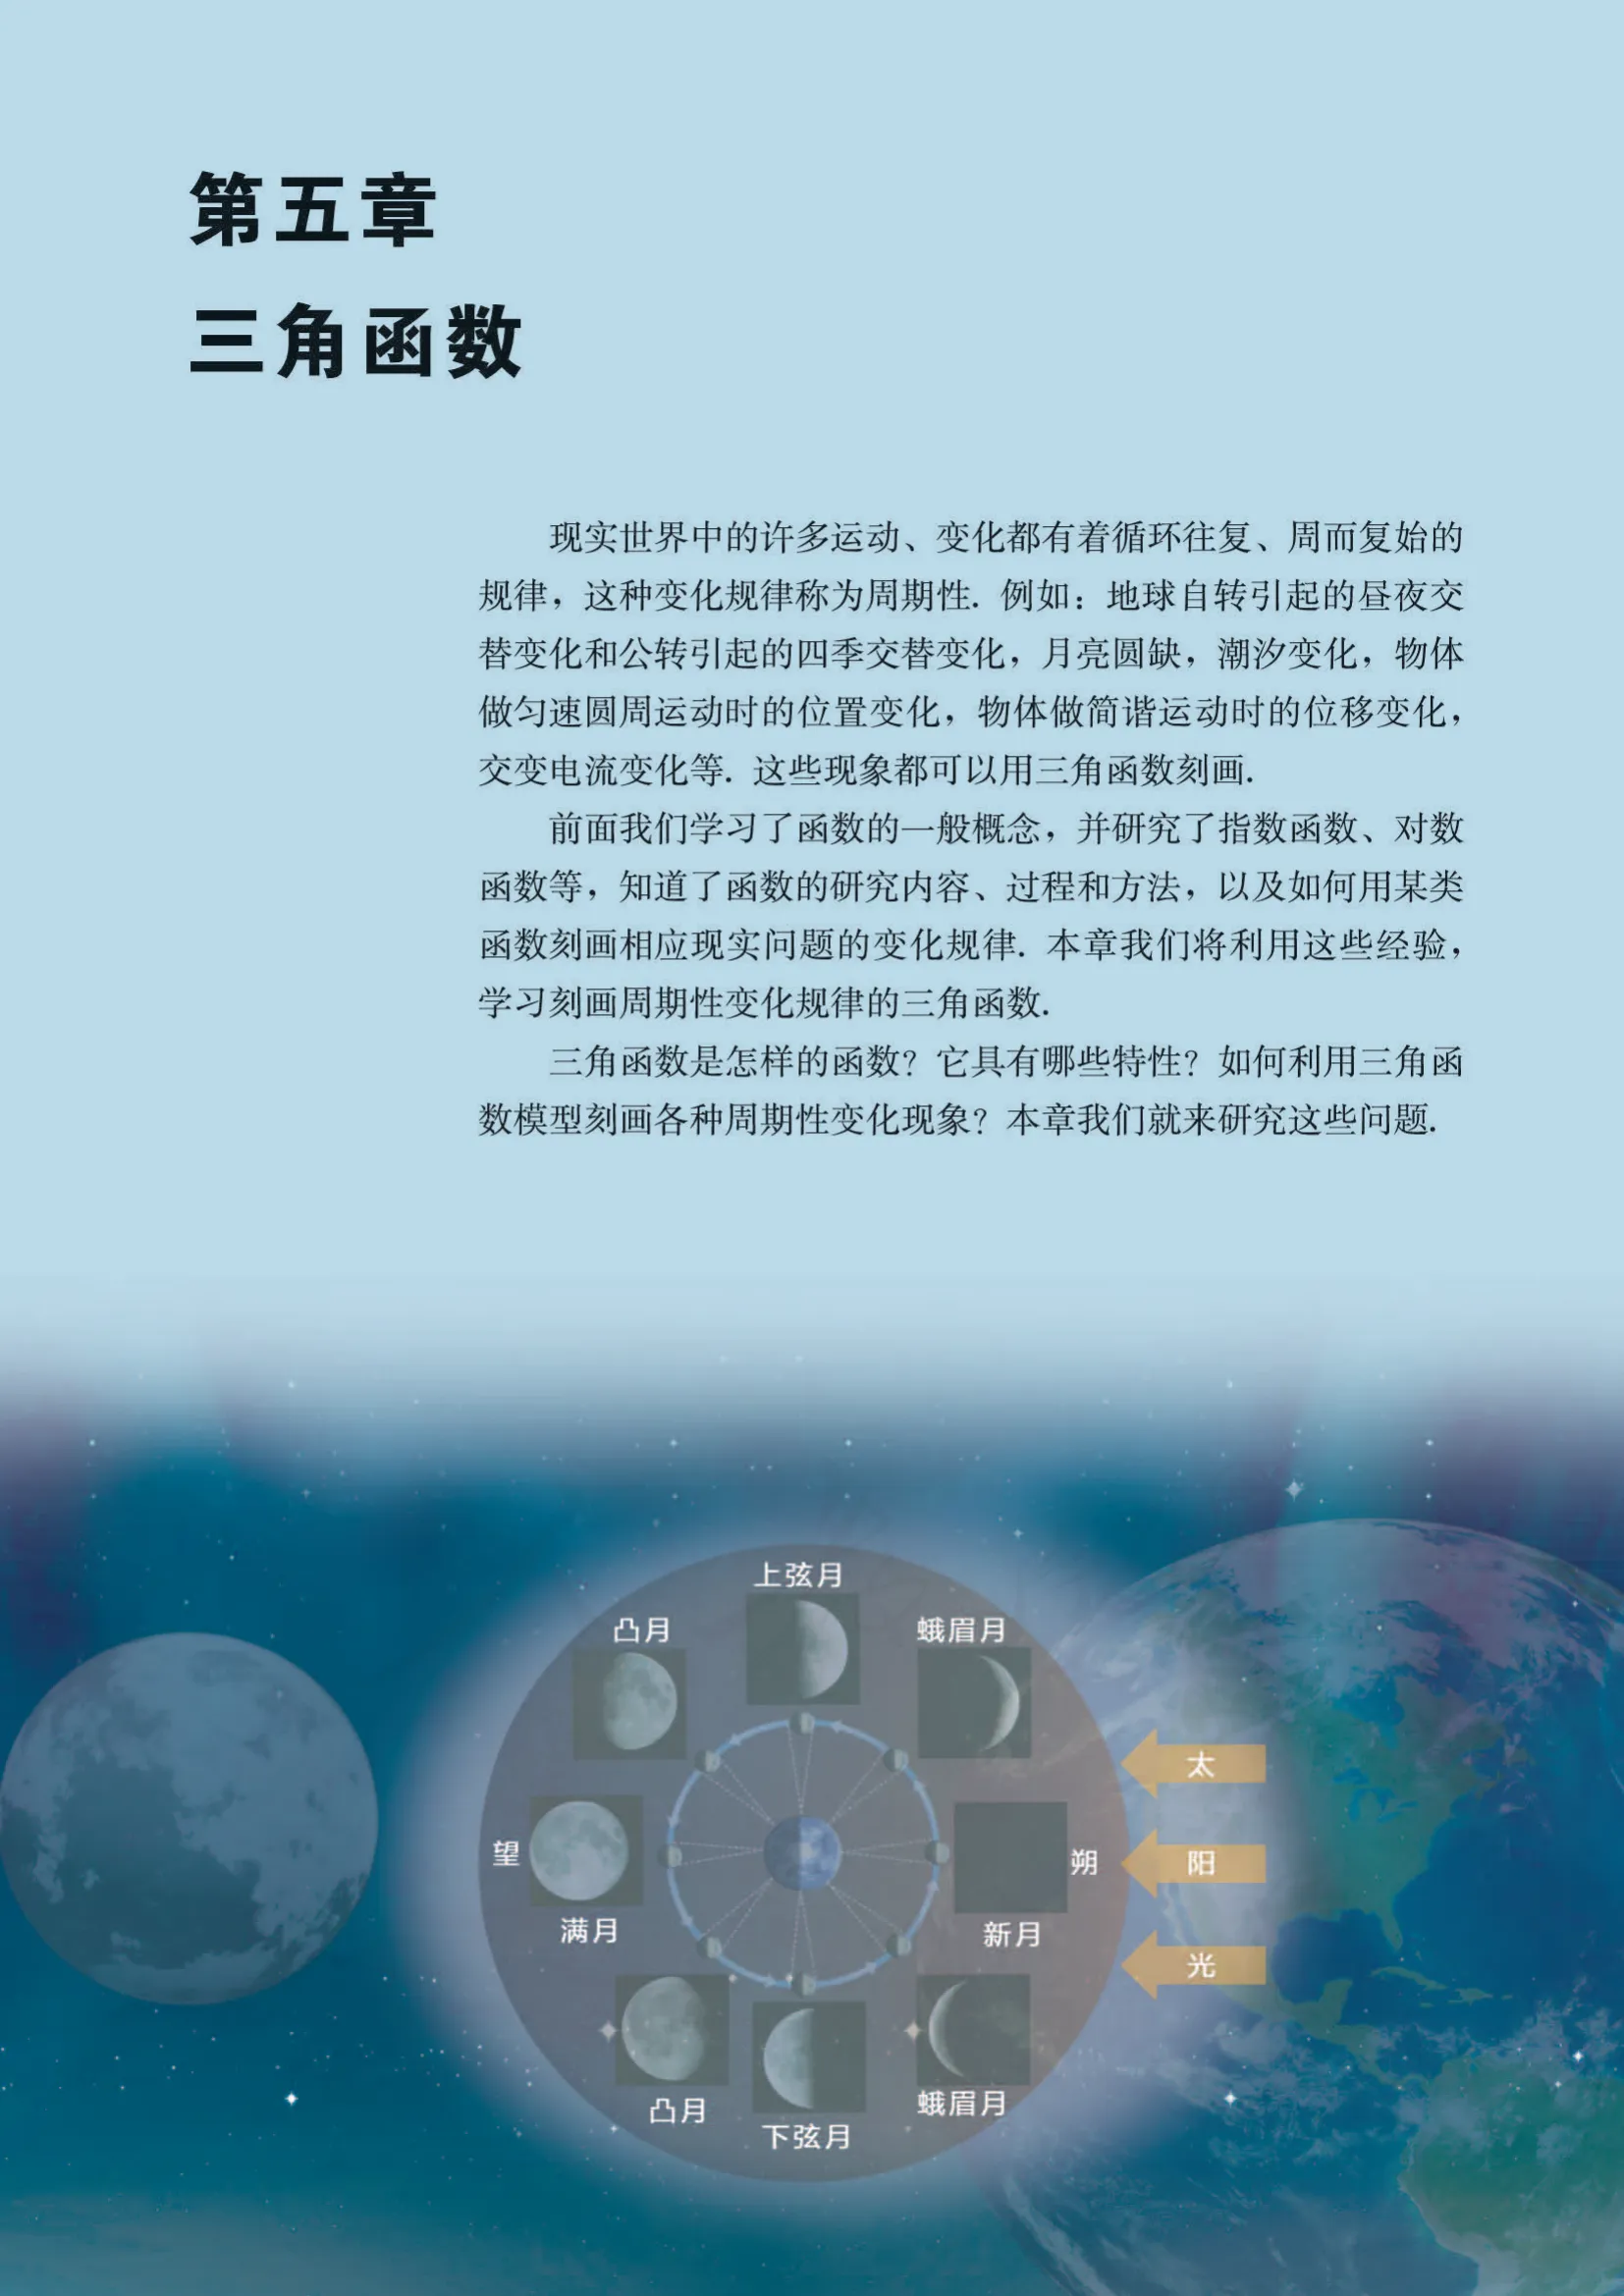
第五章

三角函数

现实世界中的许多运动、变化都有着循环往复、周而复始的规律,这种变化规律称为周期性。例如:地球自转引起的昼夜交替变化和公转引起的四季交替变化,月亮圆缺,潮汐变化,物体做匀速圆周运动时的位置变化,物体做简谐运动时的位移变化,交变电流变化等。这些现象都可以用三角函数刻画。

前面我们学习了函数的一般概念,并研究了指数函数、对数函数等,知道了函数的研究内容、过程和方法,以及如何用某类函数刻画相应现实问题的变化规律。本章我们将利用这些经验,学习刻画周期性变化规律的三角函数。

三角函数是怎样的函数?它具有哪些特性?如何利用三角函数模型刻画各种周期性变化现象?本章我们就来研究这些问题.