8.3 列联表与独立性检验
人教 A 版 · 本节 4 页原书扫描(原文)+ 本站重写的讲解与习题详解没有考过 ↓
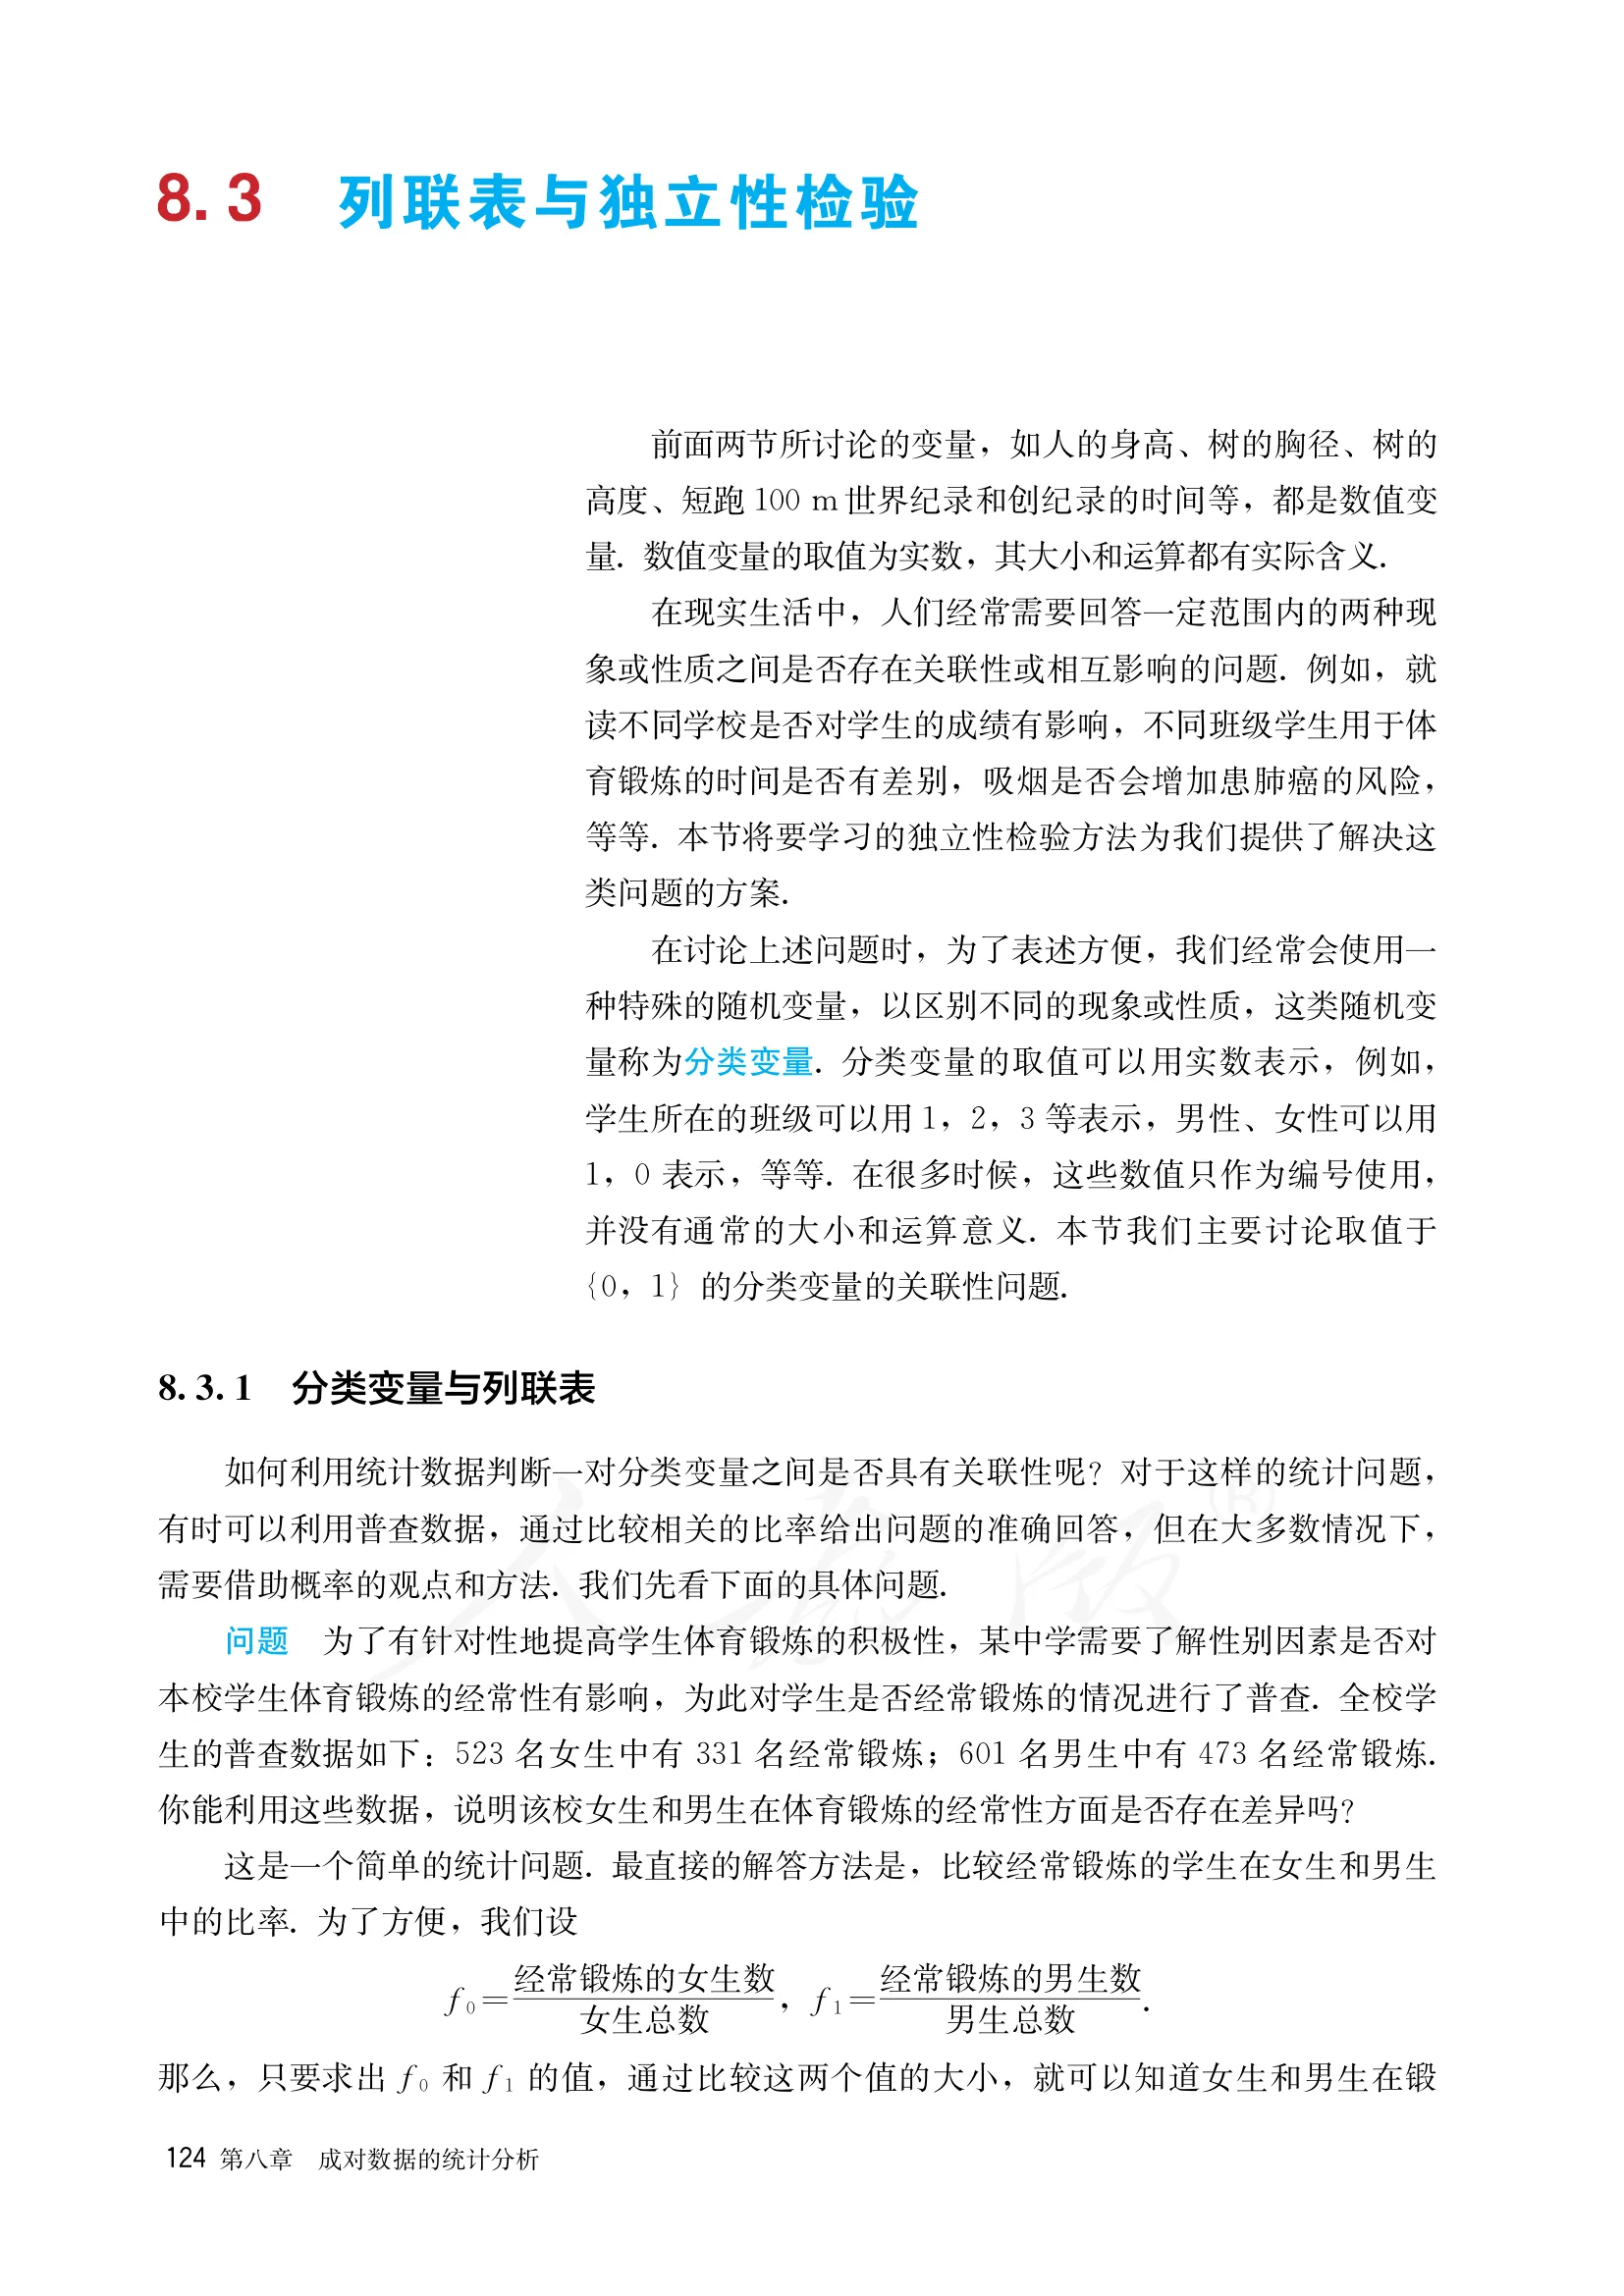
原书扫描页(人教 A 版原文)
考过本节的真题
没有考过本站语料里还没有一道真题考到这一节:现有攻略中没有任何一篇,经由引本节作教材出处的实体连到本节。这一段是两跳派生的(节 ← 实体 ← 攻略),源里没有「节 → 题」的手写声明——新的攻略一上站,清单会自己长出来。它说的是本站已上站的那些卷子里没有考到,不是「高考不考这一节」。
讲解
本站对这一节的重写(不是原书转写):顺序可重组、推导可补全,目标是易读易学 + 与真题关联。原文以上方扫描图为准。
本节目录里有四页(page-0129–page-0132,印刷页码第 124–127 页),
是 §8.3 的开篇加上 §8.3.1「分类变量与列联表」的全部内容,节末只有一道练习。
真正的检验方法( 独立性检验)在下一小节 §8.3.2。
一、换了一类变量
前两节讨论的变量——人的身高、树的胸径、树的高度、百米世界纪录和创纪录的时间—— 都是数值变量:取值为实数,大小和运算都有实际含义。 说”父亲身高每增加 1 cm”、“胸径 乘以 “,这些话都成立。
可现实里经常要回答的是另一类问题:
- 就读不同学校是否对学生的成绩有影响?
- 不同班级学生用于体育锻炼的时间是否有差别?
- 吸烟是否会增加患肺癌的风险?
这些问题里的”学校""班级""是否吸烟”都不是数量。刻画它们要用分类变量。
分类变量:用来区别不同的现象或性质的随机变量。它的取值可以用实数表示—— 班级用 ,男性女性用 —— 但这些数值在很多时候只作为编号使用,并没有通常的大小和运算意义。
这一点必须咬死。 “男 、女 “里的 和 , 不能拿去比大小(男不比女”大”),不能求平均(“平均性别 “毫无意义), 更不能作差( 不代表任何量)。它们只是标签。 正因为不能做算术,前两节的散点图、相关系数、回归直线在这里全都用不上,必须另起炉灶。
本节只讨论取值于 的分类变量的关联性问题——也就是每个变量只有两种取值 (是/否、男/女、优秀/不优秀)。这是最简单也最常用的情形。
二、引例:性别与体育锻炼的经常性
某中学需要了解性别因素是否对本校学生体育锻炼的经常性有影响,为此对学生是否经常锻炼的情况进行了普查。全校学生的普查数据如下:523 名女生中有 331 名经常锻炼;601 名男生中有 473 名经常锻炼。
注意”普查”两个字——数据覆盖了全校每一个学生,不是抽样。这一点后面会变得很关键。
解法一:直接比较比率
设
代入数据:
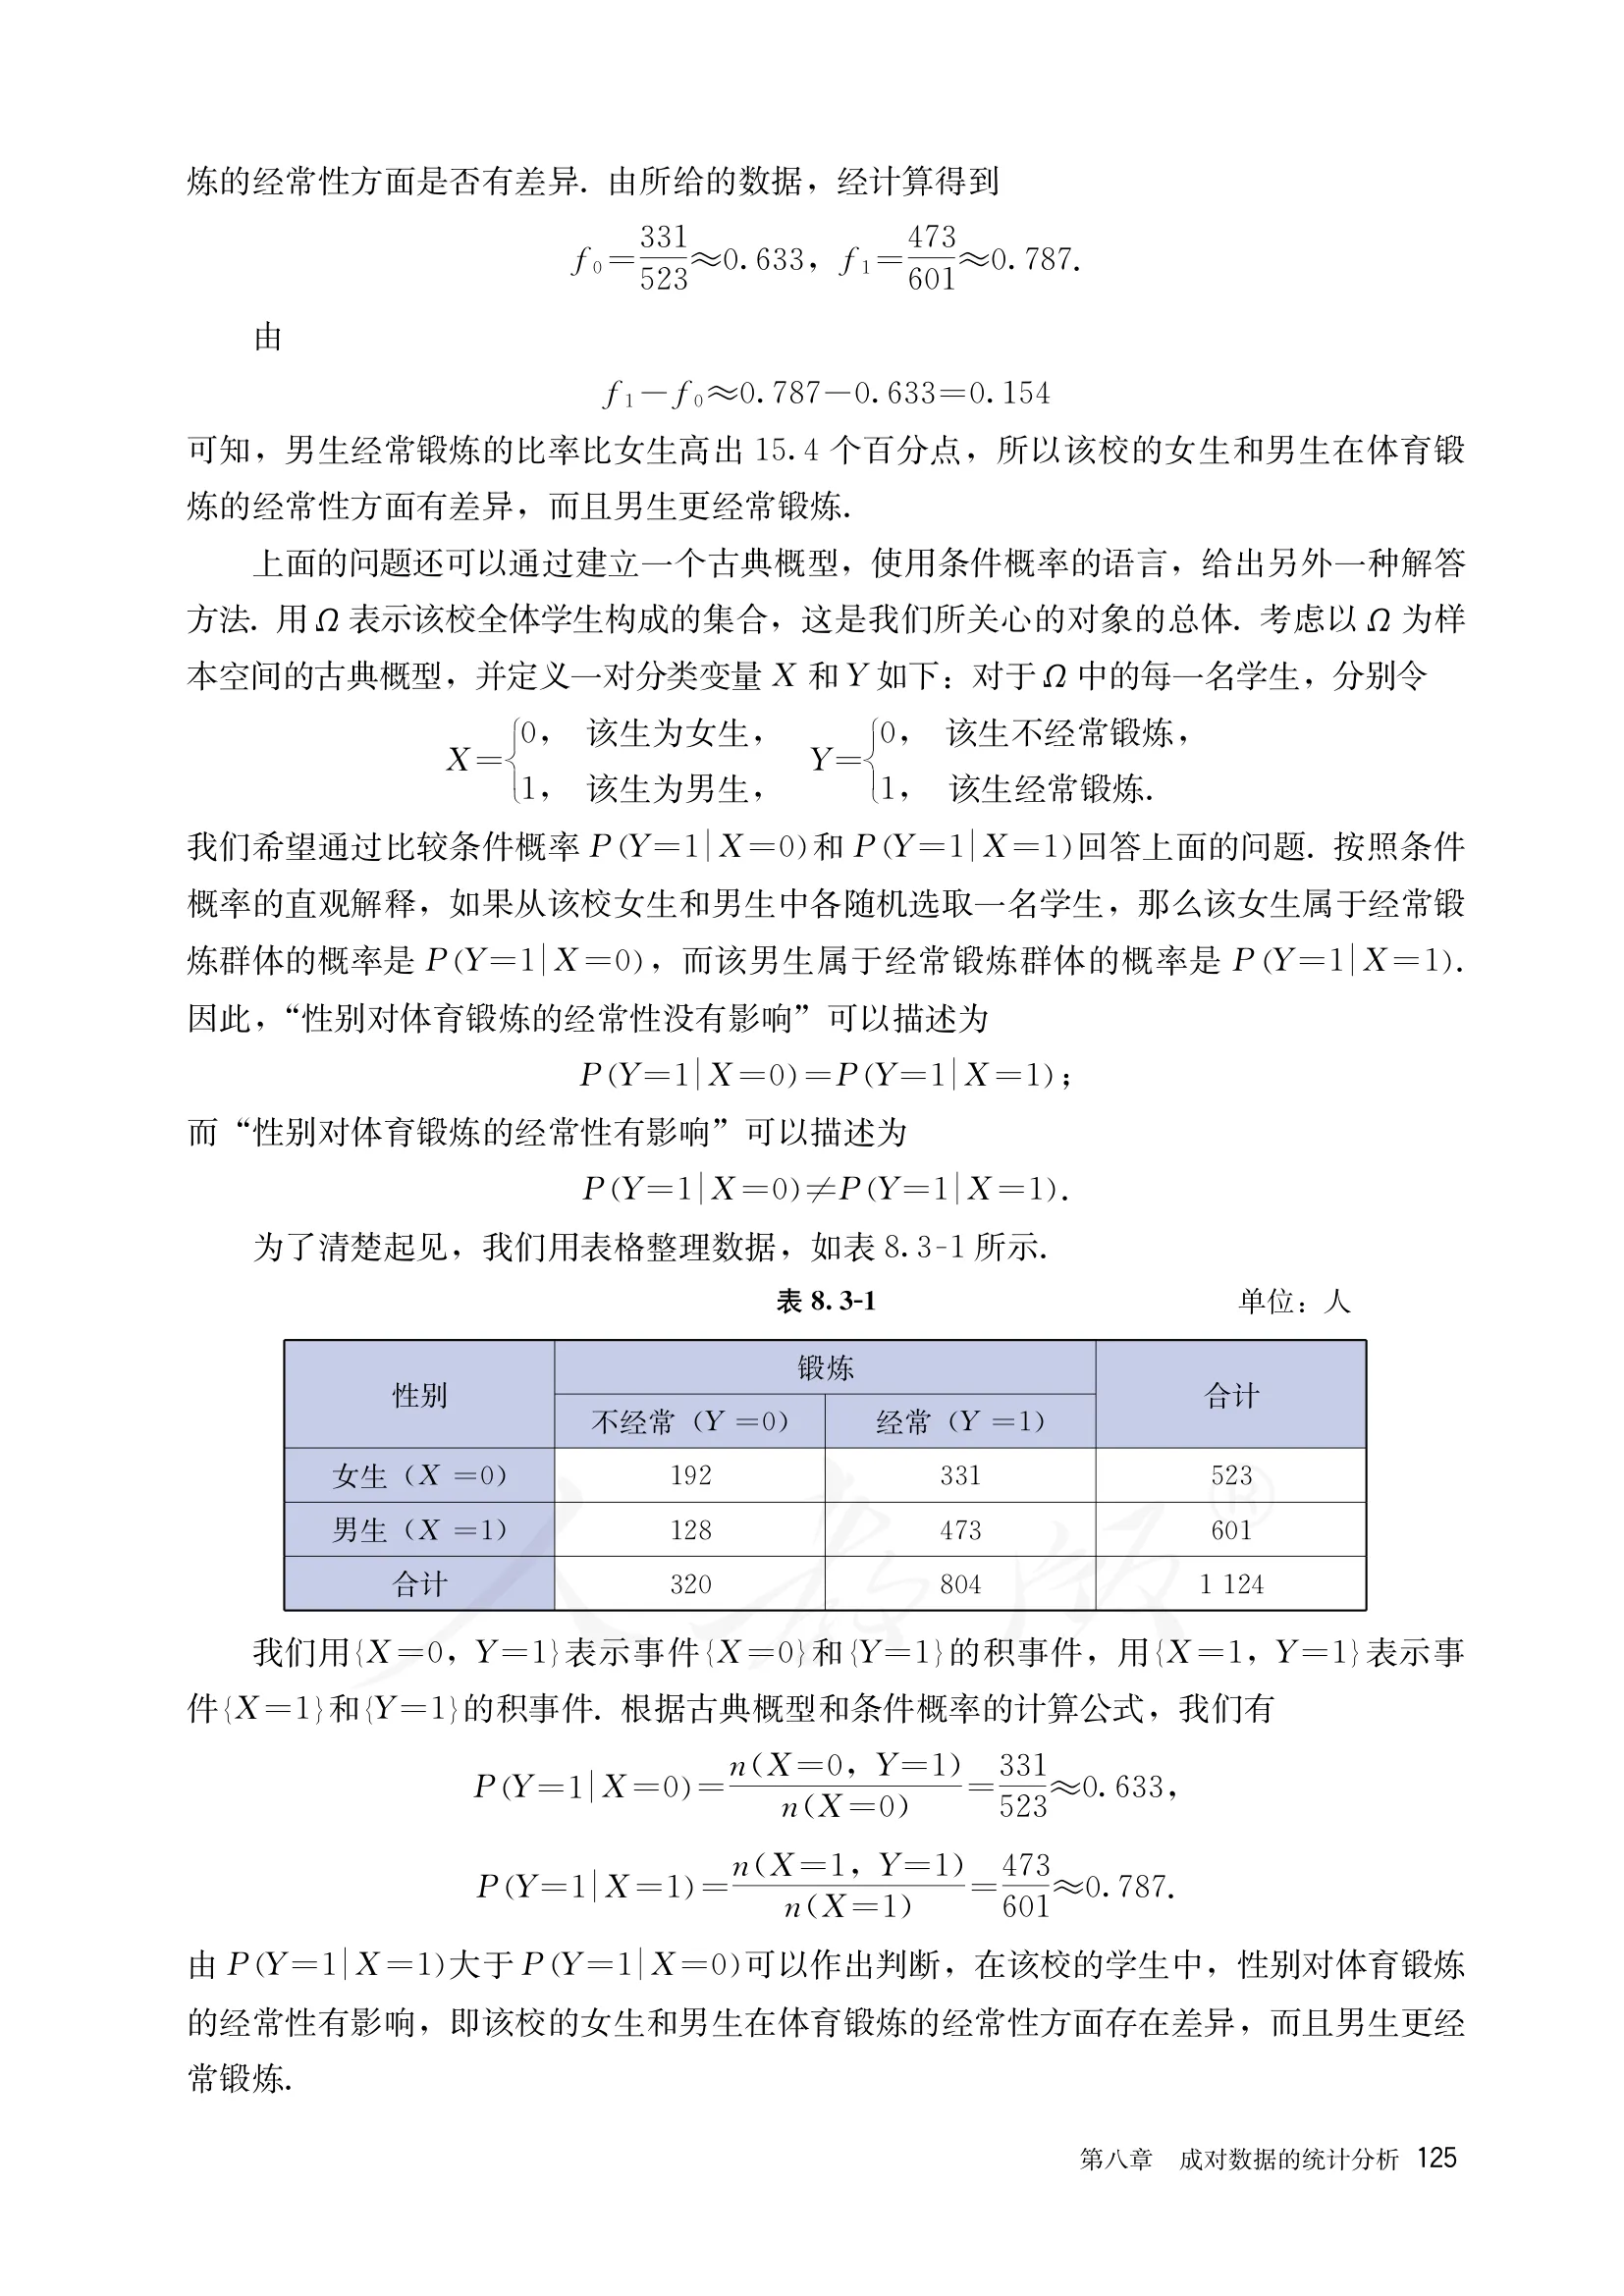
男生经常锻炼的比率比女生高出 个百分点,所以该校女生和男生在体育锻炼的 经常性方面有差异,而且男生更经常锻炼。
为什么一定要算比率,不能直接比人数? 因为女生 人、男生 人,基数不同。 经常锻炼的人数 与 之差里,有一部分只是”男生本来就多”造成的。 只有除以各自的总数,两个数字才可比。 这是本节最基础的一条,却也是最容易错的一条。
解法二:换成条件概率的语言
同一个问题还可以这样做:用 表示该校全体学生构成的集合, 以 为样本空间考虑古典概型(每个学生被抽到的机会相同),并定义两个分类变量:
于是问题变成比较两个条件概率:
直观解释:从该校女生中随机选一名,她属于经常锻炼群体的概率是 ; 从男生中随机选一名,他属于经常锻炼群体的概率是 。因此
| 白话 | 数学表述 |
|---|---|
| 性别对体育锻炼的经常性没有影响 | |
| 性别对体育锻炼的经常性有影响 |
按古典概型与条件概率公式,
后者大于前者,结论与解法一完全一样。
那何必绕这一圈? 因为解法二做的是换语言,而换语言换来了两样东西:
- 把模糊的”有没有影响”变成了精确的等式与不等式,可以判断真假;
- 打通了通向抽样的路。普查数据下两种解法结果相同,但当拿不到全部数据时, 只有概率语言还能继续用下去(见第四节)。
顺带一个观察: 恰好就是 §7.1 里” 与 相互独立”的 另一种写法。“没有关联”就是”独立”——下一小节的”独立性检验”,名字正是这么来的。
三、 列联表
保存原始数据的成本较高,所以人们常按需要把数据分类统计,做成表格保存。 表 8.3-1 这种形式的统计表称为 列联表(contingency table), 它给出的是成对分类变量数据的交叉分类频数。
把引例的数据填进去(,):
| (不经常锻炼) | (经常锻炼) | 合计 | |
|---|---|---|---|
| (女生) | 192 | 331 | 523 |
| (男生) | 128 | 473 | 601 |
| 合计 | 320 | 804 | 1124 |
这张表的每一块都要认得:
| 位置 | 含义 |
|---|---|
| 中间四格 | 核心部分,事件 ()中样本点的个数 |
| 最后一列的前两个数 | 事件 、 中样本点的个数 |
| 最后一行的前两个数 | 事件 、 中样本点的个数 |
| 右下角 | 样本空间中样本点的总数 |
边缘的合计不是可有可无的装饰:算条件概率时分母正是最后一列(或最后一行)的数。 ,分子取自中间四格,分母取自最后一列。
读表的固定动作:横着看比例。 想问”性别有没有影响”,就把每一行除以该行的合计:
| 的比率 | 的比率 | |
|---|---|---|
| 女生 | ||
| 男生 |
两行的比率差得越多,关联越明显。 如果两行的比率一模一样,那就是”没有影响”。
四、从普查到抽样:本节真正的转折
上面的两种解答都用了学校全部学生的数据,所以能完全确定所需的比率和条件概率, 答案是准确的。
可是对于大多数实际问题,我们无法获得所关心的全部对象的数据—— 要研究”吸烟是否增加患肺癌风险”,不可能去普查全国人口。这时怎么办?
古典概型和条件概率的观点提供了思路:
- 把所关心的对象的全体看成古典概型的样本空间,用概率的语言刻画问题 (即上面的 与 );
- 用随机抽样获得一定数量的样本数据;
- 利用随机事件发生的频率稳定于概率的原理,由频率去推断概率,从而推断问题的答案。
很多统计方法都是基于这种思想建立起来的,这一句值得单独记住—— 它是整个统计推断的骨架:总体用概率描述,样本给出频率,频率估计概率。
五、例 1:甲乙两校的数学优秀率
为比较甲、乙两所学校学生的数学水平,采用简单随机抽样的方法抽取 88 名学生。通过测验得到了如下数据:甲校 43 名学生中有 10 名数学成绩优秀;乙校 45 名学生中有 7 名数学成绩优秀。
先注意与引例的区别:这次是”简单随机抽样”,不是普查。 所以下面算出来的是频率, 它只是概率的估计。
第一步:定义分类变量。 用 表示两所学校的全体学生构成的集合, 考虑以 为样本空间的古典概型。对 中每一名学生,
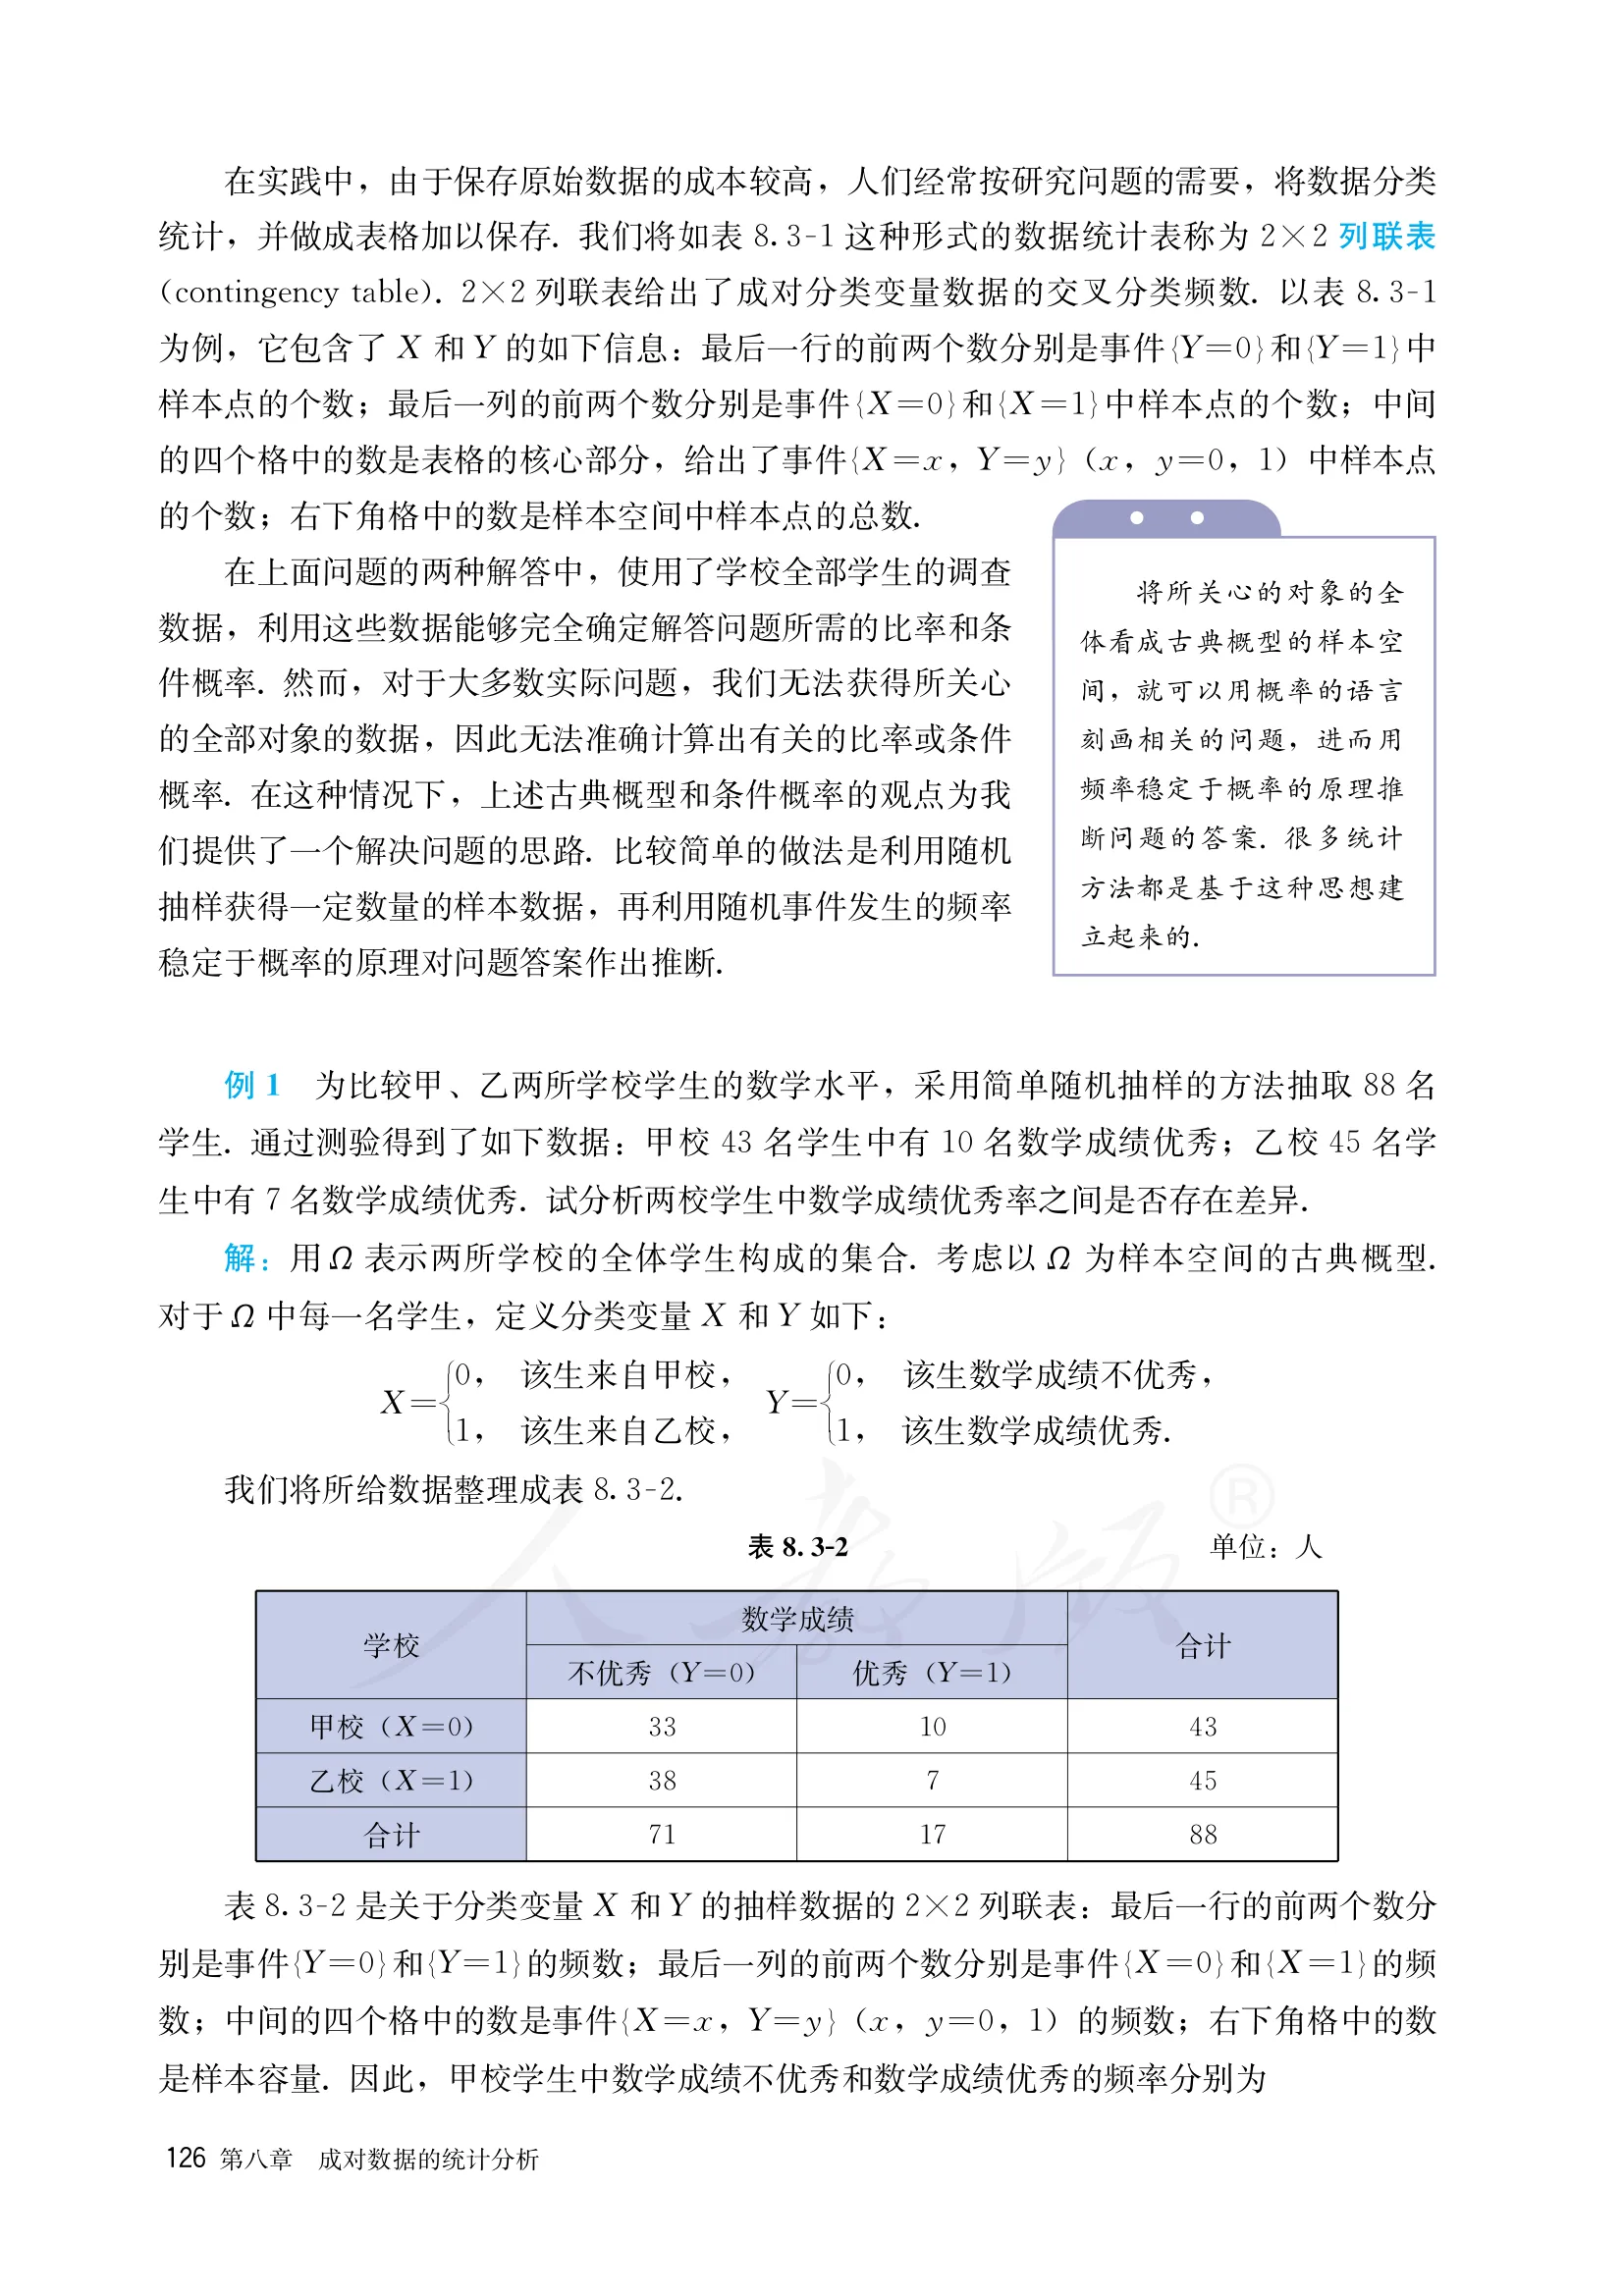
第二步:整理成 列联表(表 8.3-2,,):
| (不优秀) | (优秀) | 合计 | |
|---|---|---|---|
| (甲校) | 33 | 10 | 43 |
| (乙校) | 38 | 7 | 45 |
| 合计 | 71 | 17 | 88 |
第三步:横着算频率。 甲校学生中数学成绩不优秀和优秀的频率分别为
乙校学生中数学成绩不优秀和优秀的频率分别为
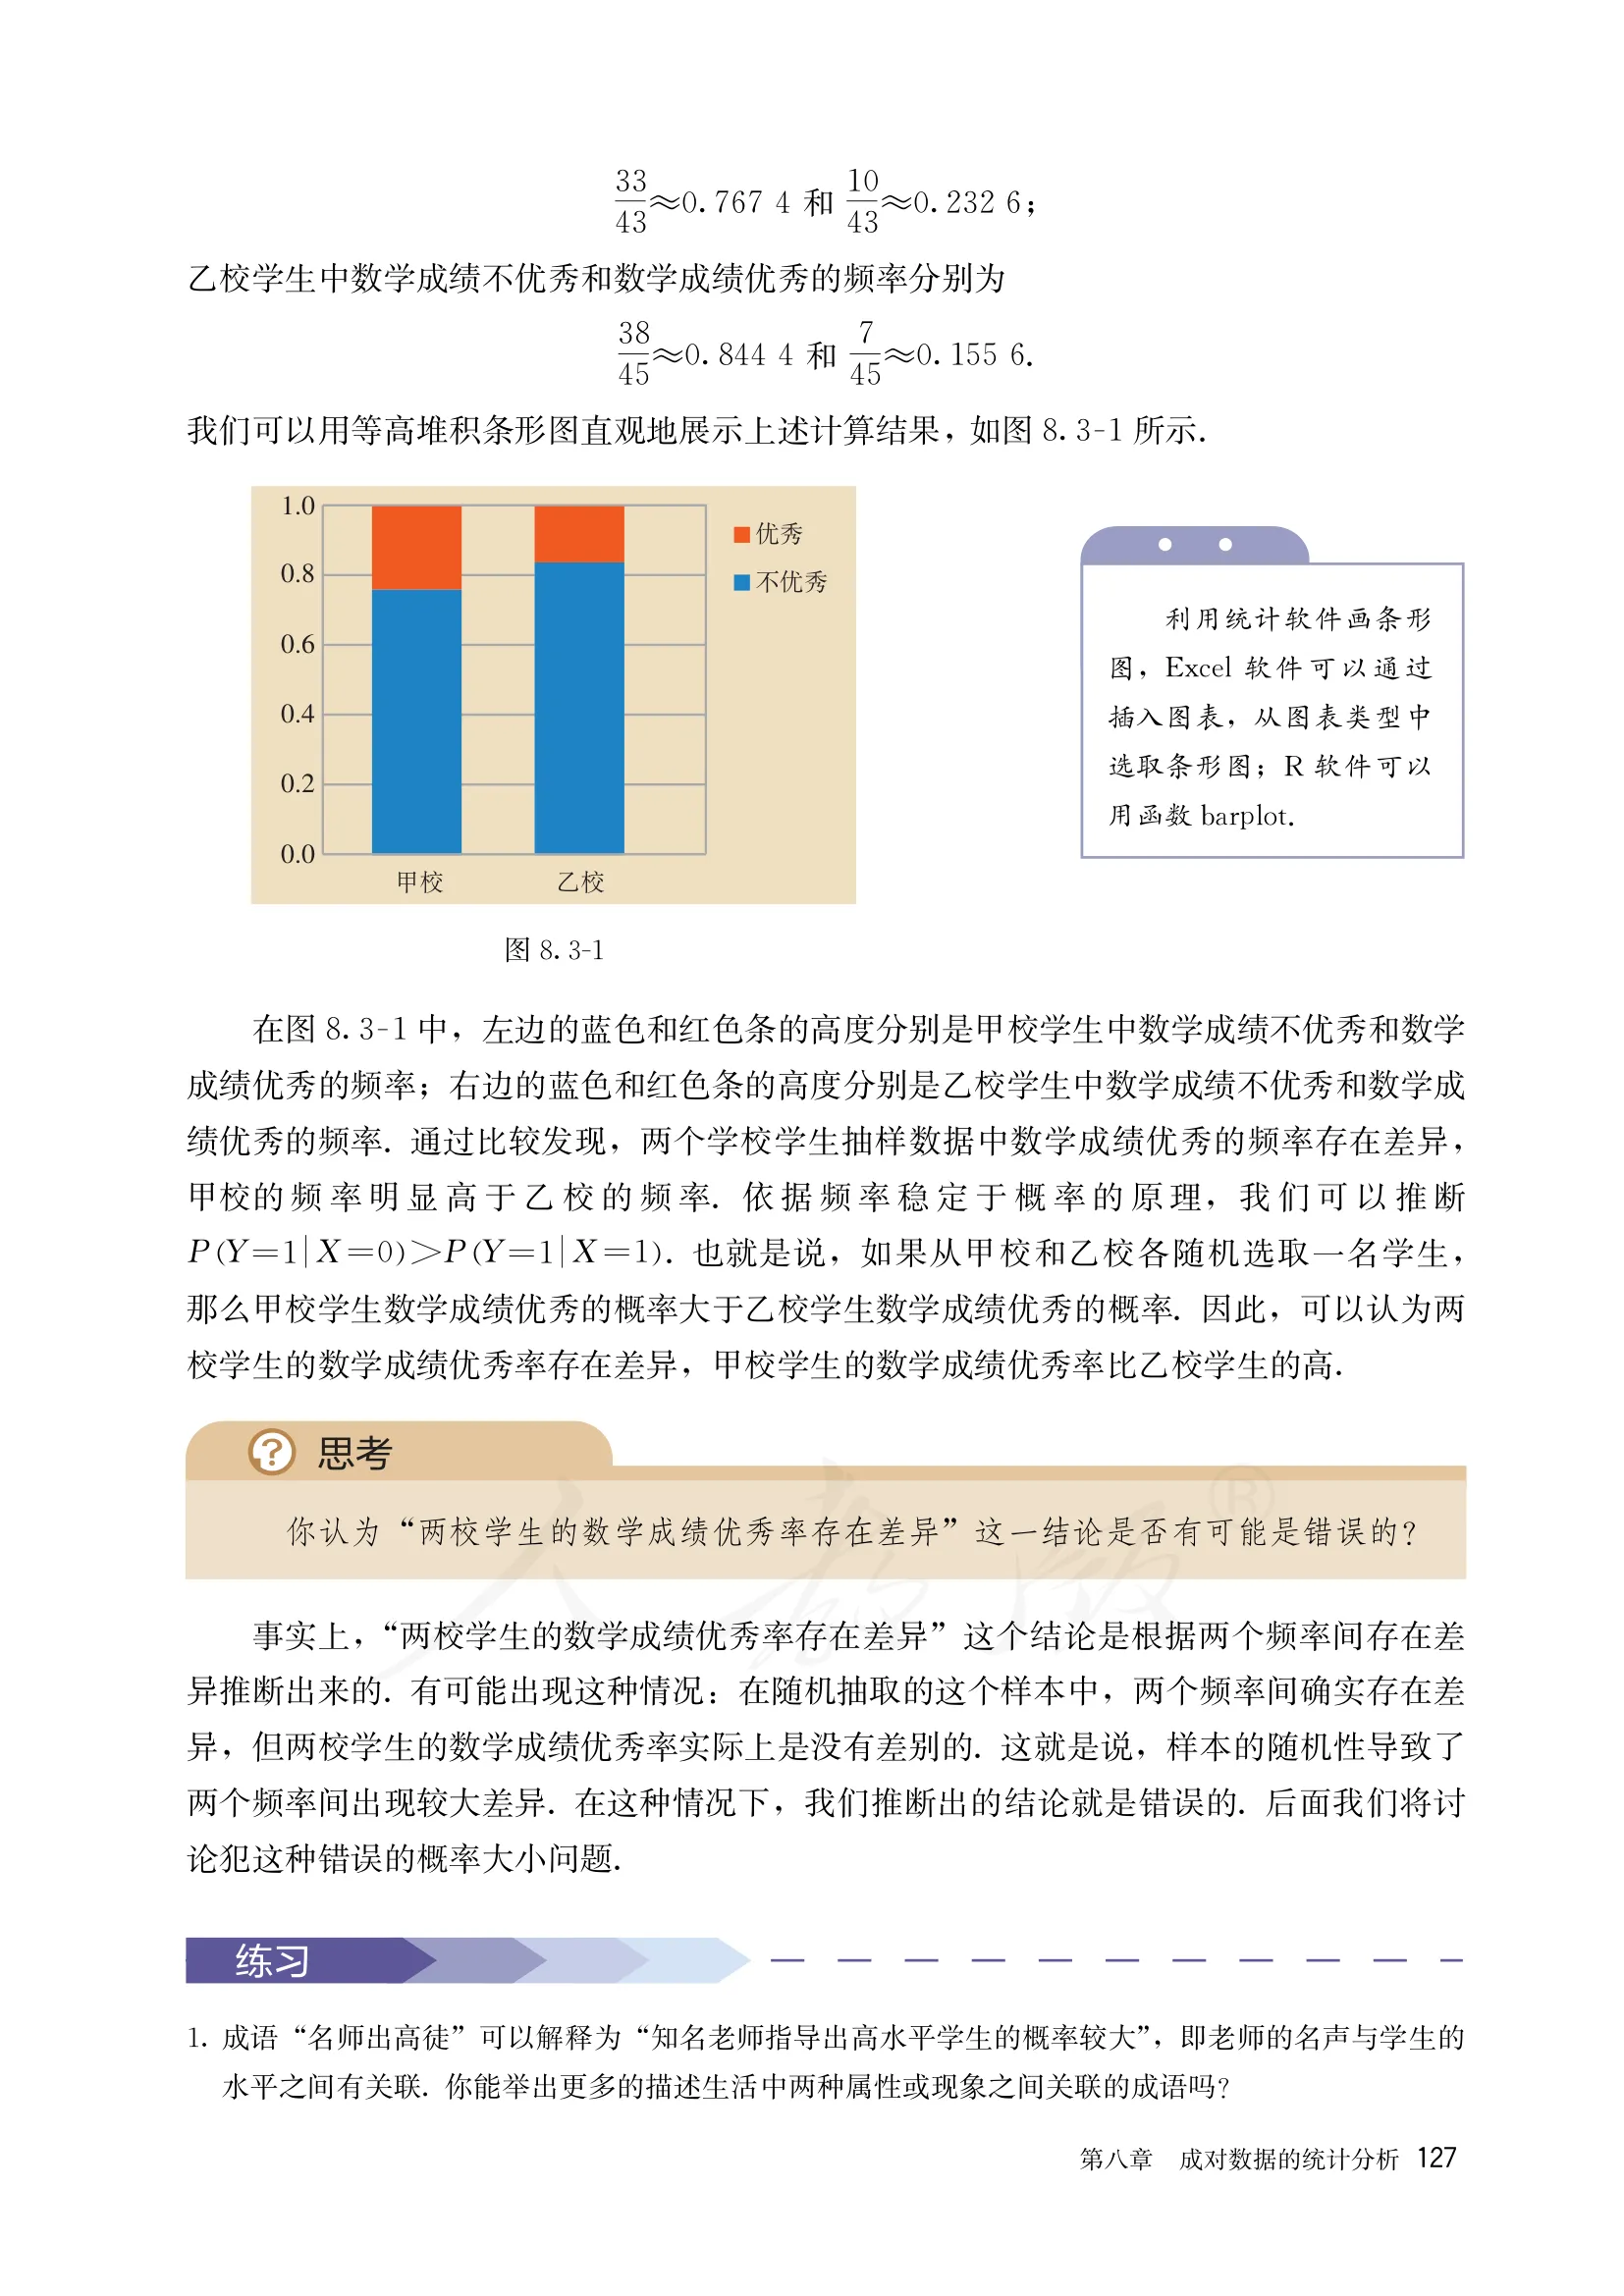
第四步:画等高堆积条形图(图 8.3-1)。 甲、乙两校各画一根等高的条(高度都代表 ,即 ), 每根条按”不优秀/优秀”的频率上下分成两段。等高是关键—— 两校抽到的人数不同( 与 ),只有把每根条都归一化成同样高, 两段的高度才直接可比。
(软件里:Excel 插入图表选条形图,R 用函数 barplot。)
第五步:下结论。 从图上看,两校数学成绩优秀的频率存在差异,甲校明显高于乙校 ( 对 )。依据频率稳定于概率的原理,可以推断
即从甲校和乙校各随机选一名学生,甲校学生数学成绩优秀的概率大于乙校。 因此可以认为两校学生的数学成绩优秀率存在差异,甲校比乙校高。
六、这个结论可能是错的吗
你认为“两校学生的数学成绩优秀率存在差异”这一结论是否有可能是错误的?
有可能。这是本节最重要的一段。
结论是由两个频率之间存在差异推断出来的。但有可能出现这种情况: 在随机抽取的这个样本中,两个频率间确实存在差异,而两校学生的数学成绩优秀率实际上并没有差别, 差异纯粹是样本的随机性造成的。这时我们推断出的结论就是错的。
为什么引例里不担心这件事,这里却要担心? 因为引例用的是普查, 算出的 和 就是总体的真实比率,没有抽样误差可言; 而例 1 是抽样,换一批 个学生,两个频率都会变。
一个直观的感受:例 1 里甲校 人中有 人优秀。 假如其中一名优秀的学生那天恰好没被抽中,换成一名不优秀的,频率立刻从 掉到 , 与乙校的 就近了一截。样本量只有四十几,一两个人的进出就能明显改变结论, 所以”有差异”这个判断到底靠不靠得住,光看两个频率不等是说不清的。
于是自然要问:如果两校优秀率其实相同,纯靠运气抽出这么大差异的概率有多大? 如果这个概率很小,我们就有底气说”差异是真的”;如果这个概率不小,就不该下结论。 这正是下一小节 独立性检验要解决的问题——课本说的”后面我们将讨论犯这种错误的 概率大小问题”,指的就是它。
七、小结与易错点
- 分类变量用来区分现象或性质,取值常常只是编号,没有大小与运算意义; 所以前两节的相关系数、回归直线在这里一概不适用;
- 比较关联要比比率(频率),不能比频数——两组的基数往往不同;
- 列联表:中间四格是交叉分类频数,最后一行、一列是边缘频数,右下角是总数; 读表的动作是”横着除以行合计”;
- 两种语言是等价的:比率的差 条件概率的差。 “没有影响”,也就是 与 独立;
- 等高堆积条形图把”等高”用来抵消基数不同,是列联表的标准配图;
- 普查与抽样要分清:普查算出的是概率,结论准确;抽样算出的是频率, 结论是推断,有可能错,错的来源是样本的随机性;
- 易错点集中在三处:拿频数直接比大小;把 、 当数值去运算; 把抽样得到的频率差当成总体一定有差异。
下一小节 §8.3.2 会给出独立性检验:先假设两个分类变量独立, 构造统计量 度量实际频数与”独立时该有的频数”之间的偏离, 再用小概率事件的原理来判断这个偏离是不是大到不能用运气解释。
习题详解(本站解答,无官方答案可核)
人教 A 版学生用书不含答案,教师用书与全解不在本站语料里——因此本节习题的解答无官方答案可核,它们是本站写的。每一道都过了独立 verifier 的 refute 优先复核(默认它有问题,找不出问题才放行),但那不等于官方标准答案:拿它对思路,别拿它对分。
本节目录里有四页(page-0129–page-0132,印刷页码第 124–127 页),
是 §8.3 的开篇加上 §8.3.1「分类变量与列联表」的全部内容。
节末的「练习」只有一道,本份收 1 道。 独立性检验的习题在下一小节 §8.3.2。
页码用的是印刷页码(page-0132 的页脚印着 127);全仓口径不一见 #534。
练习(第 127 页)第 1 题
- 成语 “名师出高徒” 可以解释为 “知名老师指导出高水平学生的概率较大”,即老师的名声与学生的水平之间有关联。你能举出更多的描述生活中两种属性或现象之间关联的成语吗?
这是一道开放题,答案不唯一。但只举出几个成语并不算答完—— 题干先示范了一遍”把成语翻译成关联陈述”(「名师出高徒」「知名老师指导出高水平学生的 概率较大」),所以合格的回答应当照着这个格式做: 每举一个成语,就说清它把哪两种属性放在了一起,断言的是什么样的关联。
下面按本节的语言把这件事做完整。
一、先把”成语在说什么”翻译成数学
任何一个描述关联的成语,都可以按 §8.3.1 的做法处理:定义一对取值于 的分类变量, 然后把成语翻译成一句关于条件概率的话。
以题干给的「名师出高徒」为例。取全体师生对为总体 ,对其中每一对:
成语断言的是
即知名老师带出高水平学生的概率,大于不知名老师带出高水平学生的概率。
三处要害,是这道题真正要考的:
- 成语说的是”概率较大”,不是”一定”。 「名师出高徒」不排除名师带出平庸学生, 也不排除无名之辈教出高徒。这正是关联(相关关系)与必然(函数关系)的区别, 与 §8.1.1 讲的是同一件事;
- 成语说的是关联,不必然是因果。 名师与高徒之间的关联,可能来自”名师教得好”(因果), 但也可能来自双向选择(好学生更容易被名师招收)或共同原因 (名校既能聘到名师,也能招到好学生)。数据只能显示关联,判断因果要另想办法;
- 要检验成语真不真,得收集数据做成 列联表,比较两行的比率—— 这正是本节的方法。
二、举例:断言”正关联”的
按这个格式,可以举出很多。下表里的 、 都取 或 , 表示”具有该属性”。
| 成语 | 表示 | 表示 | 断言 |
|---|---|---|---|
| 近朱者赤,近墨者黑 | 所处环境好 | 品行好 | |
| 虎父无犬子 | 父亲能力出众 | 子女能力出众 | 同上 |
| 熟能生巧 | 练习次数多 | 技艺纯熟 | 同上 |
| 玉不琢,不成器 | 受过雕琢磨炼 | 成材 | 同上 |
| 瑞雪兆丰年 | 冬季有大雪 | 来年收成好 | 同上 |
| 名师出高徒 | 师从名师 | 技艺出众 | 同上 |
| 勤能补拙 | 勤奋刻苦 | 学有所成 | 同上 |
表里有两句要多绕一步,因为它们字面上说的是”必然”而不是”概率较大”。
「玉不琢,不成器」 断的是必要条件——不琢就一定不成器, 即 。必要条件比关联强,而且蕴含关联,但要补一个前提: 只有当 (琢过的里面确有成器的)时, 才有 。
「虎父无犬子」 断的是充分条件——父亲出众则子女一定不平庸, 即 。它同样比关联强,同样要补一个前提: 只有当 (父亲不出众的家庭里确有子女不出众的)时, 才有 。
所以这两句可以收进表里,但必须标明它们与其余各句不在同一档: 「熟能生巧」「瑞雪兆丰年」「近朱者赤」断的是倾向(两个条件概率不等), 而这两句断的是必然(有一个条件概率取到端点 或 ), 关联只是它们在补上那个前提之后的一个推论。这一点正对着第一节的要害一—— 成语说”概率较大”才是本节的对象,说”一定”的那些,字面上已经超出了关联。
逐个说清”哪两种属性”,是这道题的答题重点。 比如「近朱者赤,近墨者黑」讲的是环境与品行的关联; 「瑞雪兆丰年」讲的是冬季降雪量与来年收成的关联,两者都是可以真去收集数据检验的。
「瑞雪兆丰年」还值得多说一句,因为它甚至说得出机理: 积雪保温、冻死虫卵、开春融化补充墒情。有机理支持的关联,比只有数据的关联更可能是因果。
有一句要小心:「物以类聚,人以群分」。 它说的不是「某个人」的两种属性,而是两个人之间的事, 所以硬要放进 列联表,总体的个体就不能是人,得是一对人: 表示这一对人交往密切, 表示这一对人品性相近, 断言仍是 。 先想清楚「个体是谁」,再想「哪两种属性」——个体选错了,表就填不出来。
三、举例:断言”负关联”的
关联不一定是正的。有些成语断言的是一种属性出现时另一种属性反而更少出现, 即 :
| 成语 | 表示 | 表示 | 断言 |
|---|---|---|---|
| 骄兵必败 | 轻敌骄傲 | 打胜仗 | |
| 欲速则不达 | 一味求快 | 达成目标 | 同上 |
| 满招损,谦受益 | 自满 | 有所得 | 同上 |
「骄兵必败」也要按上面那把尺子再看一遍。 它字面上断的是 (骄则必不胜),是必然而不是倾向; 只有当 (不骄的军队确有打胜的)时, 才由它得出 。 表里另外两句「欲速则不达」「满招损,谦受益」则是纯粹的倾向性断言,不必补前提。
负关联同样是关联。 这与 §8.1.1 里”正相关/负相关都属于相关关系”完全平行—— 判断有没有关联,看的是两行比率是否相等,而不是谁大谁小。
四、一类容易误收的:“否认必然”不等于”否认关联”
还有一批成语,乍看像是在说”两件事没关系”,其实不是。把它们收进来会答错, 所以单独辨一辨:
| 成语/俗语 | 它真正否认的是什么 |
|---|---|
| 小时了了,大未必佳 | 否认”幼时聪慧 成年必有成就”,即否认充分性 |
| 英雄不问出处 | 否认”出身低 必无才能”,即否认由出身断定才能 |
| 人不可貌相,海水不可斗量 | 否认由外貌断定能力 |
要害在于:它们否认的是”必然”,不是”关联”。 「大未必佳」只是说幼时聪慧的人里也有后来平庸的, 它从来没有断言 。 幼时聪慧的人完全可以仍然更可能成才,这跟”未必佳”一点也不矛盾。
回头看第一节的要害一:关联说的是比率不等,不是”一定”。 这三句正好是要害一的另一种说法——它们提醒的是”别把关联当必然”, 而不是”这两种属性无关”。所以按题目的要求(说明关联并写成条件概率), 它们该并到要害一那里当注脚,不能单列成”没有关联”的例子。
那真要举一个”断言没有关联”的成语呢? 几乎举不出来。原因不难想: 成语总结的是规律,而”两件事没关系”通常不构成值得流传的经验。 这恰恰说明了本节存在的理由——“有没有关联”这个问题, 语言本身给不出答案,只能靠列联表比较两行的比率、靠 检验来判(§8.3.2)。
顺便提醒:找”民间经验自相矛盾”的例子,也别把这一类拉来凑数。 「三岁看老」说幼时表现与成年成就有强关联,「小时了了,大未必佳」说幼时聪慧不是成年成就的充分条件—— 这两句可以同时成立,谈不上谁驳倒谁,也不需要用两行比率去判输赢。
真正方向相反、非用数据判不可的,得是这样一对:
| 俗语 | 表示 | 表示 | 断言 |
|---|---|---|---|
| 人多力量大 | 参与的人多 | 事情办成 | |
| 三个和尚没水喝 | 参与的人多 | 事情办成 |
写成这样两行,两句给出的不等号正好相反。
但”相反”这件事有一个必须先挣到的前提,不能跳过。 只有当两句说的是同一个总体 、同一对变量 时, 两个严格不等号才不可能同时成立,也才谈得上”其中必有一句不成立”。 而这两句成语在日常使用中说的并不是同一类事情—— 「人多力量大」多用于搬运、抢险这种可以分工、人手直接转化为产出的活, 「三个和尚没水喝」说的是责任可以互相推诿的重复性杂务。 分开看,两句完全可以同时为真;真把两类事混在一张表里, 正负两种效应还可能互相抵消,反倒显得人数与成事之间接近独立。
所以要用列联表判这一对,第一件事不是收数据,而是把总体限死: 先说清”哪一类事情”(比如”某单位承办的一批同类活动”),再定 与 , 此时两句才真正对立,数据才判得出输赢。
要挑这样一对并不容易,得逐字核对两句说的是不是同一对属性。 比如”常在河边走,哪有不湿鞋”与”老马识途”看起来像一对,其实不是: 前者的 是”出过差错”,说的是风险暴露久了终会出事; 后者的 是”认得路、能把事办妥”,说的是经验带来的能力。 虽然都可以写成”从事该活动的时间长”, 但 根本不是同一件事,两句可以同时成立,谈不上谁驳倒谁。
这里的次序不能颠倒:判两句成语打不打架,第一步永远是核对总体与变量对不对得上, 对不上就不构成一对矛盾,收再多数据也判不出输赢。 只有对得上(同一 、同一对 、不等号相反)的那种, 才轮到收集数据、做列联表、比较比率来定谁对谁错。 后一步正是本节开头那句话的意思—— “仅凭经验推断又有不足”,所以要借助数据说话。
五、把一个成语真正检验一遍(示范)
以「熟能生巧」为例,完整流程如下:
第一步:明确总体与两个分类变量。 取某项技能的全体学习者为 ,
” 小时”这条线必须事先定死。 分类变量的两类怎么划分,会直接影响结论, 不能看完数据再回头挑一个”好看”的分界点。
第二步:随机抽样,整理成 列联表。
| 合计 | |||
|---|---|---|---|
| 合计 |
第三步:横着比比率。 比较 与 , 并画等高堆积条形图。若后者明显大于前者,则样本数据支持「熟能生巧」。
第四步(下一小节的事):判断这个差异靠不靠得住。 由于是抽样,两个频率的差异有可能只是样本随机性造成的。 究竟多大的差异才不能用运气解释,要用 §8.3.2 的 独立性检验来回答。
最后仍要守住那条底线:即使检验通过,得到的也只是”练习时间与技能水平有关联”。 要说”多练导致技能提高”,还得排除反向因果(本来就有天赋的人更愿意多练) 和共同原因(兴趣浓的人既练得多、学得也快)——正是 §8.1.2 习题第 4 题给过的那套排查框架。
原书转写(OCR,供核对)
共 4 页· 默认折起
机器转写,如有出入以上方扫描图为准。它是原文可搜索、可复制公式、读屏器读得出的形态, 也是教材原文引文的逐字比对靶。
8.3 列联表与独立性检验
前面两节所讨论的变量,如人的身高、树的胸径、树的高度、短跑 世界纪录和创纪录的时间等,都是数值变量。数值变量的取值为实数,其大小和运算都有实际含义。
在现实生活中,人们经常需要回答一定范围内的两种现象或性质之间是否存在关联性或相互影响的问题。例如,就读不同学校是否对学生的成绩有影响,不同班级学生用于体育锻炼的时间是否有差别,吸烟是否会增加患肺癌的风险,等等。本节将要学习的独立性检验方法为我们提供了解决这类问题的方案。
在讨论上述问题时,为了表述方便,我们经常会使用一种特殊的随机变量,以区别不同的现象或性质,这类随机变量称为分类变量。分类变量的取值可以用实数表示,例如,学生所在的班级可以用1,2,3等表示,男性、女性可以用1,0表示,等等。在很多时候,这些数值只作为编号使用,并没有通常的大小和运算意义。本节我们主要讨论取值于 的分类变量的关联性问题。
8.3.1 分类变量与列联表
如何利用统计数据判断一对分类变量之间是否具有关联性呢?对于这样的统计问题,有时可以利用普查数据,通过比较相关的比率给出问题的准确回答,但在大多数情况下,需要借助概率的观点和方法。我们先看下面的具体问题。
问题 为了有针对性地提高学生体育锻炼的积极性,某中学需要了解性别因素是否对本校学生体育锻炼的经常性有影响,为此对学生是否经常锻炼的情况进行了普查。全校学生的普查数据如下:523名女生中有331名经常锻炼;601名男生中有473名经常锻炼。你能利用这些数据,说明该校女生和男生在体育锻炼的经常性方面是否存在差异吗?
这是一个简单的统计问题. 最直接的解答方法是, 比较经常锻炼的学生在女生和男生中的比率. 为了方便, 我们设
那么,只要求出 和 的值,通过比较这两个值的大小,就可以知道女生和男生在锻
炼的经常性方面是否有差异.由所给的数据,经计算得到
由
可知,男生经常锻炼的比率比女生高出 15.4 个百分点,所以该校的女生和男生在体育锻炼的经常性方面有差异,而且男生更经常锻炼.
上面的问题还可以通过建立一个古典概型,使用条件概率的语言,给出另外一种解答方法。用 表示该校全体学生构成的集合,这是我们所关心的对象的总体。考虑以 为样本空间的古典概型,并定义一对分类变量 和 如下:对于 中的每一名学生,分别令
我们希望通过比较条件概率 和 回答上面的问题。按照条件概率的直观解释,如果从该校女生和男生中各随机选取一名学生,那么该女生属于经常锻炼群体的概率是 ,而该男生属于经常锻炼群体的概率是 。因此,“性别对体育锻炼的经常性没有影响”可以描述为
而 “性别对体育锻炼的经常性有影响” 可以描述为
为了清楚起见,我们用表格整理数据,如表 8.3-1 所示.
我们用 表示事件 和 的积事件,用 表示事件 和 的积事件。根据古典概型和条件概率的计算公式,我们有
由 大于 可以作出判断,在该校的学生中,性别对体育锻炼的经常性有影响,即该校的女生和男生在体育锻炼的经常性方面存在差异,而且男生更经常锻炼.
在实践中,由于保存原始数据的成本较高,人们经常按研究问题的需要,将数据分类统计,并做成表格加以保存。我们将如表8.3-1这种形式的数据统计表称为 列联表(contingency table)。 列联表给出了成对分类变量数据的交叉分类频数。以表8.3-1为例,它包含了 和 的如下信息:最后一行的前两个数分别是事件 和 中样本点的个数;最后一列的前两个数分别是事件 和 中样本点的个数;中间的四个格中的数是表格的核心部分,给出了事件 ()中样本点
的个数;右下角格中的数是样本空间中样本点的总数.
在上面问题的两种解答中,使用了学校全部学生的调查数据,利用这些数据能够完全确定解答问题所需的比率和条件概率。然而,对于大多数实际问题,我们无法获得所关心的全部对象的数据,因此无法准确计算出有关的比率或条件概率。在这种情况下,上述古典概型和条件概率的观点为我们提供了一个解决问题的思路。比较简单的做法是利用随机抽样获得一定数量的样本数据,再利用随机事件发生的频率稳定于概率的原理对问题答案作出推断。
将所关心的对象的全体看成古典概型的样本空间,就可以用概率的语言刻画相关的问题,进而用频率稳定于概率的原理推断问题的答案。很多统计方法都是基于这种思想建立起来的。
例 1 为比较甲、乙两所学校学生的数学水平,采用简单随机抽样的方法抽取 88 名学生。通过测验得到了如下数据:甲校 43 名学生中有 10 名数学成绩优秀;乙校 45 名学生中有 7 名数学成绩优秀。试分析两校学生中数学成绩优秀率之间是否存在差异。
解:用 表示两所学校的全体学生构成的集合。考虑以 为样本空间的古典概型。对于 中每一名学生,定义分类变量 和 如下:
我们将所给数据整理成表 8.3-2.
表8.3-2是关于分类变量 和 的抽样数据的 列联表:最后一行的前两个数分别是事件 和 的频数;最后一列的前两个数分别是事件 和 的频数;中间的四个格中的数是事件 的频数;右下角格中的数是样本容量。因此,甲校学生中数学成绩不优秀和数学成绩优秀的频率分别为
乙校学生中数学成绩不优秀和数学成绩优秀的频率分别为
我们可以用等高堆积条形图直观地展示上述计算结果,如图8.3-1所示.
• •
利用统计软件画条形图,Excel 软件可以通过插入图表,从图表类型中选取条形图;R 软件可以用函数 barplot.
在图8.3-1中,左边的蓝色和红色条的高度分别是甲校学生中数学成绩不优秀和数学成绩优秀的频率;右边的蓝色和红色条的高度分别是乙校学生中数学成绩不优秀和数学成绩优秀的频率。通过比较发现,两个学校学生抽样数据中数学成绩优秀的频率存在差异,甲校的频率明显高于乙校的频率。依据频率稳定于概率的原理,我们可以推断 。也就是说,如果从甲校和乙校各随机选取一名学生,那么甲校学生数学成绩优秀的概率大于乙校学生数学成绩优秀的概率。因此,可以认为两校学生的数学成绩优秀率存在差异,甲校学生的数学成绩优秀率比乙校学生的高。
思考
你认为“两校学生的数学成绩优秀率存在差异”这一结论是否有可能是错误的?
事实上,“两校学生的数学成绩优秀率存在差异”这个结论是根据两个频率间存在差异推断出来的。有可能出现这种情况:在随机抽取的这个样本中,两个频率间确实存在差异,但两校学生的数学成绩优秀率实际上是没有差别的。这就是说,样本的随机性导致了两个频率间出现较大差异。在这种情况下,我们推断出的结论就是错误的。后面我们将讨论犯这种错误的概率大小问题。
练习
- 成语 “名师出高徒” 可以解释为 “知名老师指导出高水平学生的概率较大”,即老师的名声与学生的水平之间有关联。你能举出更多的描述生活中两种属性或现象之间关联的成语吗?